深度学习与神经网络1
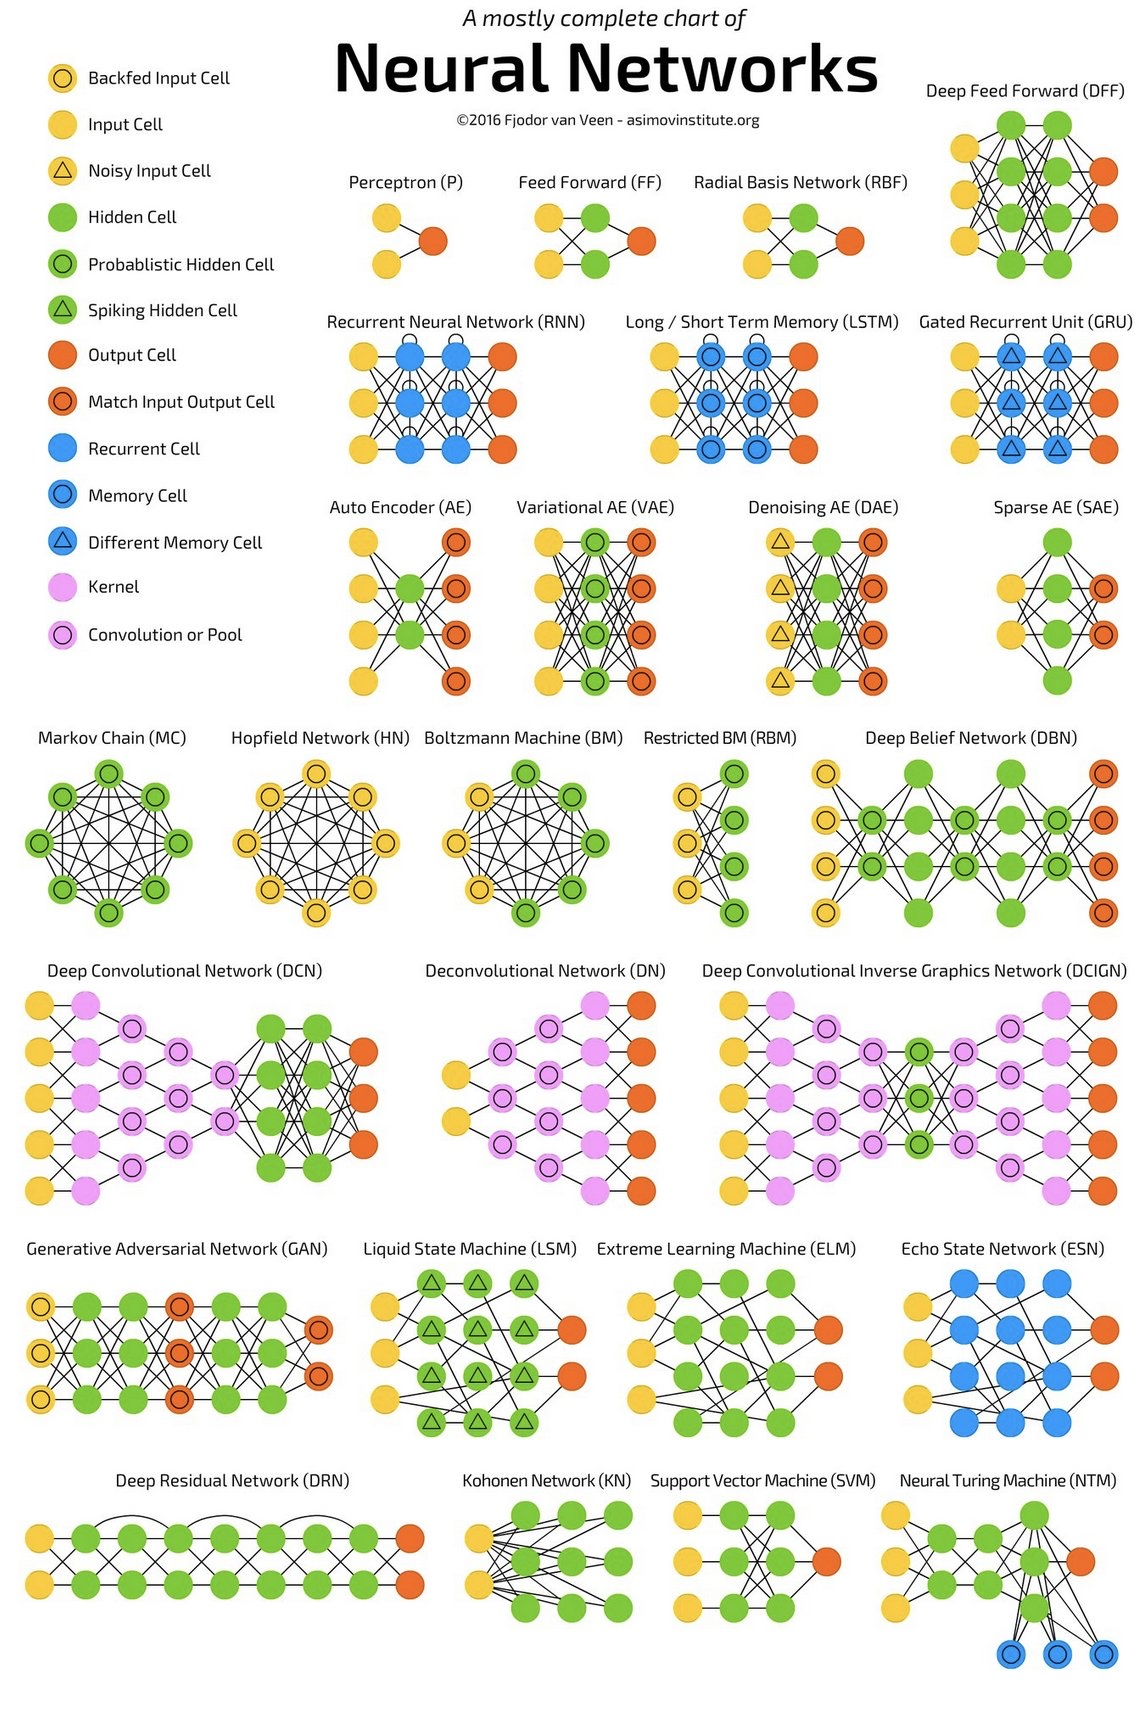
关于这张图
Fjodor van Veen 2016 年在 Asimov Institute 发布的 A mostly complete chart of Neural Networks(常被叫作 Neural Network Zoo),用「单元类型 + 连接方式」画了 27 种网络。
看图时注意两点:
- 它停在 2016 年,当时已有的家族也没收全。Transformer、Mamba、CLIP 是后来才出现的;GNN(2009)、MoE(1991)、扩散模型(2015)当时已经有了,只是后来才成为主流,图上同样没有
- 马尔可夫链(MC)和支持向量机(SVM)严格说不算神经网络,作者放进来是为了对照
本笔记把图里的 27 种和图外的架构合在一起,按家族重新排列。
怎么读这篇
结构
| 部分 | 内容 |
|---|---|
| 第一部分 | 从单个神经元到一个能训练的网络:激活、损失、反向传播、优化器、训练循环、训练工程 |
| 第二部分 | 15 个网络家族,图内图外一起讲 |
| 第三部分 | 组合与范式:预训练与微调、真实系统怎么拼、怎么读一篇论文的架构 |
| 第四部分 | 按数据结构选网络的总表,以及几张横向对比表 |
| 第五部分 | 时间线 |
| 附录 | 全部网络一览表 |
排序规则:同一级内按热度从高到低排。热度指 2024–2026 年在研究和工程里的使用与讨论程度,属于我的判断。家族之间、家族内部都按这条规则。有前后依赖的(比如 LSTM 要先懂 RNN 的递推),公共机制放在家族开头的「x.0」小节先讲,这样家族里可以直接从最热的那个讲起。第一部分是一条从神经元到训练的流水线,各小节按依赖顺序排;小节内部的并列选项(几种激活函数、几种优化器)仍按热度排。
每个网络的固定格式
- 架构图(每个小节开头,统一画法,图例见图例:单元类型)
- 一句话
- 原理与公式
- PyTorch 代码
- 典型例子
- 优势 / 局限
- 适合的数据
代码约定
- 全部 88 段代码都在 CPU 上实测跑通(torch 2.14、torchvision 0.29),多数几秒钟,最慢的一段四十秒左右。结果插图由单独的绘图脚本生成,和正文代码是同一个实验,但样本数、随机种子或展示用的输入可能不同(比如 Hopfield 那张图用字母图案,正文代码用随机模式),图和代码输出不一定一一对应。这些代码对比的是同一实验里的不同配置,宽度、学习率、训练步数没有逐项对齐,不能当作基准测试。小节开头的架构图是示意图,图里标「实测」的数字来自代码输出。正文里「另外换 N 个随机种子」的结果来自单独的重复运行,脚本和日志没有附在笔记里;引用论文的数字按正文给出的作者、年份或论文名查原文
- 每段代码自带 import,可以单独复制运行
- 注释里写张量形状:B = batch,T = 序列长度,C = 通道数,H / W = 高 / 宽,D = 特征维度,N = 节点数或点数
- 代码里的训练数据都是现场合成的小数据,目的是几秒内看到现象。换成真实任务时,模型的主体结构可以沿用,但数据接口、网络尺寸、预处理、输出分布和评估方法都要跟着改,有些类里写死了图像大小、块数、通道数
- 示例按 CPU 写。换成 CUDA 或 Mac 的
"mps"时,模型、输入和函数内部新建的张量(位置编码、掩码、初始状态、采样噪声)都要放到同一个设备上,转 NumPy 前要移回 CPU,有些算子在 MPS 上还不支持
实测与常见说法有出入的地方
代码跑出来的结果,有些和教材、论文里的常见说法不完全一致。这些都是小数据、小模型上的玩具实验,能说明一个说法在什么条件下成立、什么条件下不成立,不足以推翻论文结论;常见说法本身多数也只说「容易出现」,没说「每次都出现」。这些地方在对应小节用「常见说法与实测」单独列出,写明常见说法、实测数字和怎么理解(第二部分的「家族」也只是学习索引,注意力、生成目标、自监督、融合这些分法并不互斥):
| 小节 | 常见说法 | 实测 |
|---|---|---|
| 2.2.2 | Flow Matching 走直线,一步就能生成 | 本例(噪声和数据随机配对、没做 reflow)1 步时样本全挤在数据均值(圆心)附近,5 步时才大多回到圆环上 |
| 2.2.4 | GAN 容易模式塌缩 | 本例两边学习率平衡时 8 个团的扇区都有样本;把判别器学习率调低后出现塌缩 |
| 2.6.3 | BYOL 靠预测头、停止梯度、EMA 防塌缩 | 本例三样都去掉、只保留 BatchNorm 也没塌缩;BatchNorm 也去掉才塌缩 |
| 2.6.5 | 加 L1 就能得到稀疏、可解释的特征 | 不约束解码器的列范数时,40 个真实特征只找回 1 个 |
| 2.8.5 | 梯度调制能缓解模态不平衡 | 玩具例子里只补回一部分(0.84 → 0.89,单独训练是 0.94) |
| 2.9.1 | GAT 比 GCN 更好 | 这张社区图上 GCN 0.86、GAT 0.77,换 5 个种子平均 0.85 对 0.78 |
| 2.10.1 | MC Dropout 离数据越远越不确定 | 本例外推处 MC Dropout 的标准差反而最小,深度集成的随距离变大 |
| 2.10.2 | 一对多问题用回归会落在几个解之间 | 解对称时成立;Bishop 的反问题里回归落在某个解旁边 |
| 2.11.2 | 长轨迹一次积分很难训练 | 本例只是平台期长:训练 300 步卡住,1000 步就拟合好了 |
| 2.12.1 | Hopfield 容量约 0.138N | 要求一位不差地回忆时约 N/(2 ln N)(渐近公式),N = 100 时约 11 个 |
| 2.12.5 | 逐层预训练对少标签有帮助 | 平均有帮助,但 20 个标签的单次比较可能得出相反结论 |
| 2.14.1 | ESN 只训练读出层,简单稳定 | 单步预测都好,自由生成对超参极其敏感 |
| 3.2.2 | 回归会把多峰演示平均掉 | 只在「同一观测对应多种答案」的状态上明显 |
图例:单元类型
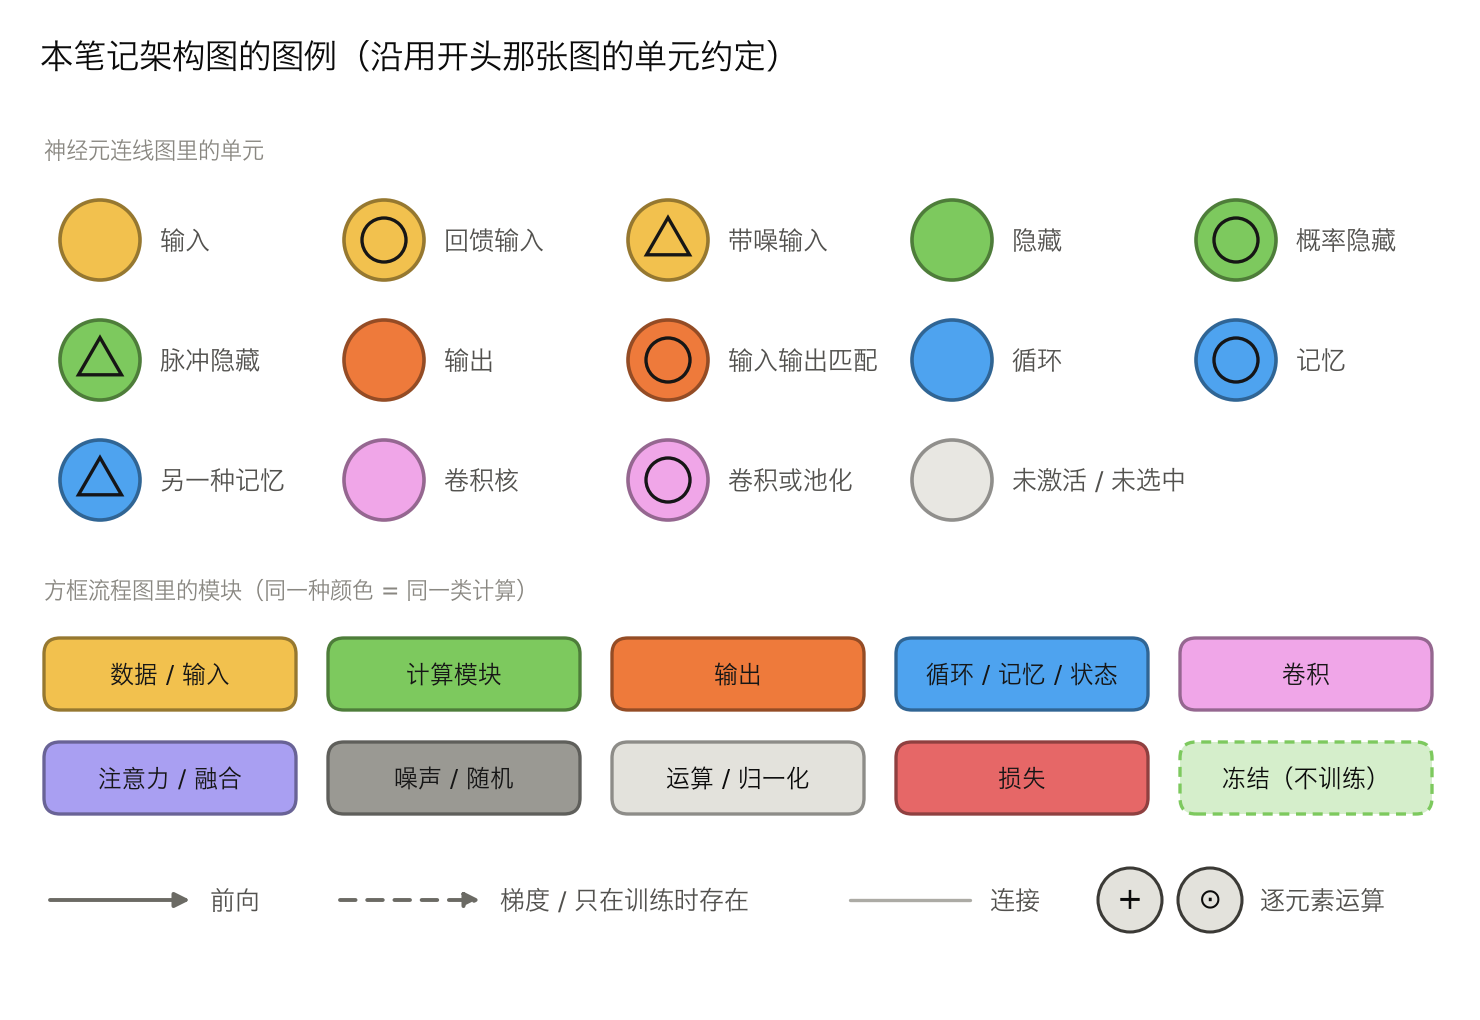
每个小节开头的架构图都按这套约定画:神经元连线图里的单元类型和开头那张图一致;方框流程图用同一套颜色区分模块(数据黄、计算绿、输出橙、循环蓝、卷积粉、注意力紫、损失红,噪声和运算是两种灰),实线箭头是前向,虚线箭头是梯度或只在训练时存在的连接;填色变淡、边框为虚线的模块是冻结不训练的部分,不填色的虚线框只是把一组模块圈在一起(比如「× N 层」)。下表是开头那张图的单元说明:
| 图例 | 中文 | 含义 | 图中哪些网络用到 |
|---|---|---|---|
| Input Cell | 输入单元 | 接收原始数据 | 几乎所有 |
| Backfed Input Cell | 回馈输入单元 | 输入单元同时被网络回写,同一组单元既当输入又当输出 | HN、BM、RBM、DBN、GAN |
| Noisy Input Cell | 带噪输入单元 | 输入先被加噪或遮挡 | DAE |
| Hidden Cell | 隐藏单元 | 加权求和 + 激活函数,最普通的神经元 | 大部分 |
| Probabilistic Hidden Cell | 概率隐藏单元 | 输出是一次随机采样或一个分布的参数 | MC、BM、RBM、DBN、VAE、DCIGN |
| Spiking Hidden Cell | 脉冲隐藏单元 | 膜电位累积到阈值才发放一个脉冲 | LSM |
| Output Cell | 输出单元 | 网络的输出 | 大部分 |
| Match Input Output Cell | 输入输出匹配单元 | 输出和输入在同一个空间:AE、VAE、DAE、SAE 有逐样本重建输入的目标;DBN 的可见层和输入同维,用来学数据分布、生成同类数据;GAN 是生成器的输出要像真实数据(匹配分布,不复现某个具体样本) | AE、VAE、DAE、SAE、DBN、GAN |
| Recurrent Cell | 循环单元 | 带自连接,保留上一时刻的状态 | RNN、ESN |
| Memory Cell | 记忆单元 | 带门控的记忆状态 | LSTM、NTM |
| Different Memory Cell | 另一种记忆单元 | 门控结构不同的记忆单元 | GRU |
| Kernel | 卷积核 | 只连一小块邻域,权重在空间上共享 | DCN、DN、DCIGN |
| Convolution or Pool | 卷积或池化 | 卷积层或池化层的输出 | DCN、DN、DCIGN |
图中 27 种网络在本笔记的位置
按图中从左到右、从上到下的顺序:
| 图中缩写 | 名称 | 本笔记位置 |
|---|---|---|
| P | 感知机 Perceptron | 2.4.2 |
| FF | 前馈网络 Feed Forward | 2.4.3 |
| RBF | 径向基函数网络 | 2.4.5 |
| DFF | 深度前馈网络(MLP) | 2.4.1 |
| RNN | 循环神经网络 | 2.5.4 |
| LSTM | 长短期记忆网络 | 2.5.1 |
| GRU | 门控循环单元 | 2.5.2 |
| AE | 自编码器 | 2.6.4 |
| VAE | 变分自编码器 | 2.2.3 |
| DAE | 去噪自编码器 | 2.6.6 |
| SAE | 稀疏自编码器 | 2.6.5 |
| MC | 马尔可夫链 | 2.12.2 |
| HN | Hopfield 网络 | 2.12.1 |
| BM | 玻尔兹曼机 | 2.12.4 |
| RBM | 受限玻尔兹曼机 | 2.12.3 |
| DBN | 深度信念网络 | 2.12.5 |
| DCN | 深度卷积网络(CNN) | 2.3.1 |
| DN | 反卷积网络(转置卷积) | 2.3.6 |
| DCIGN | 深度卷积逆图形网络 | 2.2.7 |
| GAN | 生成对抗网络 | 2.2.4 |
| LSM | 液态机 | 2.14.3 |
| ELM | 极限学习机 | 2.14.2 |
| ESN | 回声状态网络 | 2.14.1 |
| DRN | 深度残差网络(ResNet) | 2.3.2 |
| KN | Kohonen 网络(自组织映射) | 2.15.2 |
| SVM | 支持向量机 | 2.15.1 |
| NTM | 神经图灵机 | 2.15.3 |
第二部分 网络家族
家族按热度排:
| 序号 | 家族 | 成员(按热度) |
|---|---|---|
| 2.1 | 注意力与 Transformer | Transformer、GPT 与大语言模型、ViT、Seq2Seq |
| 2.2 | 生成模型 | 扩散模型、Flow Matching、VAE、GAN、VQ-VAE、标准化流、DCIGN |
| 2.3 | 卷积网络 | CNN、ResNet、U-Net、目标检测与分割、TCN、转置卷积网络 |
| 2.4 | 前馈网络 | MLP、感知机、单隐层前馈网络、KAN、RBF 网络 |
| 2.5 | 循环与序列模型 | LSTM、GRU、SSM 与 Mamba、普通 RNN |
| 2.6 | 自监督与表示学习 | 对比学习、MAE、自蒸馏与 JEPA、自编码器、稀疏自编码器、去噪自编码器 |
| 2.7 | 混合专家 | MoE、MoT |
| 2.8 | 条件化与多模态融合 | 交叉与联合注意力、FiLM、门控、超网络、模态不平衡 |
| 2.9 | 图与集合 | GNN、PointNet 与 DeepSets |
| 2.10 | 不确定性与多峰输出 | 深度集成与 MC Dropout、MDN |
| 2.11 | 连续与隐式表示 | NeRF 与隐式神经表示、Neural ODE |
| 2.12 | 能量模型与联想记忆 | Hopfield、马尔可夫链、RBM、玻尔兹曼机、DBN |
| 2.13 | 脉冲神经网络 | SNN |
| 2.14 | 储备池与随机网络 | ESN、ELM、LSM |
| 2.15 | 其他经典网络 | SVM、SOM、NTM、胶囊网络 |
标题后面的〔图:XX〕表示这个网络在开头那张图里,XX 是图中的缩写。
附录 全部网络一览
| 网络 | 家族 | 代表性年份 | 一句话 | 适合的数据 | 位置 |
|---|---|---|---|---|---|
| Transformer | 注意力 | 2017 | 注意力 + 逐 token FFN,训练完全并行 | 各种 token 序列 | 2.1.1 |
| GPT / 大语言模型 | 注意力 | 2018 | Decoder-only,预测下一个 token | 文本、代码、离散化的任何序列 | 2.1.2 |
| ViT | 注意力 | 2020 | 图像切块当 token | 图像(大数据或有预训练) | 2.1.3 |
| Seq2Seq + 注意力 | 注意力 | 2014 | 编码器-解码器 RNN,解码时回看输入 | 序列到序列 | 2.1.4 |
| 扩散模型 | 生成 | 2015 / 2020 | 学去噪,从噪声迭代生成 | 连续高维多峰数据 | 2.2.1 |
| Flow Matching | 生成 | 2022 | 学从噪声到数据的速度场(常用直线路径) | 同上,推理通常更快 | 2.2.2 |
| VAE | 生成 | 2013 | 编码成分布 + KL 正则,隐空间可采样 | 图像、分子、轨迹 | 2.2.3 |
| GAN | 生成 | 2014 | 生成器与判别器对抗 | 图像、图像翻译 | 2.2.4 |
| VQ-VAE | 生成 | 2017 | 连续信号量化成离散 token | 图像、音频、动作的 tokenizer | 2.2.5 |
| 标准化流 | 生成 | 2014–2018 | 可逆变换,精确似然 | 中低维连续数据 | 2.2.6 |
| DCIGN | 生成 | 2015 | 卷积 VAE,隐变量对应图形学参数 | 有已知生成因素的图像 | 2.2.7 |
| CNN | 卷积 | 1989(LeCun) | 局部连接 + 权重共享 | 网格数据 | 2.3.1 |
| ResNet | 卷积 | 2015 | 残差跳线,训练上百层 | 图像;跳线用于一切深网络 | 2.3.2 |
| U-Net | 卷积 | 2015 | 编码-解码 + 同尺度跳线 | 稠密预测、扩散去噪 | 2.3.3 |
| YOLO / Mask R-CNN | 卷积 | 2016 / 2017 | 检测框和实例掩码 | 多物体图像 | 2.3.4 |
| TCN / WaveNet | 卷积 | 2018 / 2016 | 因果膨胀卷积 | 时间序列、音频 | 2.3.5 |
| 转置卷积网络 | 卷积 | 2010 | 逐层上采样生成网格输出 | 图像生成、分割掩码 | 2.3.6 |
| MLP | 前馈 | 1986(反向传播) | 全连接层堆叠 | 表格、低维状态、各种头 | 2.4.1 |
| 感知机 | 前馈 | 1958 | 单个神经元 + 阶跃,线性边界 | 线性可分特征 | 2.4.2 |
| 单隐层前馈网络 | 前馈 | 1986 | 一层隐藏层即可解 XOR | 低维小数据 | 2.4.3 |
| KAN | 前馈 | 2024 | 边上是可学习的一元函数 | 低维科学函数 | 2.4.4 |
| RBF 网络 | 前馈 | 1988 | 局部高斯响应的加权和 | 低维插值与控制 | 2.4.5 |
| LSTM | 循环 | 1997 | 细胞状态 + 三个门 | 中长时间序列 | 2.5.1 |
| GRU | 循环 | 2014 | 两个门的简化 LSTM | 实时、资源受限的序列 | 2.5.2 |
| SSM / Mamba | 循环 | 2021(S4)/ 2023 | 线性状态空间,训练并行、推理递推 | 超长序列 | 2.5.3 |
| 普通 RNN | 循环 | 1990(Elman) | 隐状态递推 | 短序列 | 2.5.4 |
| 对比学习 / CLIP | 表示学习 | 2020 / 2021 | 正样本靠近、负样本推远 | 成对、多视角数据 | 2.6.1 |
| MAE | 表示学习 | 2021 | 遮住 75% 再补回来 | 图像、视频、点云 | 2.6.2 |
| BYOL / DINO / JEPA | 表示学习 | 2020–2023 | 学生预测 EMA 老师的表征 | 无标注图像、视频 | 2.6.3 |
| 自编码器 | 表示学习 | 1986 / 2006 | 压缩再还原 | 降维、异常检测 | 2.6.4 |
| 稀疏自编码器 | 表示学习 | 2000s | 过完备 + 稀疏激活 | 叠加特征、模型可解释性 | 2.6.5 |
| 去噪自编码器 | 表示学习 | 2008 | 从腐蚀的输入还原干净输入 | 带噪信号 | 2.6.6 |
| MoE | 混合专家 | 1991 / 2017 | 路由到 top-k 个专家 FFN | 超大规模多样数据 | 2.7.1 |
| MoT | 混合专家 | 2024 | 按模态分参数,共享注意力 | 异构多模态序列 | 2.7.2 |
| 交叉 / 联合注意力 | 条件化 | 2014 / 2017 | 按内容检索条件 | 结构化的条件 token | 2.8.1 |
| FiLM | 条件化 | 2018 | 条件生成逐通道的缩放和平移 | 全局条件向量 | 2.8.2 |
| 门控融合 | 条件化 | — | 任务状态决定每个模态的开度 | 有用性随阶段变化的模态 | 2.8.3 |
| 超网络 | 条件化 | 2016 | 一个网络生成另一个网络的权重 | 多任务、多条件 | 2.8.4 |
| 梯度调制 | 条件化 | 2022 | 训练时压低占优模态的梯度 | 难易不均的多模态 | 2.8.5 |
| GNN(GCN、GAT) | 图与集合 | 2017 / 2018 | 节点反复聚合邻居 | 图 | 2.9.1 |
| PointNet / DeepSets | 图与集合 | 2017 | 逐元素共享 + 对称池化 | 点云、集合 | 2.9.2 |
| 深度集成 / MC Dropout | 不确定性 | 2017 / 2016 | 用多个模型或多次前向的分歧估计不确定度 | 安全攸关、数据稀疏 | 2.10.1 |
| MDN | 不确定性 | 1994 | 输出高斯混合分布 | 一对多映射 | 2.10.2 |
| NeRF / INR | 连续表示 | 2020 | MLP 表示坐标上的连续信号 | 三维场景、连续场 | 2.11.1 |
| Neural ODE | 连续表示 | 2018 | 网络定义导数,积分得输出 | 连续时间动力学 | 2.11.2 |
| Hopfield 网络 | 能量模型 | 1982 | 能量谷底存储记忆 | 二值模式补全 | 2.12.1 |
| 马尔可夫链 | 能量模型 | 1906 | 下一状态只看当前状态 | 离散状态序列 | 2.12.2 |
| RBM | 能量模型 | 1986 / 2002 | 二分结构的玻尔兹曼机 + CD | 二值数据、协同过滤 | 2.12.3 |
| 玻尔兹曼机 | 能量模型 | 1985 | 随机的 Hopfield 网络 | 小规模二值分布 | 2.12.4 |
| DBN | 能量模型 | 2006 | 堆叠 RBM 逐层预训练 | 无标签多、标签少 | 2.12.5 |
| SNN | 脉冲 | 1990s / 2019 | 积分发放 + 替代梯度 | 事件流 | 2.13.1 |
| ESN | 储备池 | 2001 | 随机循环储备池 + 线性读出 | 低维时间序列 | 2.14.1 |
| ELM | 储备池 | 2004 | 随机隐藏层 + 最小二乘输出 | 中小规模特征向量 | 2.14.2 |
| LSM | 储备池 | 2002 | 脉冲储备池 + 线性读出 | 脉冲序列 | 2.14.3 |
| SVM | 经典 | 1992 / 1995 | 最大间隔 + 核技巧 | 中小规模特征 | 2.15.1 |
| SOM | 经典 | 1982 | 网格神经元竞争、拓扑保持 | 聚类与可视化 | 2.15.2 |
| NTM | 经典 | 2014 | 控制器 + 可微读写的外部记忆 | 算法类序列任务 | 2.15.3 |
| 胶囊网络 | 经典 | 2017 | 向量胶囊 + 动态路由 | 部件关系重要的小图像 | 2.15.4 |