2.1 注意力与 Transformer

2.1.0 注意力机制(家族公共部分)
<center>2.1.0 注意力
2.1.0 注意力
<center>2.1.0 注意力
2.1.0 注意力

一句话

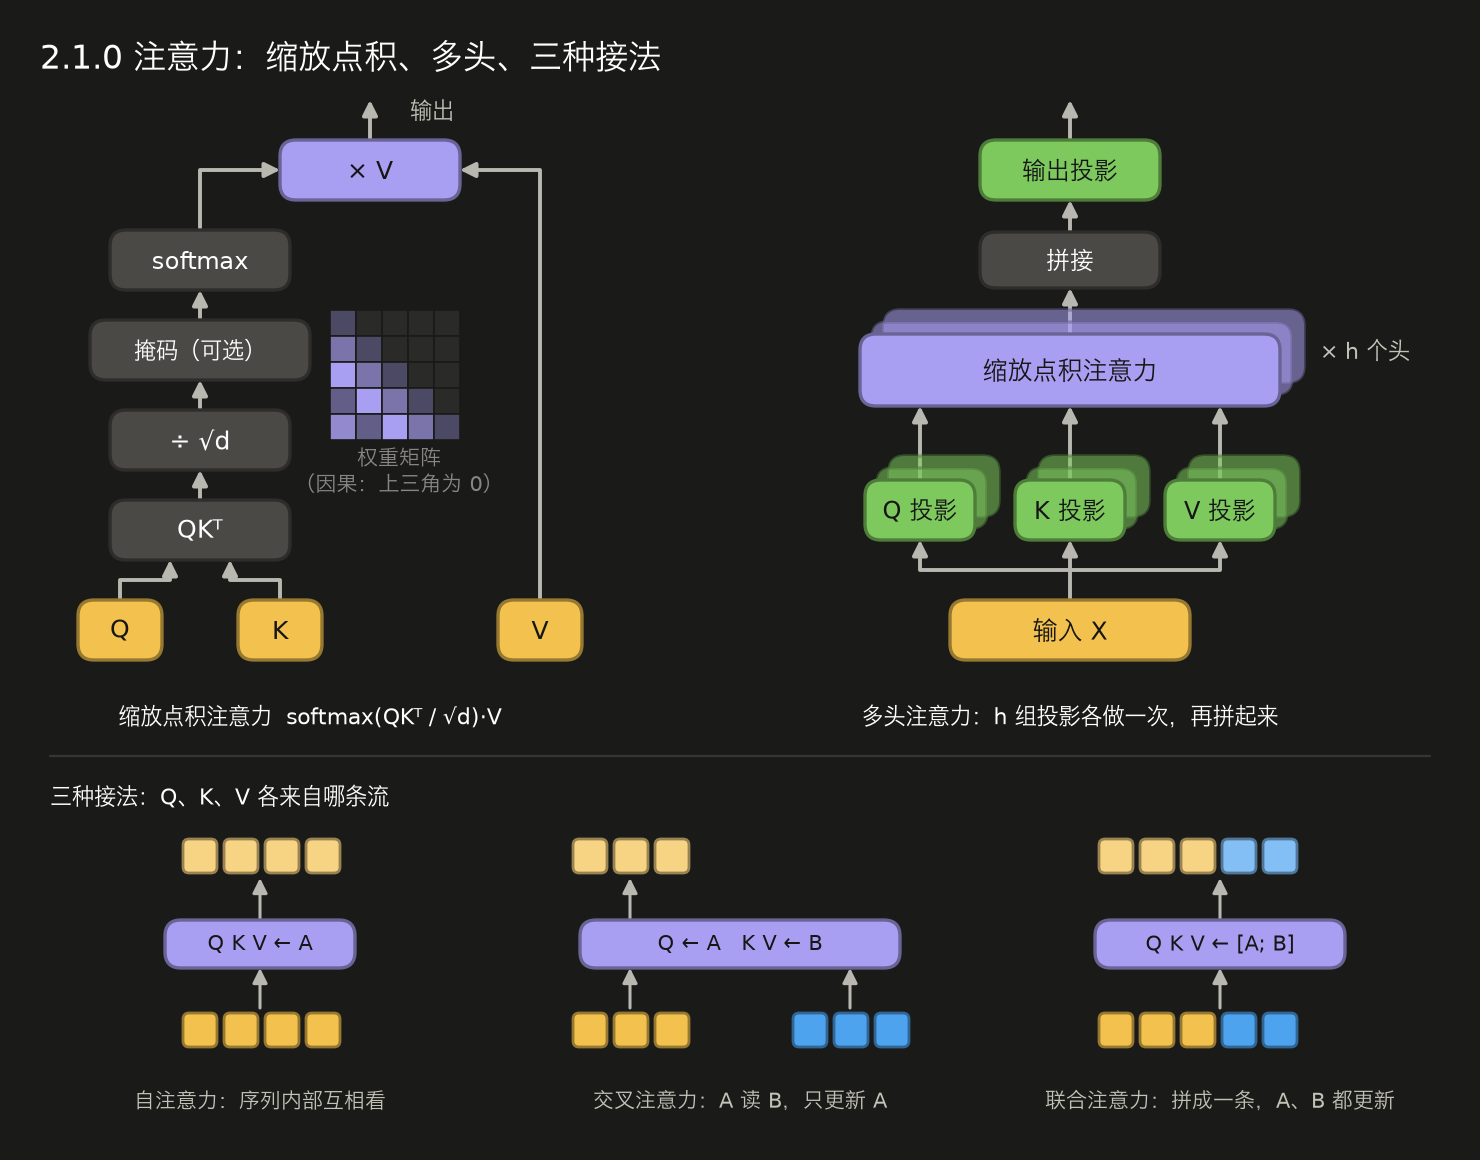
注意力 = 软检索:用一个查询(Query)和一组键(Key)算相似度,按相似度对对应的值(Value)加权求和。

三个角色

角色 比喻 作用
Query(Q) 我要查什么 发起检索的一方
Key(K) 我能被什么查到 和 Q 算相似度,决定「看谁、看多少」
Value(V) 我携带的内容 按权重被取出来

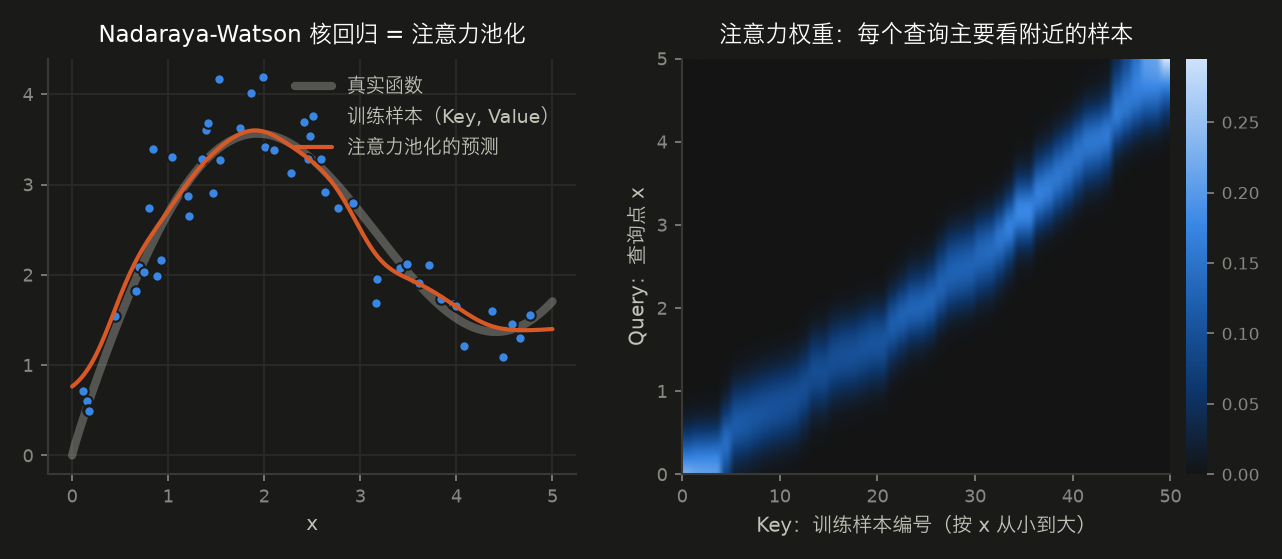
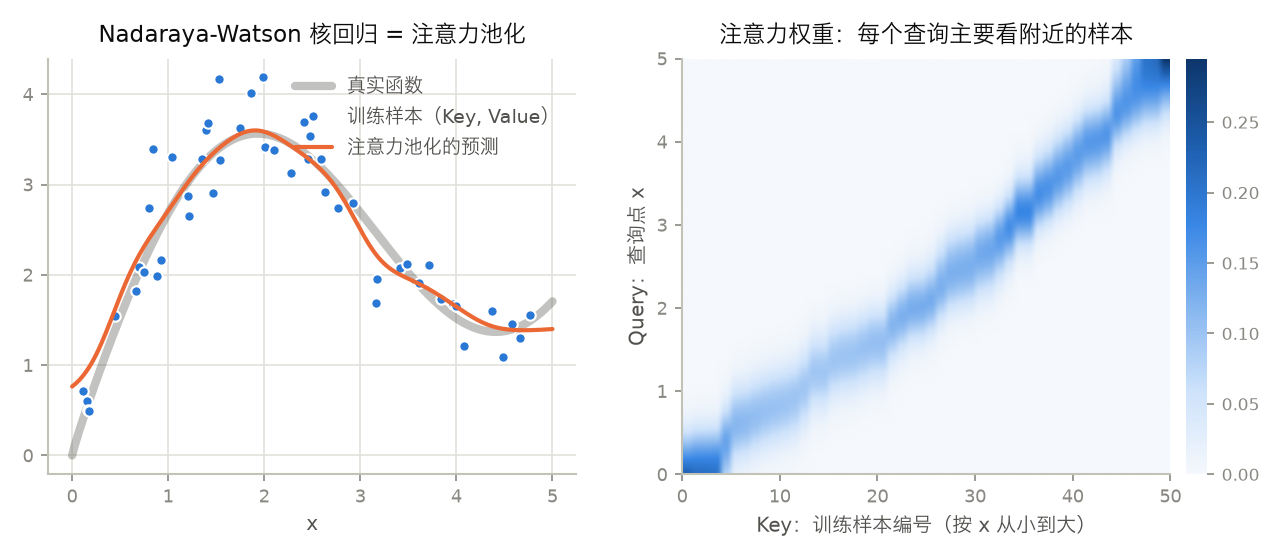
最早的形态:注意力池化。1964 年的 Nadaraya-Watson 核回归就是注意力:要预测查询点 x 的值,把所有训练样本的 y_i 加权平均,权重由 x 和 x_i 有多近决定:

这里 x 是 Query,x_i 是 Key,y_i 是 Value,打分函数是固定的高斯核,σ 是核的宽度(越小越只看附近的点)。现代注意力把打分函数换成可学习的。
<center>注意力池化
注意力池化
<center>注意力池化
注意力池化

两种打分函数

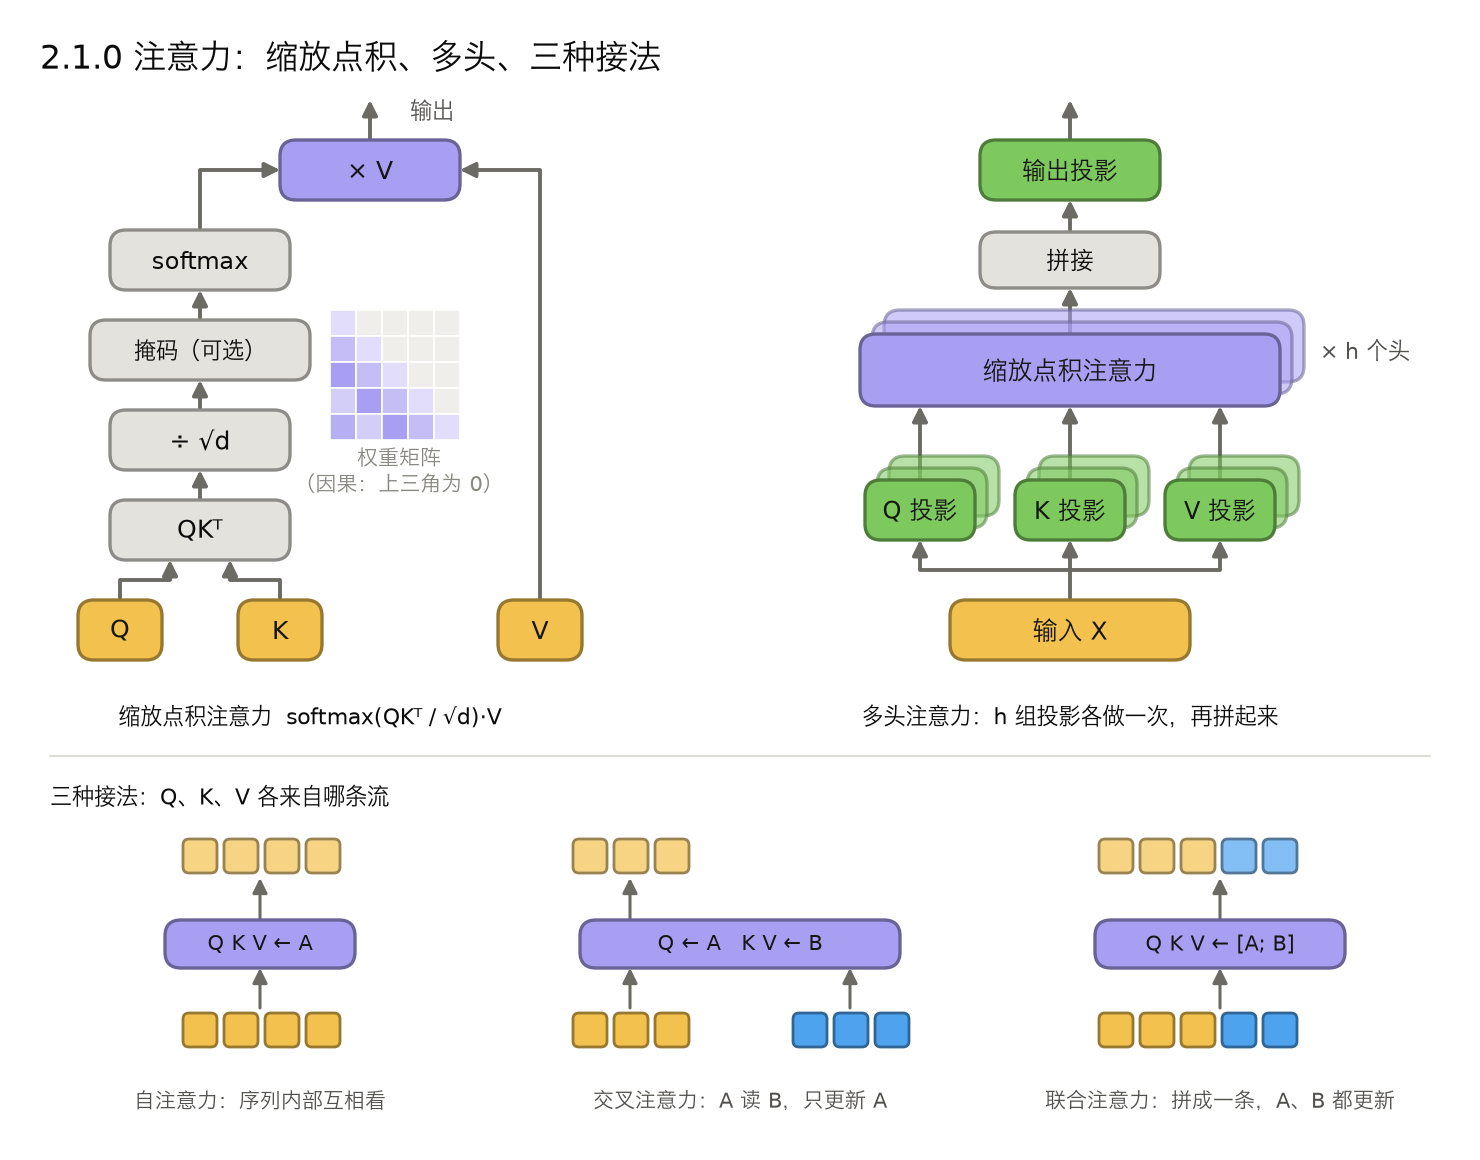
加性打分允许 q、k 维度不同;缩放点积全是矩阵乘,快,是现在的标准。除以 √d 的原因:假设 q、k 各分量相互独立、均值为 0、方差为 1,点积的方差就是 d。d 大了 softmax 的输入会很极端,输出接近 one-hot,梯度几乎为 0;除以 √d 把方差拉回 1。

矩阵形式(一次算整条序列):

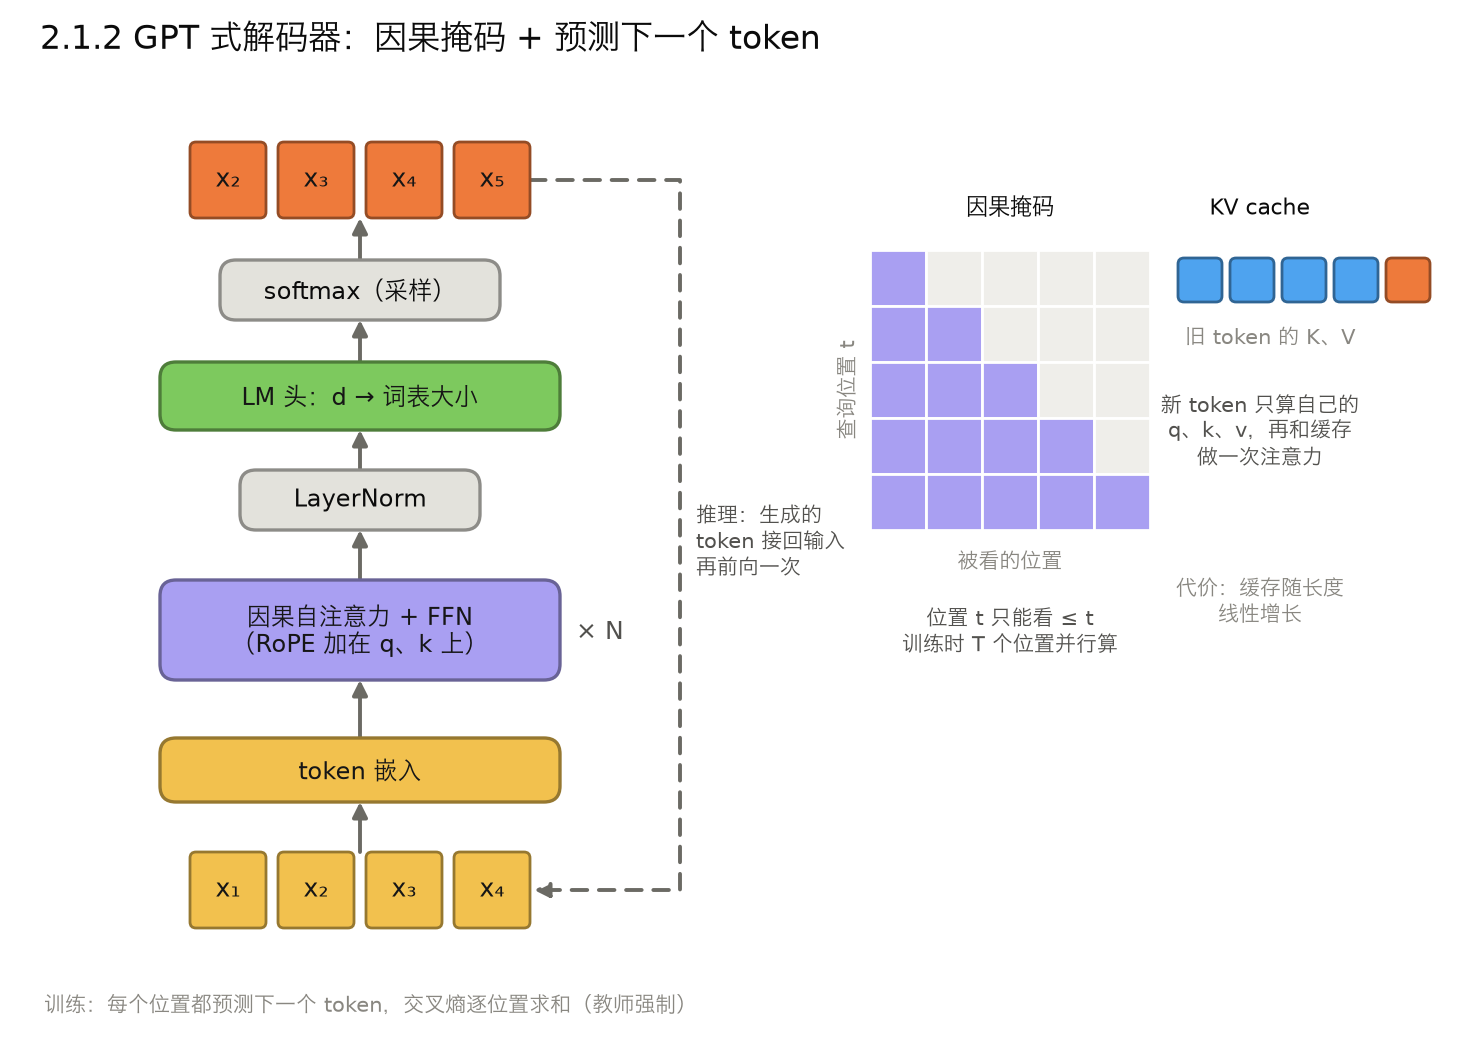
掩码:在 softmax 前把不允许看的位置设成 −∞,权重就变成 0。两种常见掩码:padding 掩码(不看补齐的空位)、因果掩码(位置 t 只能看 ≤ t 的位置,用于自回归生成)。

多头注意力:把 d 维拆成 h 个头,每个头用自己的投影在 d/h 维的子空间里独立做注意力,再拼起来过一个输出投影。不同的头可以关注不同的关系(有的看相邻词,有的看指代对象)。

三种接法:Q、K、V 各来自哪条流

接法 Q 来自 K、V 来自 谁被更新 方向 代表
自注意力 self 序列 A 序列 A A 序列内部 Transformer 每一层
交叉注意力 cross 序列 A 序列 B 只有 A 单向:A 读 B 原版 Transformer 解码器读编码器、Stable Diffusion 的图像读文本、多数 VLA 的动作读观测
联合注意力 joint / shared A、B 拼成一条 同左 A 和 B 都更新;各自能读到哪些 token 由掩码决定 不加掩码时双向;加块状掩码可以只让一方读另一方 SD3 的 MMDiT(双向)、π0(块因果掩码:动作读观测,观测不读动作)、MoT 类多模态模型(各模态可以用各自的投影矩阵,见 2.7.2)

用法上的差别:交叉注意力把「A 读 B」这条通路写死在结构里,每个 A 的 token 都会去 B 里检索;通路一定存在,但这一路对最终输出贡献多大,还要看训练结果。联合注意力里所有 token 在同一个 softmax 里竞争权重,如果 B 只有几个 token、A 有几百个,B 分到的权重往往很少,这是学出来的结果,结构上没有任何保证。多模态里「触觉 token 很少、视觉 token 很多」时要注意这一点(见 2.8)。交叉注意力也只保证 A 会去读 B 整体:B 里如果同时放了视觉和触觉,它们照样在同一个 softmax 里竞争。

复杂度:T 个 token 两两算相似度,计算量是 O(T²);标准实现要把 T×T 的注意力矩阵存下来,显存也是 O(T²)。FlashAttention 分块计算、不存完整矩阵,结果不变,注意力部分的显存降到随 T 线性增长,计算量仍是 O(T²)。序列再长,就要换稀疏注意力、线性注意力,或者换成 SSM(2.5.3)。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
import math
import torch
import torch.nn as nn
import torch.nn.functional as F

# 1) 注意力池化的原型:Nadaraya-Watson 核回归
torch.manual_seed(0)
x_train = torch.sort(torch.rand(50) * 5).values # Key
y_train = 2 * torch.sin(x_train) + x_train ** 0.8 + 0.3 * torch.randn(50) # Value
x_query = torch.linspace(0.5, 4.5, 5) # Query
sigma = 0.3 # 核宽度
scores = -((x_query[:, None] - x_train[None, :]) ** 2) / (2 * sigma ** 2) # (5, 50):离得越近分越高
alpha = F.softmax(scores, dim=1) # 注意力权重,每行和为 1
print("核回归预测:", (alpha @ y_train).numpy().round(2))
print("真实函数值:", (2 * torch.sin(x_query) + x_query ** 0.8).numpy().round(2))

# 2) 为什么要除以 √d:未缩放的点积方差约等于 d
d = 64
print("q·k 的方差:", (torch.randn(10000, d) * torch.randn(10000, d)).sum(1).var().item())

# 3) 缩放点积注意力(带因果掩码),和 PyTorch 的融合实现对比
def attention(q, k, v, mask=None):
scores = q @ k.transpose(-2, -1) / math.sqrt(q.size(-1))
if mask is not None:
scores = scores.masked_fill(~mask, float("-inf"))
return F.softmax(scores, dim=-1) @ v

q, k, v = torch.randn(3, 2, 4, 10, 16).unbind(0) # 各 (B=2, heads=4, T=10, d=16)
causal = torch.tril(torch.ones(10, 10, dtype=torch.bool)) # 位置 t 只看 ≤ t
print("与融合实现一致:", torch.allclose(attention(q, k, v, causal),
F.scaled_dot_product_attention(q, k, v, is_causal=True), atol=1e-5))
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
import torch
import torch.nn as nn

torch.manual_seed(0)
d = 64
vis = torch.randn(1, 196, d) # 视觉 token:14×14 个图像块
tac = torch.randn(1, 4, d) # 触觉 token:4 个
act = torch.randn(1, 16, d) # 动作 token:16 步

attn = nn.MultiheadAttention(d, num_heads=4, batch_first=True)

# 自注意力:Q、K、V 都来自同一序列
out, w = attn(vis, vis, vis)
print("self :", tuple(out.shape), "权重", tuple(w.shape)) # (1,196,64) 权重 (1,196,196)

# 交叉注意力:动作 token 当 Q,去「视觉 + 触觉」里检索;只有动作 token 得到新表示
ctx = torch.cat([vis, tac], 1)
out, w = attn(act, ctx, ctx)
print("cross:", tuple(out.shape), "权重", tuple(w.shape)) # (1,16,64) 权重 (1,16,200)

# 联合注意力:三路拼成一条序列做自注意力,不加掩码时所有 token 都被更新
seq = torch.cat([vis, tac, act], 1) # (1, 216, 64)
out, w = attn(seq, seq, seq)
share = w[0, 200:, 196:200].sum(-1).mean().item() # 动作 token 分给 4 个触觉 token 的权重
print(f"joint(随机初始化): 动作 token 分给触觉 token 的平均权重 {share:.3f}(触觉只占 4/216;训练后会变,权重小也不等于贡献小)")

典型例子

  • 机器翻译里的对齐:译出某个词时,注意力权重集中在原句对应的词上
  • 检索:RAG 可以和 Q/K/V 类比,问题像 Q、文档像 K/V;实际的 RAG 先用检索器从文档索引里取 top-k 篇,再和问题一起交给生成器,并不是让生成器对整个文档库做注意力
  • 现代 Hopfield 网络的一步更新在数学上就是注意力(2.12.1)
  • 优势:任意两个位置一步直连,没有距离衰减;权重随输入内容变化(CNN 的卷积核是固定的);权重可视化能看出这一层、这个头在汇聚哪些位置的信息(要说明哪些输入对最终决策重要,还要配合其他分析或干预实验);对集合和序列都适用
  • 局限:计算量 O(T²)(标准实现的显存也是 O(T²));对 V 只是加权平均,逐 token 的特征变换要靠后面的 FFN;本身不知道顺序(没有因果掩码时完全不知道),需要位置编码
  • 适合的数据:能切成一组 token 的任何东西:文本、图像块、音频帧、点、图节点、动作步、多模态混合序列

2.1.1 Transformer
<center>2.1.1 Transformer
2.1.1 Transformer
<center>2.1.1 Transformer
2.1.1 Transformer

一句话

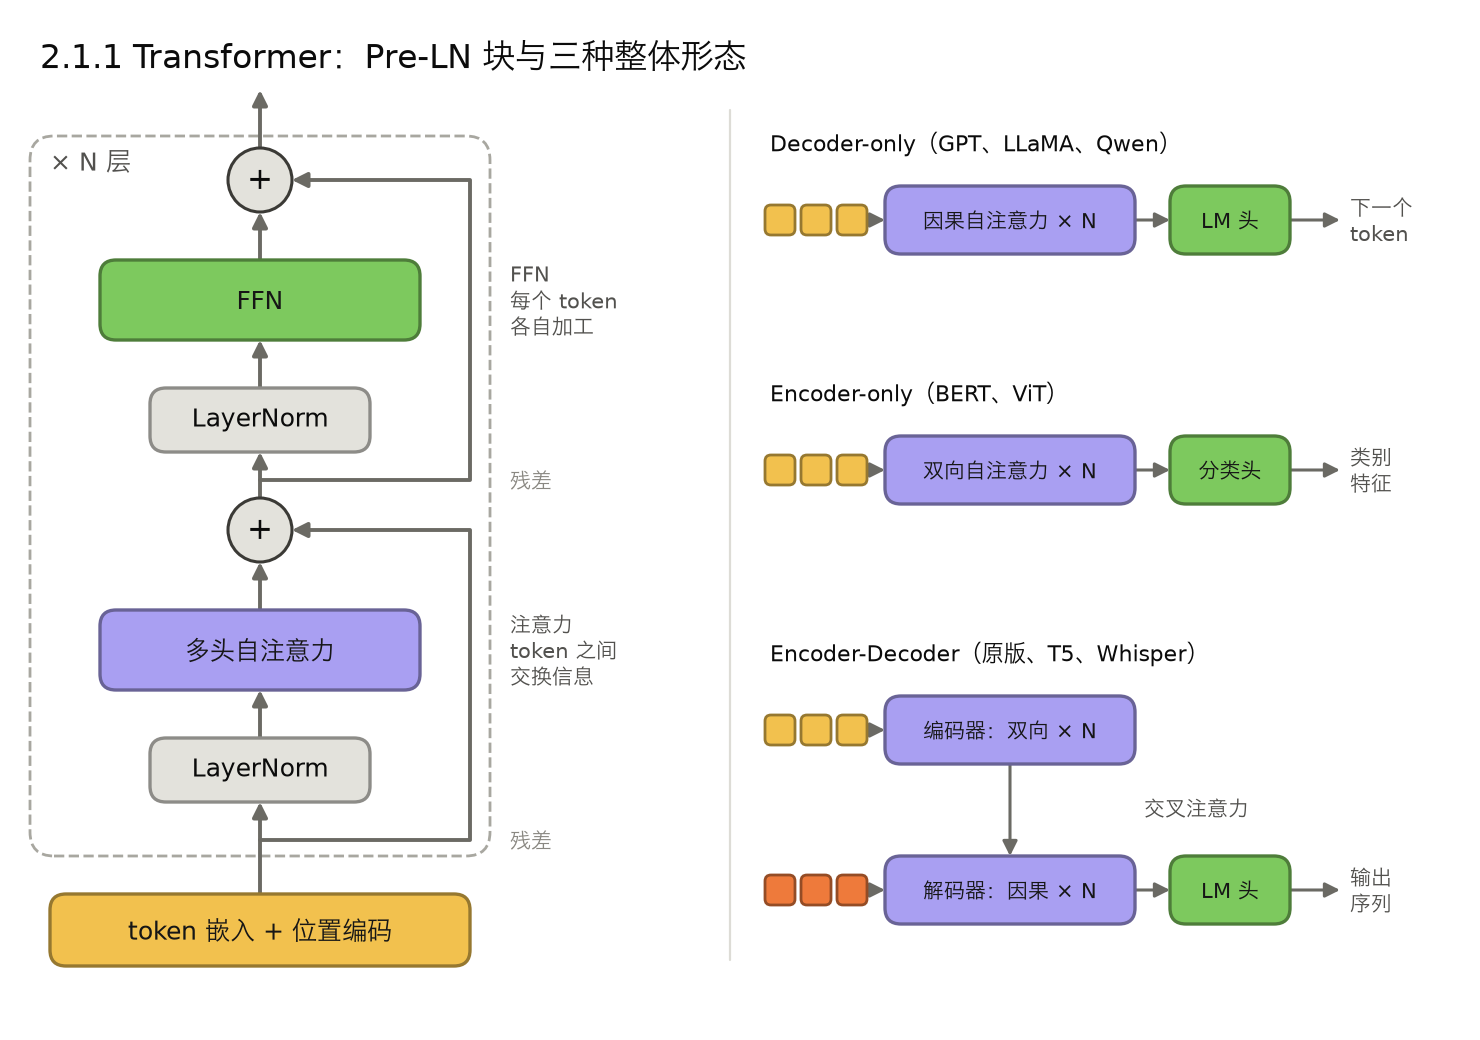
只用注意力和逐 token 的前馈网络堆起来的序列模型,去掉了循环,训练时序列里的各个位置可以并行计算(层与层之间仍是先后依赖)。

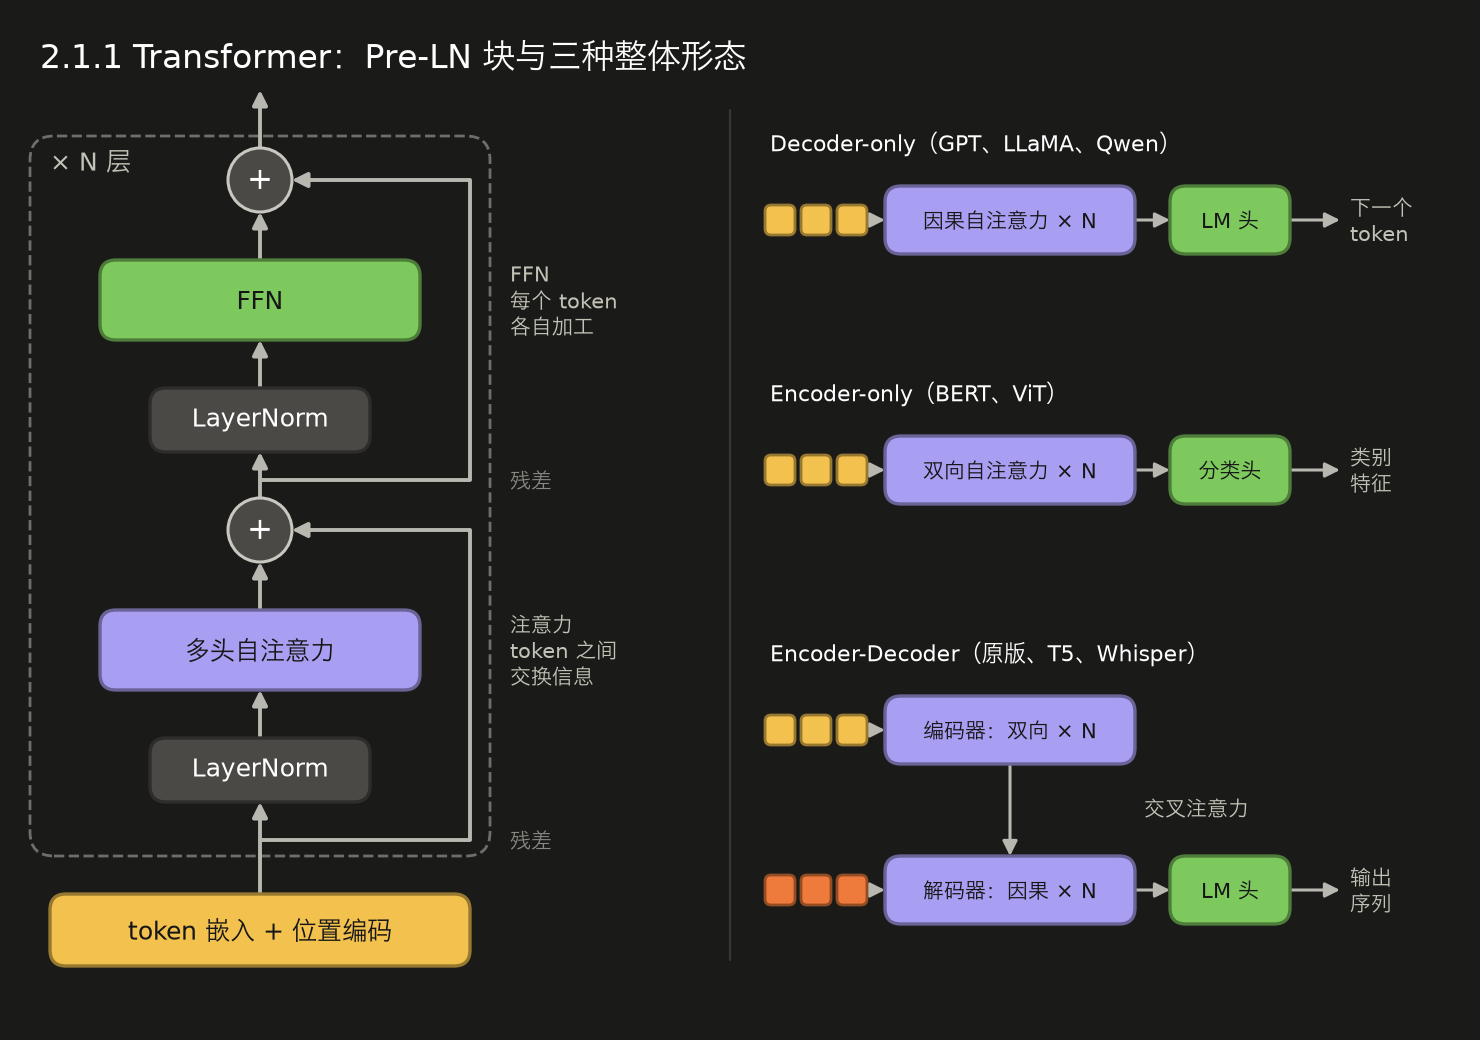
一个 block 的结构(现代通用的 Pre-LN 写法,见上图左):

原版论文把 LayerNorm 放在残差相加之后(Post-LN),层数多了不好训;现在基本都用 Pre-LN。

分工:注意力决定「看谁」,按内容算出权重,把各个 token 的 V 混合起来。权重随输入变化、还要过 softmax,所以注意力对输入也是非线性的,但它不对单个 token 的特征做逐维的非线性变换;FFN 决定「看完之后怎么想」,逐 token 的非线性变换主要发生在 FFN 里。FFN 逐个 token 独立作用,同一层里词与词之间在 FFN 这一步不交换信息。

参数在哪:注意力有 Q、K、V、O 四个 d×d 投影,共 4d²;FFN 两个矩阵 d×4d 和 4d×d,共 8d²。FFN 占一个 block 参数的 2/3。所以混合专家(2.7.1)想在不增加单 token 计算量的前提下扩大参数,复制的是 FFN。SwiGLU 版 FFN 有三个矩阵,一般把中间维度调成 8d/3 来保持参数量不变。

为什么需要位置编码:不加位置信息、也没有因果掩码这类固定顺序的掩码时,自注意力对输入顺序是置换等变的:打乱输入顺序,输出也只是同样被打乱,模型不知道谁在前谁在后。因果掩码本身会带进一部分顺序信息(只用因果掩码、不加位置编码的解码器也能学到位置),但常规做法仍是显式加位置编码。位置编码把位置信息加进 token:

位置编码 做法 谁在用
RoPE 旋转位置编码 把 q、k 的每两维看成一个复数,按位置旋转一个角度;旋转后的点积仍取决于 q、k 的内容,但位置的作用只通过相对位置差体现 LLaMA、Qwen 等绝大多数新大模型
可学习的绝对位置 每个位置一个可学习向量,加到输入上 BERT、GPT-2、ViT
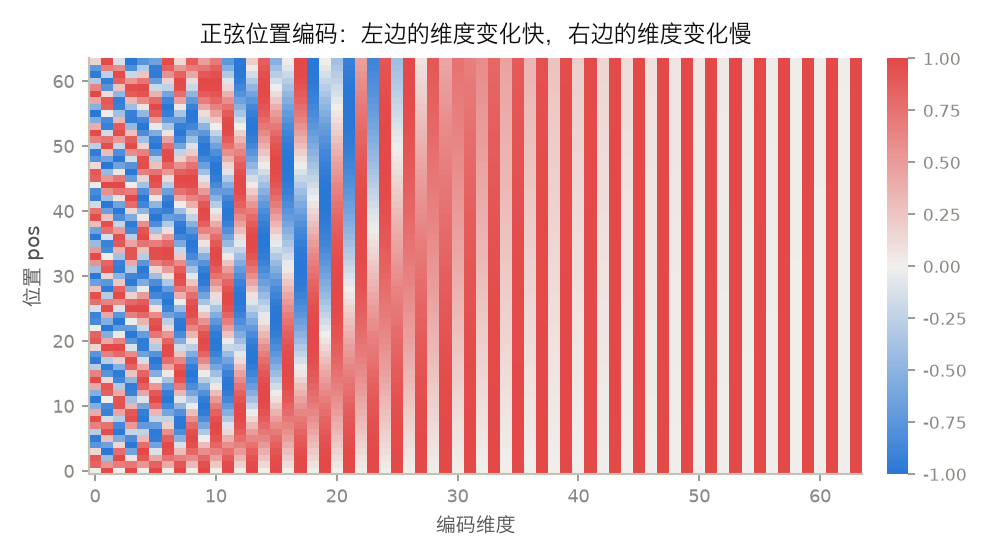
正弦位置编码 不同频率的 sin/cos,原版论文用 原版 Transformer
ALiBi 等相对偏置 在注意力分数上按距离加一个惩罚 部分长上下文模型
<center>正弦位置编码
正弦位置编码
<center>正弦位置编码
正弦位置编码

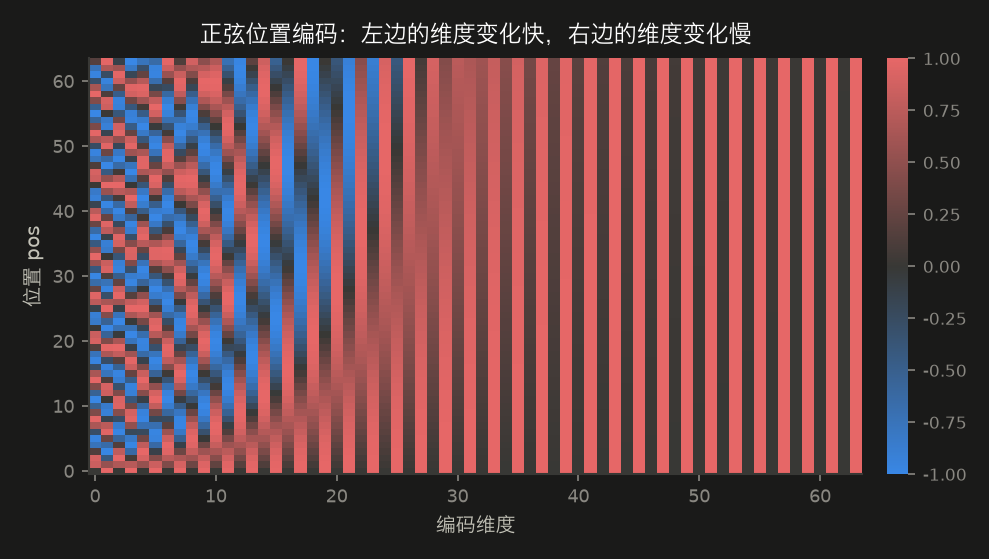
每一行是一个位置的编码向量。低维的正弦频率高,相邻位置差别大;高维的频率低,用来区分远距离的位置。

三种整体形态

形态 掩码 典型预训练目标 代表 用途
Decoder-only 因果 预测下一个 token GPT、LLaMA、Qwen、DeepSeek 生成,现在的大语言模型几乎都是这一种(2.1.2)
Encoder-only 无,双向 BERT:掩码语言模型(随机选约 15% 的 token 让它预测,其中 80% 换成 [MASK]、10% 换成随机词、10% 保持原样);ViT:有监督图像分类,或 MAE 式掩码重建(2.6.2) BERT、ViT 理解、分类、提特征
Encoder-Decoder 编码器双向,解码器因果 + 交叉注意力 去噪、翻译 原版 Transformer、T5、Whisper 输入输出是两种序列的转换
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
import torch
import torch.nn as nn
import torch.nn.functional as F

class MultiHeadAttention(nn.Module):
def __init__(self, d_model, n_heads):
super().__init__()
self.h, self.dk = n_heads, d_model // n_heads
self.qkv = nn.Linear(d_model, 3 * d_model) # Q、K、V 三个投影合成一次矩阵乘
self.proj = nn.Linear(d_model, d_model) # 输出投影

def forward(self, x, causal=False): # x: (B, T, D)
B, T, D = x.shape
q, k, v = self.qkv(x).view(B, T, 3, self.h, self.dk).permute(2, 0, 3, 1, 4) # 各 (B, h, T, dk)
out = F.scaled_dot_product_attention(q, k, v, is_causal=causal)
return self.proj(out.transpose(1, 2).reshape(B, T, D))

class TransformerBlock(nn.Module):
def __init__(self, d_model, n_heads, p=0.1):
super().__init__()
self.ln1, self.ln2 = nn.LayerNorm(d_model), nn.LayerNorm(d_model)
self.attn = MultiHeadAttention(d_model, n_heads)
self.ffn = nn.Sequential(nn.Linear(d_model, 4 * d_model), nn.GELU(),
nn.Linear(4 * d_model, d_model), nn.Dropout(p))

def forward(self, x, causal=False):
x = x + self.attn(self.ln1(x), causal) # 横向:token 之间交换信息
return x + self.ffn(self.ln2(x)) # 纵向:每个 token 各自加工

def sinusoidal_pe(T, d):
pos = torch.arange(T).float()[:, None]
ang = pos / 10000 ** (torch.arange(0, d, 2).float() / d)
pe = torch.zeros(T, d)
pe[:, 0::2], pe[:, 1::2] = torch.sin(ang), torch.cos(ang)
return pe

torch.manual_seed(0)
d = 64
block = TransformerBlock(d, n_heads=8).eval()
x = torch.randn(2, 10, d)
print("输出形状:", tuple(block(x).shape)) # (2, 10, 64)

attn_p = block.attn.qkv.weight.numel() + block.attn.proj.weight.numel()
ffn_p = sum(m.weight.numel() for m in block.ffn if isinstance(m, nn.Linear))
print(f"注意力 {attn_p} = 4d²,FFN {ffn_p} = 8d²,FFN 占 {ffn_p / (attn_p + ffn_p):.3f}")

perm = torch.randperm(10)
print("无位置编码,打乱输入 = 打乱输出:", torch.allclose(block(x)[:, perm], block(x[:, perm]), atol=1e-5))
pe = sinusoidal_pe(10, d)
print("加位置编码后还等变吗:", torch.allclose(block(x + pe)[:, perm], block(x[:, perm] + pe), atol=1e-5))

# 三种形态用 PyTorch 内置模块怎么搭
enc_layer = nn.TransformerEncoderLayer(d, 8, 4 * d, batch_first=True, norm_first=True)
encoder = nn.TransformerEncoder(enc_layer, num_layers=2, enable_nested_tensor=False) # Encoder-only:双向(会把 enc_layer 深拷贝成 2 层,各层参数独立、初始值相同)
memory = encoder(torch.randn(2, 12, d))
dec_layer = nn.TransformerDecoderLayer(d, 8, 4 * d, batch_first=True, norm_first=True)
decoder = nn.TransformerDecoder(dec_layer, num_layers=2)
tgt = torch.randn(2, 7, d)
mask = nn.Transformer.generate_square_subsequent_mask(7)
out = decoder(tgt, memory, tgt_mask=mask, tgt_is_causal=True) # Encoder-Decoder:因果自注意力 + 交叉注意力读 memory
print("编码器输出", tuple(memory.shape), "解码器输出", tuple(out.shape))
# Decoder-only = 编码器层 + 因果掩码,见 2.1.2
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
import torch

def rope(x, base=10000):
"""旋转位置编码。x: (..., T, d),d 为偶数"""
T, d = x.shape[-2], x.shape[-1]
freqs = base ** (-torch.arange(0, d, 2).float() / d) # 每对维度一个旋转频率
ang = torch.arange(T).float()[:, None] * freqs # (T, d/2):位置 × 频率 = 旋转角
x1, x2 = x[..., 0::2], x[..., 1::2]
rotated = torch.stack([x1 * ang.cos() - x2 * ang.sin(),
x1 * ang.sin() + x2 * ang.cos()], -1)
return rotated.flatten(-2)

# 同一个 q、同一个 k 放在不同位置:旋转后的内积只取决于两者的相对距离
torch.manual_seed(0)
q = torch.randn(1, 8).expand(6, 8)
k = torch.randn(1, 8).expand(6, 8)
s = rope(q) @ rope(k).T # s[m, n] = 位置 m 的 q 与位置 n 的 k 的内积
print("相距 1:", [round(s[m, m - 1].item(), 4) for m in range(1, 6)])
print("相距 3:", [round(s[m, m - 3].item(), 4) for m in range(3, 6)])

典型例子

  • 机器翻译:原版论文(2017)在 WMT14 英德翻译上 BLEU 28.4,训练成本远低于当时的 RNN 方案
  • BERT(2018):Encoder-only,掩码语言模型预训练后微调,刷新了 11 项 NLP 任务
  • 大语言模型:GPT、LLaMA、Qwen、DeepSeek,全部是 Decoder-only
  • 语音:Whisper(Encoder-Decoder,音频频谱 → 文字)
  • 蛋白质结构:AlphaFold2 的 Evoformer 用注意力处理序列比对和残基对
  • 机器人:RT-2、OpenVLA、π0 等视觉-语言-动作模型的主干
  • 优势:长程依赖一步到位;训练时各位置可以并行,GPU 利用率高;任何模态切成 token 都能处理,一套架构吃所有模态;规模越大效果越好的趋势很稳定(scaling law)
  • 局限:O(T²) 开销;归纳偏置少,小数据从头训容易过拟合,通常要预训练;自回归推理要逐 token 生成;推理延迟高,难直接上几百 Hz 的控制回路
  • 适合的数据:token 序列与集合,尤其是数据量大、依赖跨度长的场景:文本、代码、图像块、音频、视频、动作序列、多模态混合序列

2.1.2 GPT 式解码器与大语言模型
<center>2.1.2 GPT
2.1.2 GPT
<center>2.1.2 GPT
2.1.2 GPT

一句话

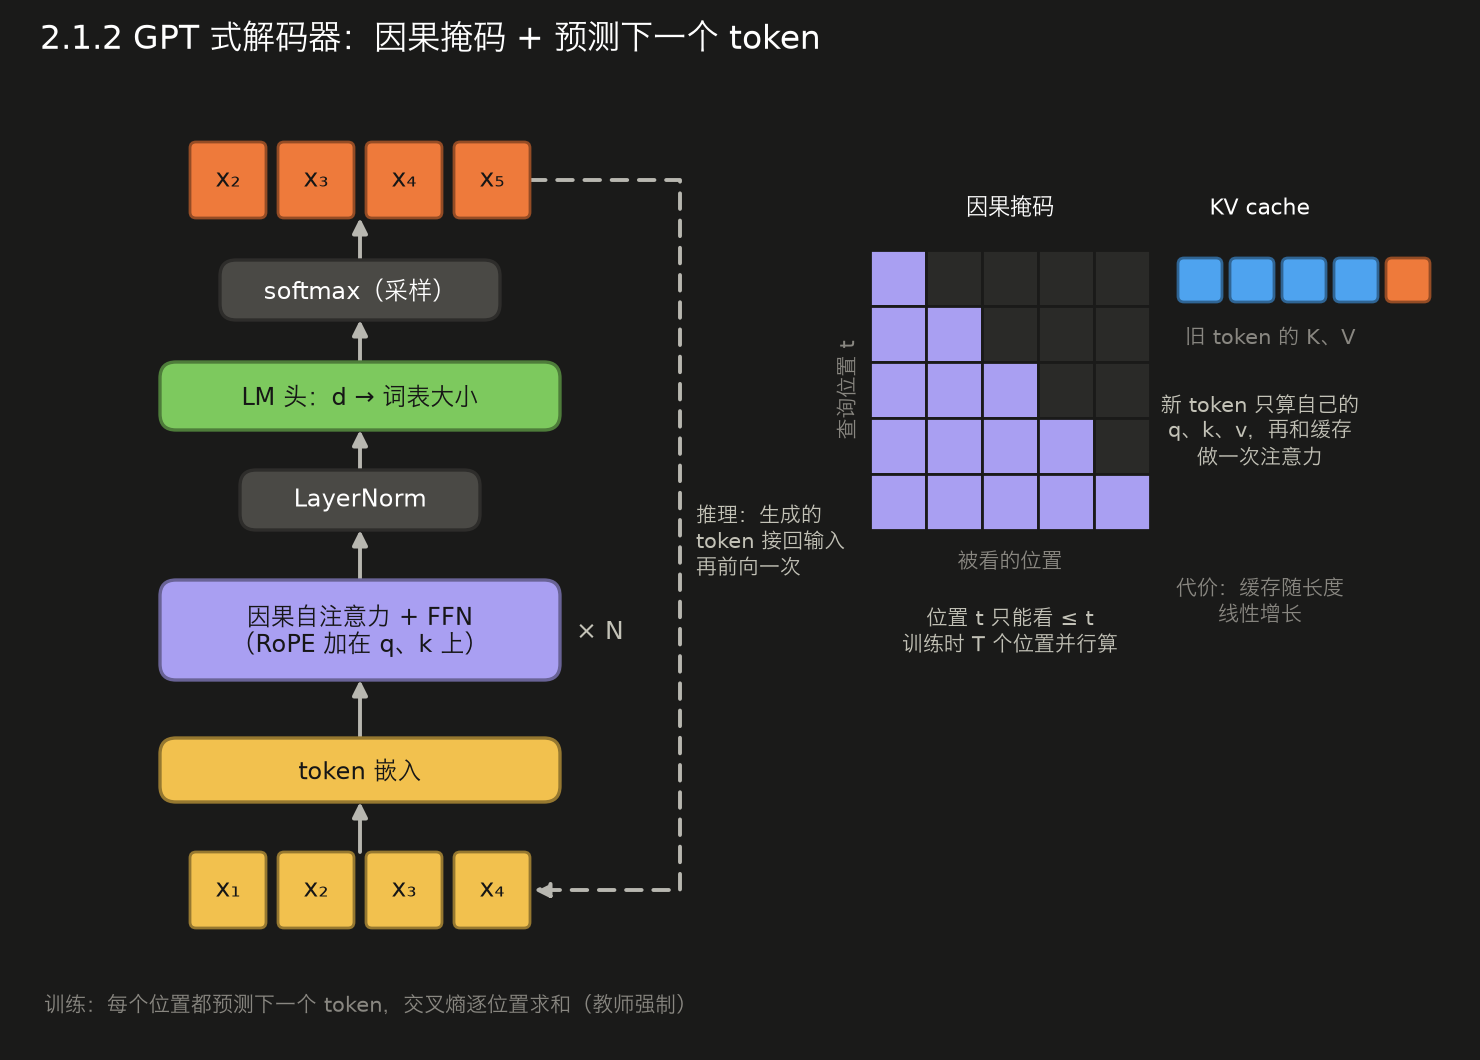
Decoder-only Transformer + 因果掩码 + 「预测下一个 token」,把这个目标在海量文本上训练,就是大语言模型的预训练。

自回归分解:把一个序列的联合概率拆成逐个 token 的条件概率连乘:

损失就是每个位置上的交叉熵(1.4 节的 NLL)。

训练并行、推理串行:训练时整句一次喂进去,因果掩码保证位置 t 只能看到 t 之前,T 个位置的预测同时算,这叫教师强制(teacher forcing)。推理时只能一个一个生成,每生成一个 token 接到末尾再喂回去。

KV cache:推理时,之前 token 的 K、V 不会变,存起来;每步只给新 token 算 q、k、v,新 token 的 q 去和全部缓存的 K、V 做注意力。每步计算从重算整条序列变成只算一个位置。代价是缓存随序列长度线性增长,长上下文时 KV cache 往往比模型权重还占显存。

采样策略

策略 做法 效果
贪心 每步取概率最大的 确定、容易重复
温度 logits 除以 T 再 softmax T < 1 更保守,T > 1 更随机
top-k 只在概率最高的 k 个里采样 去掉长尾的离谱选项
top-p(nucleus) 只在累计概率达到 p 的最小集合里采样 候选数随分布形状自适应

一个大语言模型从无到有

1
2
3
4
5
文本 → 分词器(BPE,把文本切成子词 token)
→ 预训练:下一个 token 预测,数万亿 token → 基座模型(会续写,不会对话)
→ 有监督微调 SFT:指令-回答对 → 能按指令回答
→ 偏好对齐:RLHF(PPO)、DPO;可验证奖励的强化学习(如 GRPO 用于数学、代码)
→ 推理:KV cache、采样策略、量化

规模定律:损失随参数量、数据量、计算量按幂律下降(Kaplan 2020)。Chinchilla(2022)给出计算量固定时的最优配比:大约每个参数配 20 个训练 token。这是在他们的模型族和计算预算范围内拟合出的经验值,不是固定配方;为了让推理便宜,实际常用比这多得多的数据去训练较小的模型。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
import torch
import torch.nn as nn
import torch.nn.functional as F

# 训练语料:四首唐诗(公有领域),字符级
text = ("床前明月光,疑是地上霜。举头望明月,低头思故乡。"
"春眠不觉晓,处处闻啼鸟。夜来风雨声,花落知多少。"
"白日依山尽,黄河入海流。欲穷千里目,更上一层楼。"
"红豆生南国,春来发几枝。愿君多采撷,此物最相思。")
chars = sorted(set(text)); stoi = {c: i for i, c in enumerate(chars)}
data = torch.tensor([stoi[c] for c in text])

class MiniGPT(nn.Module):
def __init__(self, vocab, d=64, n_layers=2, n_heads=4, max_len=32):
super().__init__()
self.tok = nn.Embedding(vocab, d)
self.pos = nn.Embedding(max_len, d) # 可学习的位置编码
layer = nn.TransformerEncoderLayer(d, n_heads, 4 * d, dropout=0.0, batch_first=True, norm_first=True)
self.blocks = nn.TransformerEncoder(layer, n_layers, enable_nested_tensor=False)
self.ln, self.head = nn.LayerNorm(d), nn.Linear(d, vocab) # head 输出词表上的 logits
self.max_len = max_len

def forward(self, idx): # idx: (B, T)
T = idx.size(1)
x = self.tok(idx) + self.pos(torch.arange(T))
mask = nn.Transformer.generate_square_subsequent_mask(T) # 因果掩码 → Decoder-only
return self.head(self.ln(self.blocks(x, mask=mask, is_causal=True))) # (B, T, vocab)

def sample_next(logits, temperature=1.0, top_k=None, top_p=None):
logits = logits / temperature
if top_k is not None:
kth = logits.topk(top_k).values[..., -1, None]
logits = logits.masked_fill(logits < kth, float("-inf"))
if top_p is not None:
sorted_logits, idx = logits.sort(descending=True)
probs = F.softmax(sorted_logits, -1)
drop = probs.cumsum(-1) - probs > top_p # 前面的累计概率已经超过 p 的都去掉
sorted_logits[drop] = float("-inf")
logits = torch.full_like(logits, float("-inf")).scatter(-1, idx, sorted_logits)
return torch.multinomial(F.softmax(logits, -1), 1)

@torch.no_grad()
def generate(model, idx, n_new, **kw):
for _ in range(n_new): # 自回归:生成一个,接到末尾,再喂回去
logits = model(idx[:, -model.max_len:])[:, -1]
idx = torch.cat([idx, sample_next(logits, **kw)], 1)
return idx

torch.manual_seed(0)
model = MiniGPT(len(chars))
opt = torch.optim.AdamW(model.parameters(), lr=3e-3)
T = 16
for step in range(800):
ix = torch.randint(0, len(data) - T, (32,)) # 合法起点是 0 到 len − T − 1(randint 不含上界)
x = torch.stack([data[i:i + T] for i in ix])
y = torch.stack([data[i + 1:i + T + 1] for i in ix]) # 目标 = 输入右移一位
loss = F.cross_entropy(model(x).reshape(-1, len(chars)), y.reshape(-1))
opt.zero_grad(); loss.backward(); opt.step()
print(f"训练损失 {loss.item():.3f}")

for start, kw in [("白", dict(temperature=0.5)), ("春", dict(top_k=3)), ("红", dict(top_p=0.9))]:
out = generate(model, torch.tensor([[stoi[start]]]), 11, **kw)
print(start, kw, "→", "".join(chars[i] for i in out[0]))
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
import torch
import torch.nn as nn
import torch.nn.functional as F

class CausalSelfAttention(nn.Module):
def __init__(self, d, h):
super().__init__()
self.h, self.dk = h, d // h
self.qkv, self.proj = nn.Linear(d, 3 * d), nn.Linear(d, d)

def forward(self, x, cache=None): # x: (B, T_new, d)
B, T, D = x.shape
q, k, v = self.qkv(x).view(B, T, 3, self.h, self.dk).permute(2, 0, 3, 1, 4)
if cache is not None: # 之前 token 的 K、V 直接拿来用
k, v = torch.cat([cache[0], k], 2), torch.cat([cache[1], v], 2)
T_all = k.size(2)
mask = torch.ones(T, T_all, dtype=torch.bool).tril(T_all - T) # 新 token 能看到全部旧 token
out = F.scaled_dot_product_attention(q, k, v, attn_mask=mask)
return self.proj(out.transpose(1, 2).reshape(B, T, D)), (k, v)

torch.manual_seed(0)
attn = CausalSelfAttention(32, 4)
x = torch.randn(1, 12, 32)
full, _ = attn(x) # 一次性算 12 个位置(训练时的做法)
outs, cache = [], None
for t in range(12): # 逐 token 推理:每步只算 1 个新 token
o, cache = attn(x[:, t:t + 1], cache)
outs.append(o)
print("逐步 + KV cache = 一次性计算:", torch.allclose(torch.cat(outs, 1), full, atol=1e-5))
print("缓存的 K 形状 (B, heads, T, dk):", tuple(cache[0].shape))

典型例子

  • ChatGPT、Claude、LLaMA、Qwen、DeepSeek 等对话模型
  • 代码模型:补全、生成、修 bug
  • 文本以外的自回归:DALL·E 第一版把图像切成离散 token 后自回归生成;AudioLM 对音频 token 自回归;RT-2 和 OpenVLA 把机器人动作离散成 256 个区间当成词表里的 token
  • 动作离散化之后,训练目标和训练语言模型完全一样(交叉熵),整套 LLM 训练与推理设施可以原样复用
  • 优势:训练目标简单统一(下一个 token),数据不需要标注;似然可以精确计算;一个模型通过提示词完成多种任务;可以直接继承语言模型的预训练权重
  • 局限:逐 token 生成,顺序解码的轮数随输出长度线性增加,全注意力时每轮的注意力代价还随上下文变长而增加,总耗时还要看模型、缓存和硬件;早期生成错了会一路影响后面(误差级联);连续量(如机器人动作)要先离散化,精度受区间数限制
  • 适合的数据:天然离散的序列(文本、代码);或者能被分词器变成离散 token 的任何数据(图像、音频、动作经 VQ 或分箱离散化后)

2.1.3 ViT(Vision Transformer)
<center>2.1.3 ViT
2.1.3 ViT
<center>2.1.3 ViT
2.1.3 ViT

一句话

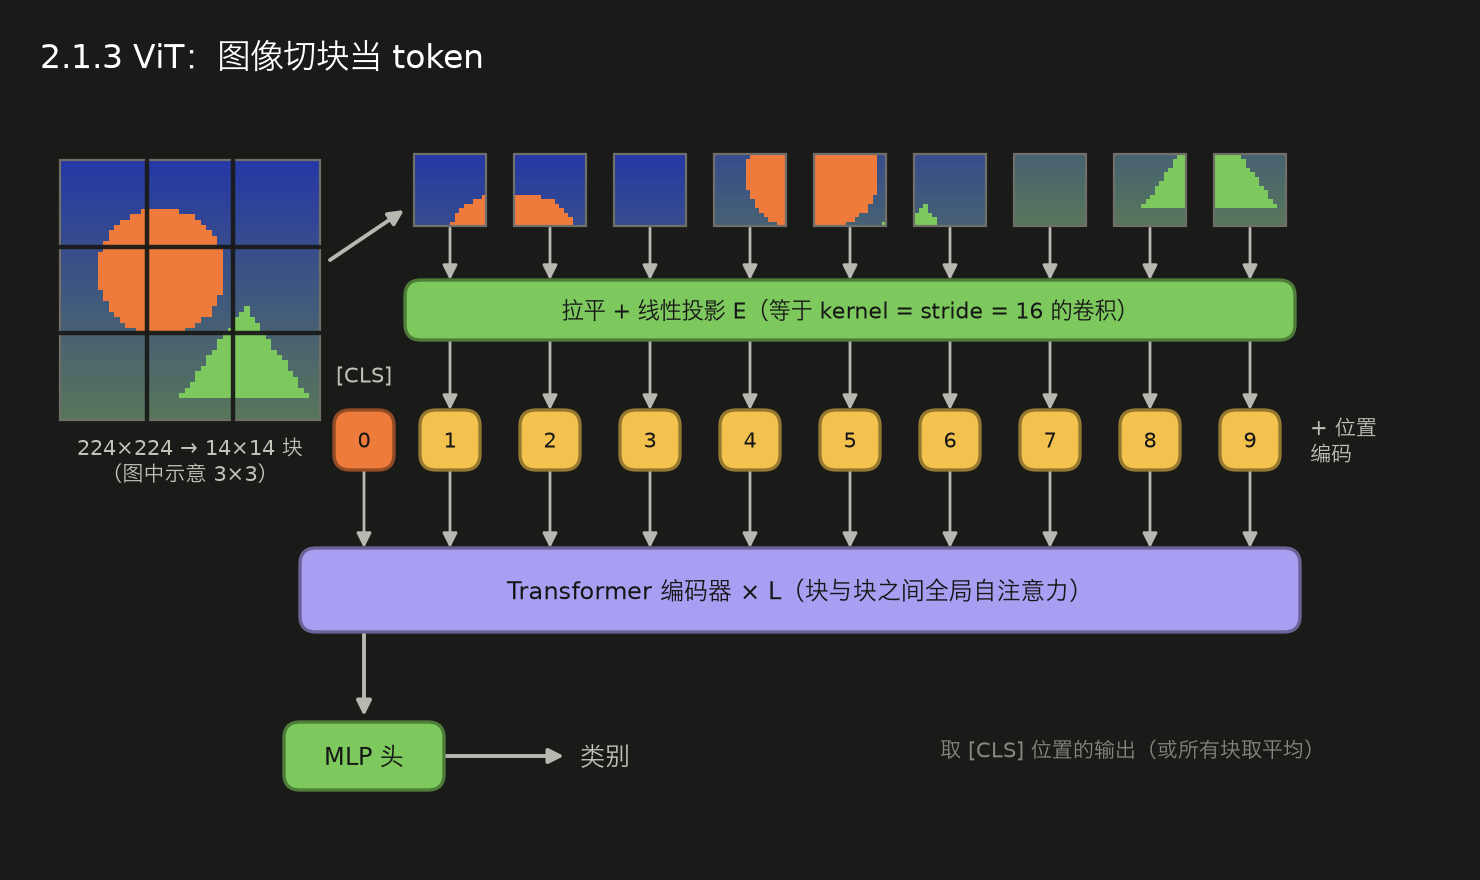
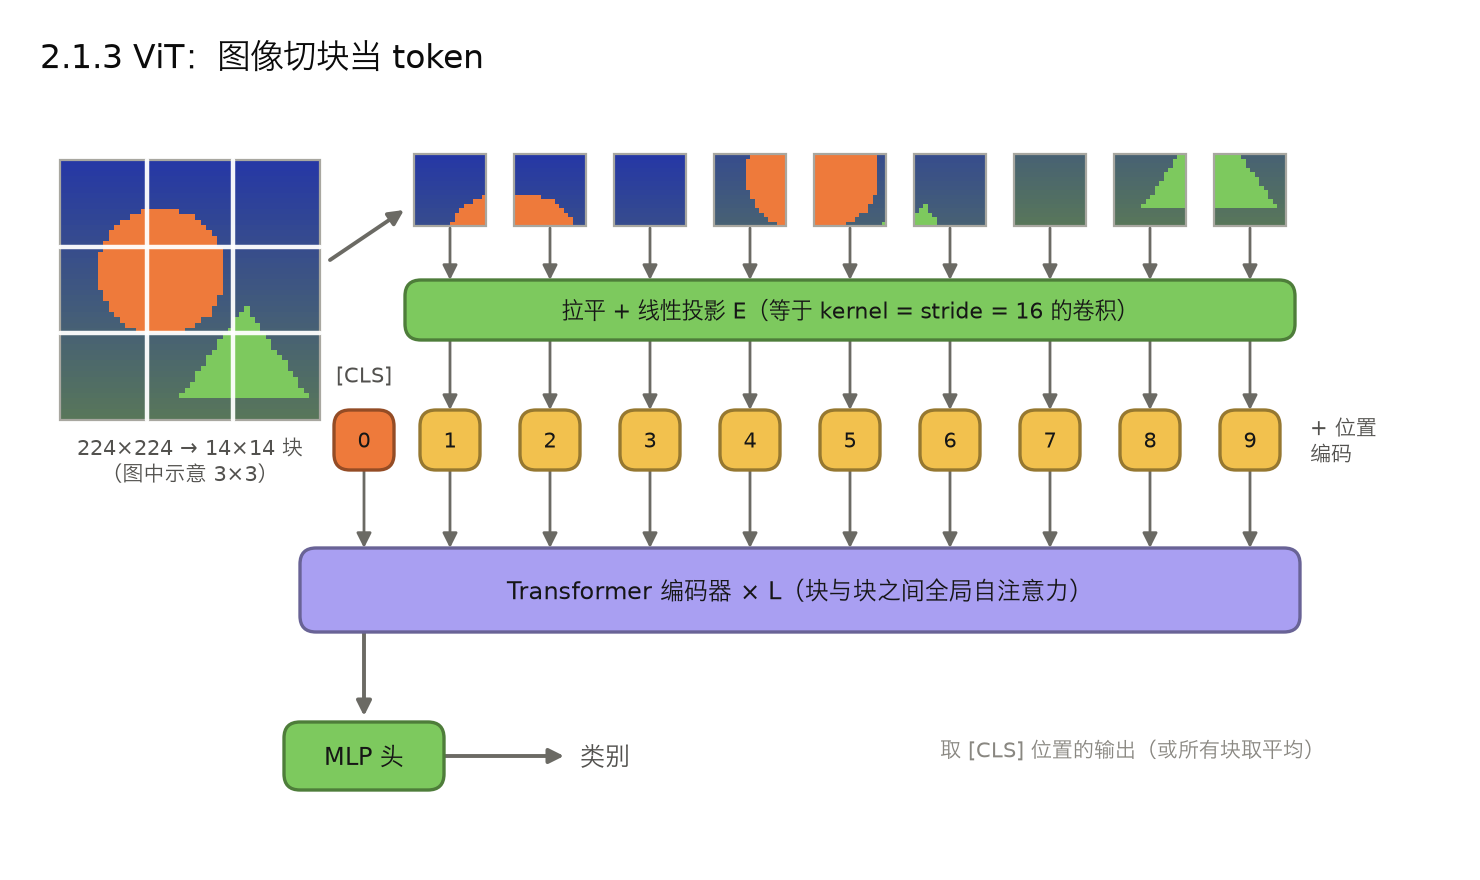
把图像切成 16×16 的小块,每块当一个 token,送进 Transformer 编码器做分类。

流程

  1. 切块 + 线性投影:224×224 的图切成 14×14 = 196 个 16×16 的块,每块拉平后乘一个矩阵变成 d 维向量。这一步等价于一个 kernel = stride = 16 的卷积
  2. 加 [CLS] token 和位置编码:在序列最前面加一个可学习的 [CLS] 向量,再给每个位置加可学习的位置编码
  3. Transformer 编码器:L 层,块与块之间做全局自注意力
  4. 分类:取 [CLS] 位置的输出接一个线性层(也可以对所有块取平均)

数据量是门槛:ViT 没有卷积的局部性和平移等变先验。原论文在 ImageNet(130 万张)上从头训不如同等规模的 ResNet;在 ImageNet-21k(1400 万张)或 JFT-300M(3 亿张)上预训练后,在多个基准上接近或超过当时最好的结果,预训练数据越大优势越明显。具体胜负还取决于任务、模型规模、训练方法和算力。之后的改进围绕「少数据也能训」和「高分辨率也能算」展开:

变体 改了什么
DeiT 强数据增强 + 蒸馏,只用 ImageNet 也能训好
Swin Transformer 在固定大小的局部窗口内做注意力、逐层合并;模型尺寸和窗口固定时,计算量随像素数(token 数)近似线性增长,适合检测分割
MAE 遮住 75% 的块让模型重建,自监督预训练(2.6.2)
DINO / DINOv2 自蒸馏预训练,特征直接拿来做检索、分割、机器人视觉编码(2.6.3)
CLIP / SigLIP 的图像编码器 用图文对比学习预训练(2.6.1),多数 VLA 的视觉编码器
MLP-Mixer 把注意力换成在块维度上的 MLP,说明「切块 + 混合」这个结构本身就很有效
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
import torch
import torch.nn as nn

class ViT(nn.Module):
def __init__(self, img=32, patch=4, in_ch=3, d=128, depth=4, heads=4, n_cls=10):
super().__init__()
n_patches = (img // patch) ** 2
self.patchify = nn.Conv2d(in_ch, d, kernel_size=patch, stride=patch) # 切块 + 线性投影
self.cls = nn.Parameter(torch.zeros(1, 1, d))
self.pos = nn.Parameter(torch.randn(1, n_patches + 1, d) * 0.02) # 可学习位置编码
layer = nn.TransformerEncoderLayer(d, heads, 4 * d, dropout=0.1, activation="gelu",
batch_first=True, norm_first=True)
self.encoder = nn.TransformerEncoder(layer, depth, enable_nested_tensor=False)
self.head = nn.Sequential(nn.LayerNorm(d), nn.Linear(d, n_cls))

def forward(self, x): # x: (B, 3, 32, 32)
x = self.patchify(x).flatten(2).transpose(1, 2) # (B, 64, d):8×8 个块,每块一个 token
x = torch.cat([self.cls.expand(x.size(0), -1, -1), x], 1) + self.pos
x = self.encoder(x) # 块与块之间全局注意力
return self.head(x[:, 0]) # 用 [CLS] 的输出分类

print("CIFAR 尺寸输入:", tuple(ViT()(torch.randn(8, 3, 32, 32)).shape)) # (8, 10)

# 小实验:图中 6×6 的亮块在哪个象限(要用到位置信息)
def make_batch(n):
q = torch.randint(0, 4, (n,)) # 象限 0–3
r0 = (q // 2) * 16 + torch.randint(0, 10, (n,)) # 亮块左上角的行
c0 = (q % 2) * 16 + torch.randint(0, 10, (n,)) # 亮块左上角的列
idx = torch.arange(32)
rows = ((idx >= r0[:, None]) & (idx < r0[:, None] + 6)).float() # (n, 32)
cols = ((idx >= c0[:, None]) & (idx < c0[:, None] + 6)).float()
blob = rows[:, :, None] * cols[:, None, :] # (n, 32, 32)
return torch.randn(n, 3, 32, 32) * 0.3 + 2.0 * blob[:, None], q

torch.manual_seed(0)
model = ViT(n_cls=4, d=64, depth=2)
opt = torch.optim.AdamW(model.parameters(), lr=1e-3)
for step in range(500):
x, y = make_batch(64)
loss = nn.functional.cross_entropy(model(x), y)
opt.zero_grad(); loss.backward(); opt.step()
model.eval()
x, y = make_batch(500)
with torch.no_grad():
print("象限分类准确率:", (model(x).argmax(1) == y).float().mean().item())

典型例子

  • 图像分类:ViT-L/16 在大规模预训练后超过 ResNet
  • 通用视觉特征:SigLIP、DINOv2 和常用的 CLIP-ViT 版本的图像编码器都是 ViT(CLIP 也有 ResNet 版本),下游检索、分割、VLA 直接复用
  • 分割一切:SAM 的图像编码器是 MAE 预训练的 ViT
  • 触觉:GelSight 一类视触觉传感器输出的是图像,可以直接用 ViT 编码
  • 优势:第一层就有全局感受野;与文本 Transformer 结构统一,图文多模态拼接方便;数据和模型规模上去后性能持续提升;自监督预训练效果好
  • 局限:小数据从头训不如 CNN;块大小固定时 token 数和像素数成正比:图像边长变成 r 倍,token 数变成 r² 倍,全局注意力的两两交互变成 r⁴ 倍,高分辨率代价大;块内部的细粒度位置靠块嵌入自己学
  • 适合的数据:图像等网格数据,前提是有大规模数据或现成的预训练权重;需要和语言等其他模态对齐的视觉任务

2.1.4 Seq2Seq 与注意力的起源
<center>2.1.4 Seq2Seq
2.1.4 Seq2Seq
<center>2.1.4 Seq2Seq
2.1.4 Seq2Seq

一句话

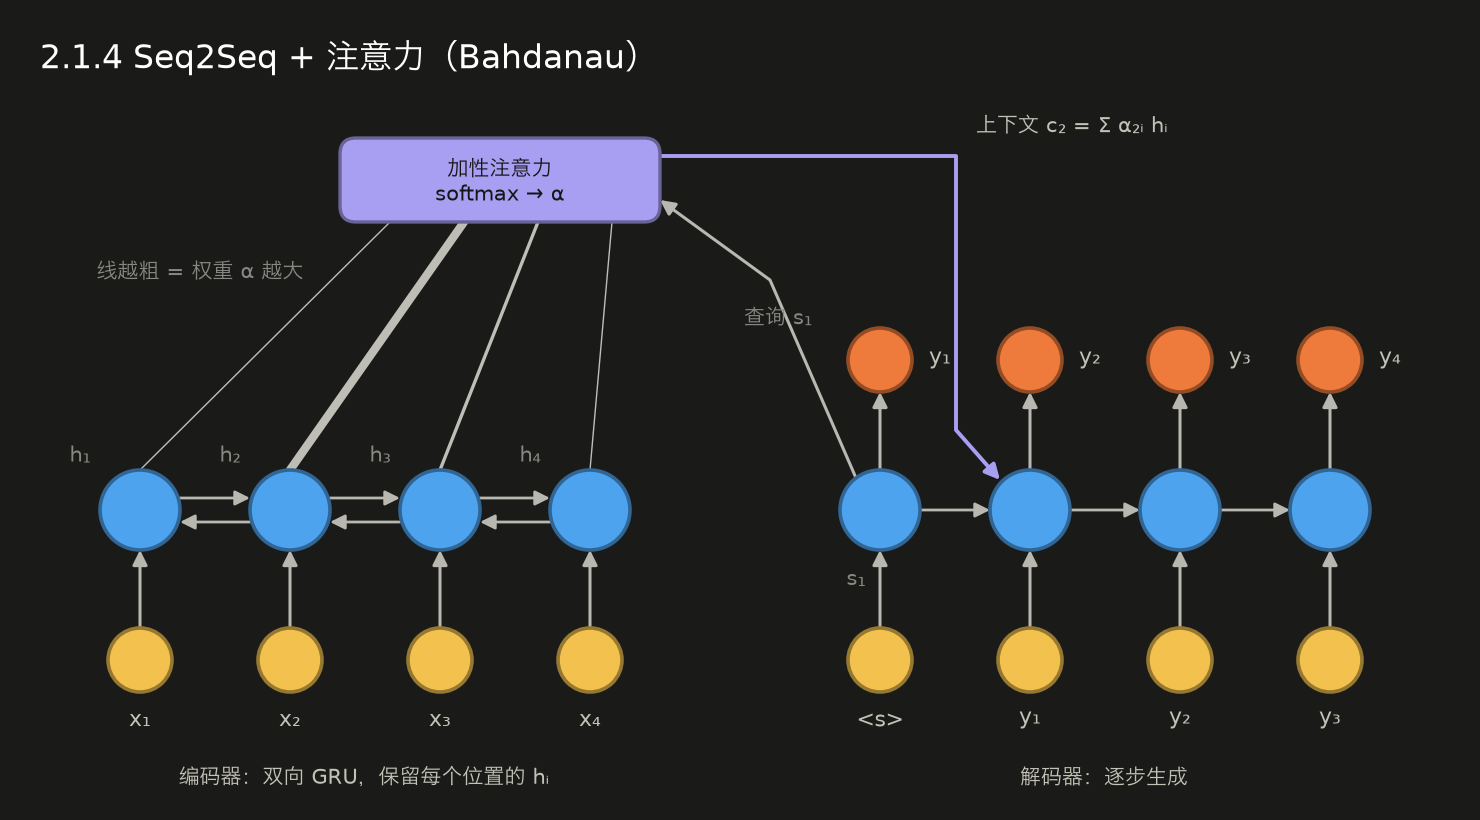
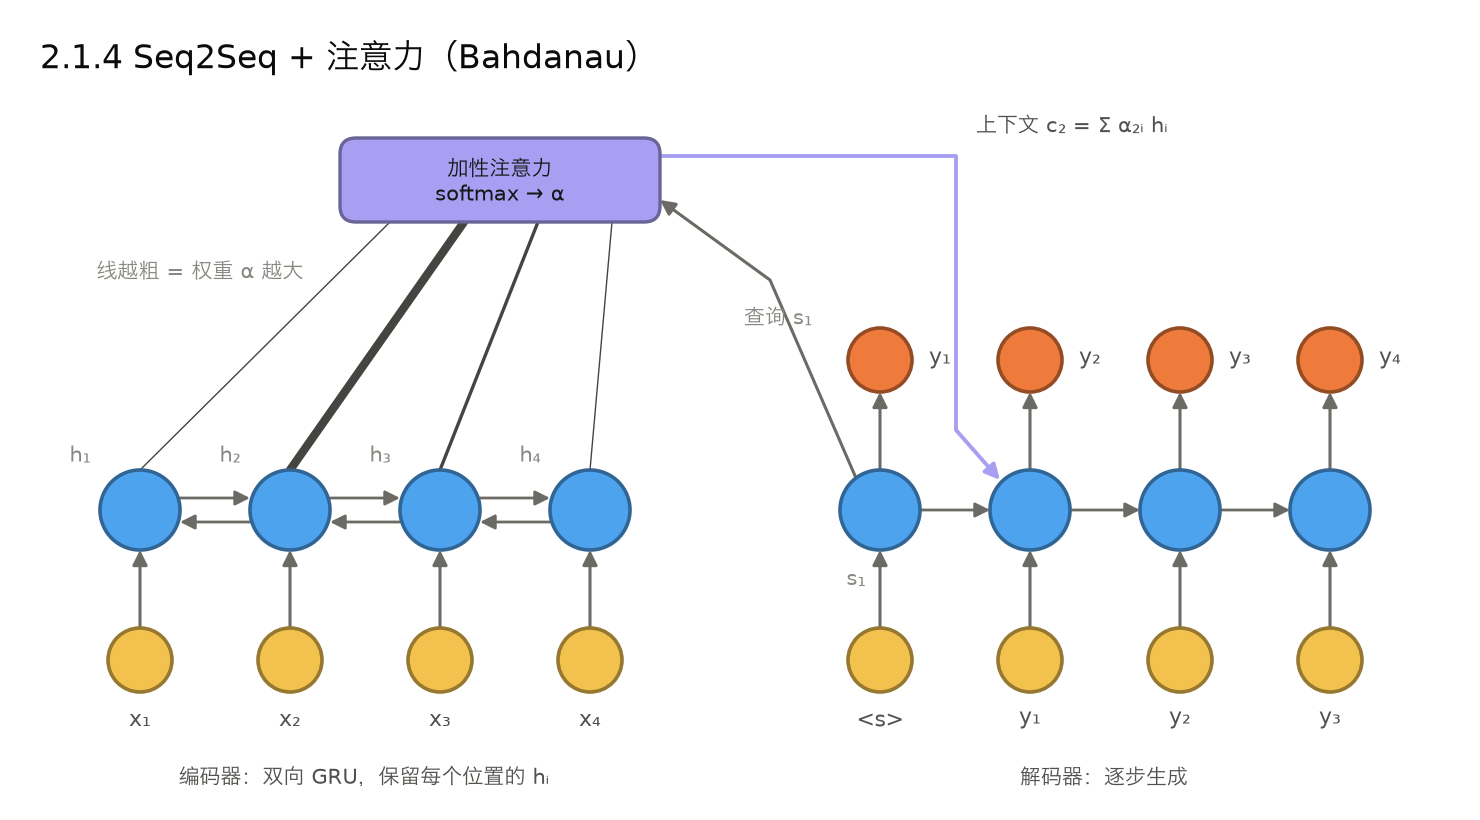
编码器 RNN 读完输入序列,解码器 RNN 逐步生成输出序列;注意力让解码器每一步都能回头看输入的任意位置。

编码器-解码器(Sutskever 2014):编码器把整个输入压成一个固定长度的向量,解码器从这个向量出发生成输出。问题是长句子的信息全挤在一个向量里,句子越长效果越差。

加注意力(Bahdanau 2014):编码器保留每个位置的隐状态 h_1…h_S。解码器在第 t 步用自己的状态 s_{t−1} 当 Query,对所有 h_i 打分、softmax、加权求和,得到这一步专属的上下文向量 c_t:

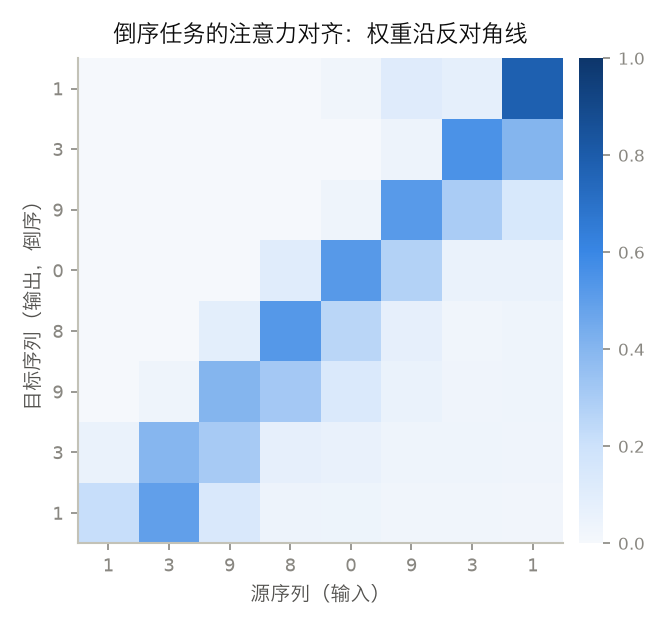
注意力权重 α 画出来,常能看出输入与输出之间的对齐关系。三年后 Transformer 把 RNN 整个去掉,只留注意力。

训练与推理不一致:训练时解码器每步的输入是正确答案的上一个词(教师强制),推理时只能用自己上一步的输出,错误会累积,这叫 exposure bias。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
import torch
import torch.nn as nn
import torch.nn.functional as F

SOS, V = 10, 11 # 词表:数字 0–9,外加开始符 10

class Seq2SeqAttention(nn.Module):
def __init__(self, E=32, H=64):
super().__init__()
self.emb = nn.Embedding(V, E)
self.encoder = nn.GRU(E, H, batch_first=True, bidirectional=True)
self.dec_cell = nn.GRUCell(E + 2 * H, H)
self.W_s, self.W_h, self.v = nn.Linear(H, H), nn.Linear(2 * H, H), nn.Linear(H, 1) # 加性注意力
self.out = nn.Linear(3 * H, V)
self.H = H

def forward(self, src, tgt_in):
enc, _ = self.encoder(self.emb(src)) # (B, S, 2H):每个源位置保留一个向量
s = enc.new_zeros(src.size(0), self.H)
logits, attns = [], []
for t in range(tgt_in.size(1)):
score = self.v(torch.tanh(self.W_s(s)[:, None] + self.W_h(enc))).squeeze(-1) # (B, S)
alpha = F.softmax(score, -1) # 这一步该看源序列的哪里
ctx = (alpha[..., None] * enc).sum(1) # 上下文向量
s = self.dec_cell(torch.cat([self.emb(tgt_in[:, t]), ctx], -1), s)
logits.append(self.out(torch.cat([s, ctx], -1)))
attns.append(alpha)
return torch.stack(logits, 1), torch.stack(attns, 1)

def make_batch(n, L=8):
src = torch.randint(0, 10, (n, L))
tgt = src.flip(1) # 任务:把数字序列倒过来
tgt_in = torch.cat([torch.full((n, 1), SOS), tgt[:, :-1]], 1) # 教师强制:输入是右移一位的答案
return src, tgt, tgt_in

torch.manual_seed(0)
model = Seq2SeqAttention()
opt = torch.optim.Adam(model.parameters(), lr=3e-3)
for step in range(1500):
src, tgt, tgt_in = make_batch(64)
logits, _ = model(src, tgt_in)
loss = F.cross_entropy(logits.reshape(-1, V), tgt.reshape(-1))
opt.zero_grad(); loss.backward(); opt.step()

@torch.no_grad()
def greedy(src, L=8):
tok = torch.full((src.size(0), 1), SOS)
for _ in range(L): # 推理:用自己上一步的输出当下一步输入
logits, attn = model(src, tok)
tok = torch.cat([tok, logits[:, -1:].argmax(-1)], 1)
return tok[:, 1:], attn

src, tgt, _ = make_batch(500)
pred, attn = greedy(src)
print("整句完全正确的比例:", (pred == tgt).all(1).float().mean().item())
print("第 1 个样本,每个输出步最关注的源位置:", attn[0].argmax(-1).tolist()) # 沿反对角线:7,6,5,… 接近 0
<center>Seq2Seq注意力对齐
Seq2Seq注意力对齐
<center>Seq2Seq注意力对齐
Seq2Seq注意力对齐

典型例子

  • 神经机器翻译:Google 2016 年上线的 GNMT 是 8 层 LSTM 编码器-解码器加注意力
  • 语音识别:Listen, Attend and Spell
  • 图像描述:Show, Attend and Tell,生成每个词时注意力落在图像的对应区域
  • 文本摘要
  • 优势:输入输出长度可以不同;注意力去掉了固定长度向量的瓶颈,长句效果大幅提升;对齐关系可以可视化(权重高不直接等于对输出的因果贡献)
  • 局限:编码器、解码器都是 RNN,训练不能沿时间并行;逐步解码,误差累积;主流任务上大多已换成 Transformer,流式语音识别等场景仍有用循环解码器的
  • 适合的数据:序列到序列的转换:翻译、摘要、语音转文字、图像描述;今天主要作为理解 Transformer 来历的一环