深度学习与神经网络5
2.3 卷积网络
2.3.1 CNN 卷积神经网络 〔图:DCN〕
一句话
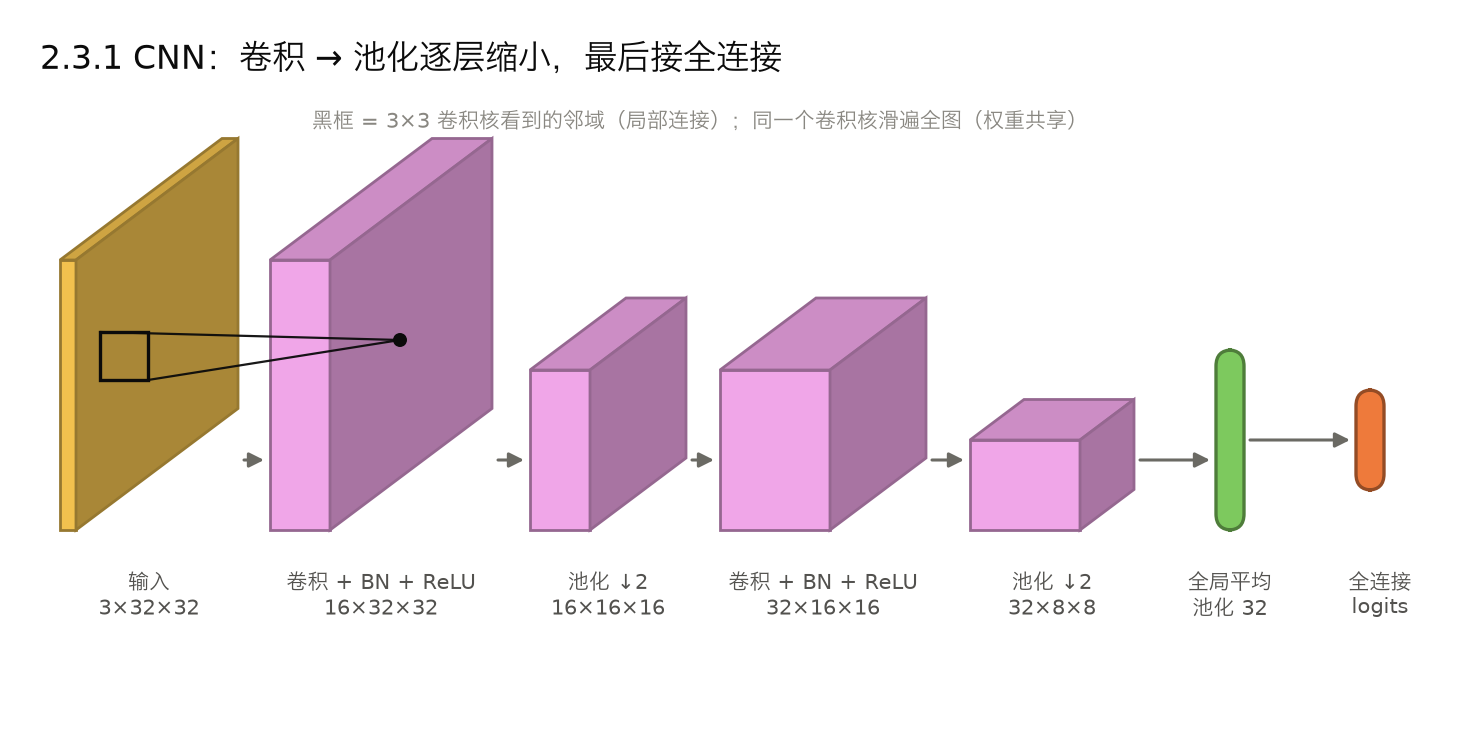
用一个小卷积核在图上滑动,每个输出只看输入的一小块,同一个卷积核在全图共享;一层层堆叠,从边缘、纹理逐步组合成部件和物体。
卷积运算:输出通道 c_out 在位置 (i, j) 的值,是输入在该位置 k×k 邻域内、所有输入通道上的加权和:
输出尺寸(输入 H、卷积核 k、步长 s、补零 p,不膨胀;膨胀率为 d 时把 k 换成 d(k − 1) + 1):
两条设计
- 局部连接:一个输出只看输入的一小块(感受野)
- 权重共享:同一个卷积核滑遍全图,参数量和图像大小无关
由此得到平移等变:输入平移,特征图跟着平移。严格说这只在步长为 1、不碰边界时成立:补零让边界附近不等变,步长大于 1 时只有平移量是步长的整数倍才等变。再接池化(取邻域最大值或平均值),对小幅平移变得近似不变。
典型结构:[卷积 → BN → ReLU] × 若干 → 池化(分辨率减半;下一组卷积常把通道数翻倍)→ …… → 全局平均池化 → 全连接分类头。图中的 DCN 就是这个形状:前半段卷积池化逐层缩小,后半段接全连接层。
感受野:每一层能看到的输入范围逐层扩大。两个 3×3 卷积叠起来的感受野等于一个 5×5,参数更少、多一次非线性,VGG 因此全用 3×3。
几种卷积变体
| 变体 | 做法 | 用途 |
|---|---|---|
| 1D / 3D 卷积 | 卷积核在时间轴 / 时空上滑动 | 时间序列、音频(1D);视频、体素(3D) |
| 1×1 卷积 | 只混合通道,不看邻域 | 调整通道数、瓶颈结构 |
| 深度可分离卷积 | 每个通道单独做空间卷积 + 1×1 卷积混合通道 | MobileNet 等移动端网络,计算量约为普通卷积的 1/C_out + 1/k²,输出通道多时接近 1/k² |
| 膨胀(空洞)卷积 | 卷积核元素之间留空 | 不降分辨率地扩大感受野(分割、WaveNet) |
| 转置卷积 | 上采样 | 解码器、生成器(2.3.6) |
演进:LeNet-5(1998)→ AlexNet(2012,ReLU + Dropout + GPU)→ VGG(2014,全 3×3)→ GoogLeNet(2014,多尺度并行)→ ResNet(2015,残差)→ DenseNet → MobileNet / EfficientNet(轻量与缩放)→ ConvNeXt(2022,借鉴 Transformer 的设计,纯卷积追平 ViT)。
1 | import torch |
1 | import torch |
这组数据有个捷径:十字有 9 个亮像素,方框有 16 个,只看整张图的总亮度就能分开两类(按总亮度取阈值,理论准确率约 98.6%)。所以这个例子只展示两种模型在这组数据上的结果,不能单凭准确率说明 CNN 学到了形状,或者局部结构带来了优势;要做成归纳偏置的对照实验,得先让两类的亮度一致。
典型例子
- 手写数字与支票:LeNet 在上世纪 90 年代被银行用来读支票上的手写数字
- ImageNet 2012:AlexNet 把 top-5 错误率从 26.2% 降到 15.3%,深度学习从此进入主流
- 医学影像:皮肤癌分类(Esteva 2017)、眼底病变筛查
- 围棋:AlphaGo 的策略网络和价值网络把 19×19 棋盘当成图像处理
- 机器人:视觉编码器(Diffusion Policy、ACT 用 ResNet-18);GelSight 一类视触觉传感器输出图像,直接用 CNN 编码;触觉阵列、力/力矩时间序列用 1D 卷积
- 优势:参数少、样本效率高;局部性和平移等变贴合图像的结构;特征分层、可迁移(ImageNet 预训练权重拿来就能用,见 3.1);推理快,硬件和部署工具链成熟
- 局限:感受野有限,长程关系要堆很多层;对旋转、缩放没有内建不变性(靠数据增强);要求数据排在规则网格上
- 适合的数据:网格结构的数据:图像(2D)、视频与体素(3D)、音频波形和时间序列(1D)、频谱图、棋盘、触觉阵列
2.3.2 ResNet 残差网络 〔图:DRN〕
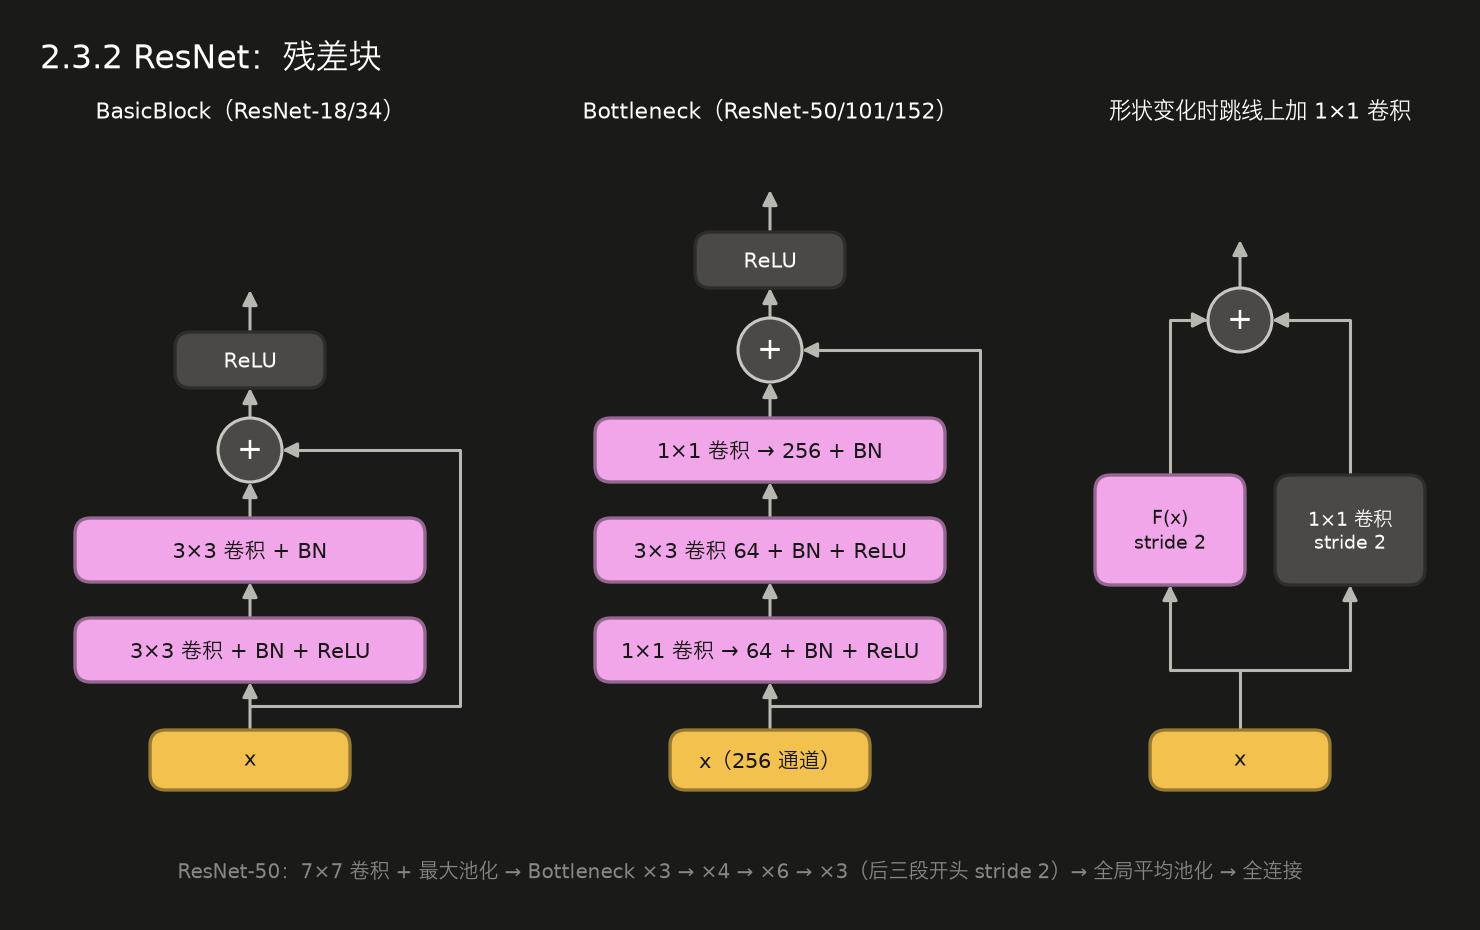
一句话
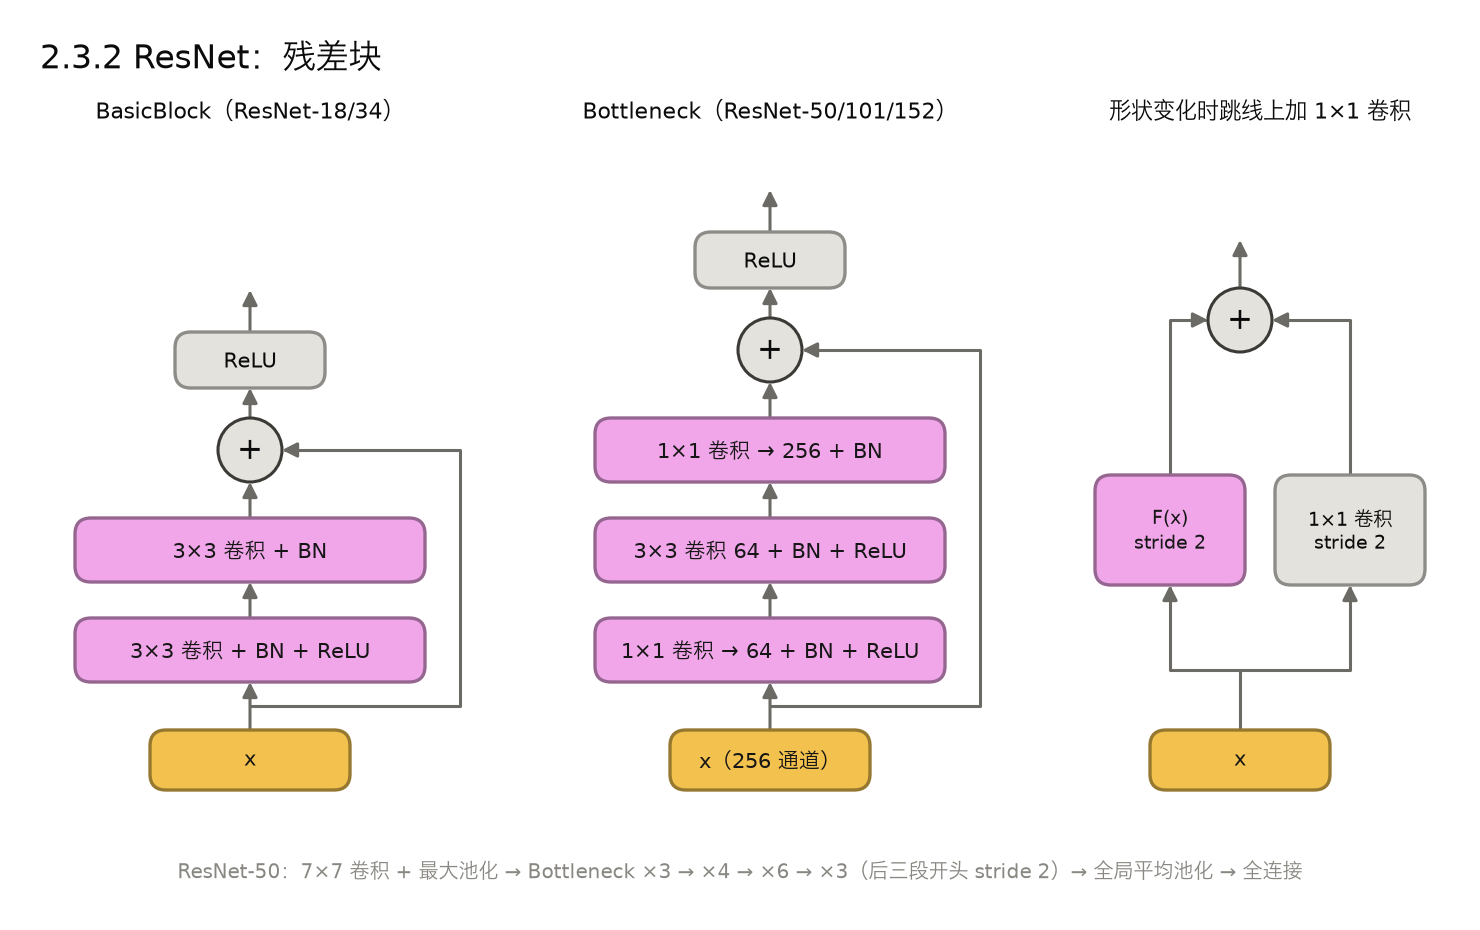
每两三层加一条「跳线」把输入直接加到输出上,网络只需要学「在输入基础上改多少」,于是能训练上百层。
退化问题:2015 年之前,把普通卷积网络从 20 层加到 56 层,训练误差反而更高。训练误差也变高,说明问题出在优化上:更深的普通网络更难训练,和过拟合无关。
残差连接:
如果某几层多余,只要把 F 学成 0 就退化成恒等映射,所以加深后的网络至少「表示得出」浅网络的解,优化也更容易找到它。这是表达能力上的性质,不保证训练一定找到这个解,也不保证测试效果随深度单调变好:原论文里 CIFAR-10 上 1202 层的测试误差(7.93%)就比 110 层(6.43%)高,作者认为是过拟合。反向传播时:
那个 I 给梯度留了一条绕过 F 直接传回浅层的路,连乘时不容易消失。这也不是保证:∂F/∂x 接近 −I 时,两项会互相抵消。图中 DRN 那些跨两层的弧线就是跳线。
两种块
| 块 | 结构 | 用在 |
|---|---|---|
| BasicBlock | 3×3 卷积 → 3×3 卷积,加跳线 | ResNet-18 / 34 |
| Bottleneck | 1×1 降通道 → 3×3 → 1×1 升通道,加跳线 | ResNet-50 / 101 / 152,深而省算力 |
形状变化时(步长 2 或通道数变了),跳线上用一个 1×1 卷积对齐形状。
影响:残差连接后来成了几乎所有深网络的标配,Transformer 的每个子层、U-Net、扩散模型、大语言模型都在用。
1 | import torch |
典型例子
- ImageNet 2015 冠军:6 个不同深度的 ResNet 组成的集成(其中两个 152 层),测试集 top-5 错误率 3.57%;单个 ResNet-152 在验证集上是 4.49%
- 检测与分割的主干:Faster R-CNN、Mask R-CNN 默认用 ResNet-50 + FPN
- AlphaGo Zero:用 20 / 40 个残差块的网络同时输出落子策略和局面价值
- 机器人视觉编码器:ResNet-18 是 Diffusion Policy、ACT 等策略的默认视觉主干
- 优势:能训练上百到上千层;梯度多了一条沿恒等路径直达浅层的路;恒等映射很容易表示,加深通常不再让训练误差变高;跳线这个设计即插即用于任何架构
- 局限:跳线要求形状一致,否则需要投影;很深的网络要保存大量中间激活给反向用,训练显存开销大(恒等跳线的加法本身不需要额外保存什么);很深的 ResNet 存在冗余(随机删掉一些块影响不大)
- 适合的数据:ResNet 这个网络本体主要用于图像;残差连接作为部件,适用于所有深网络
2.3.3 U-Net
一句话
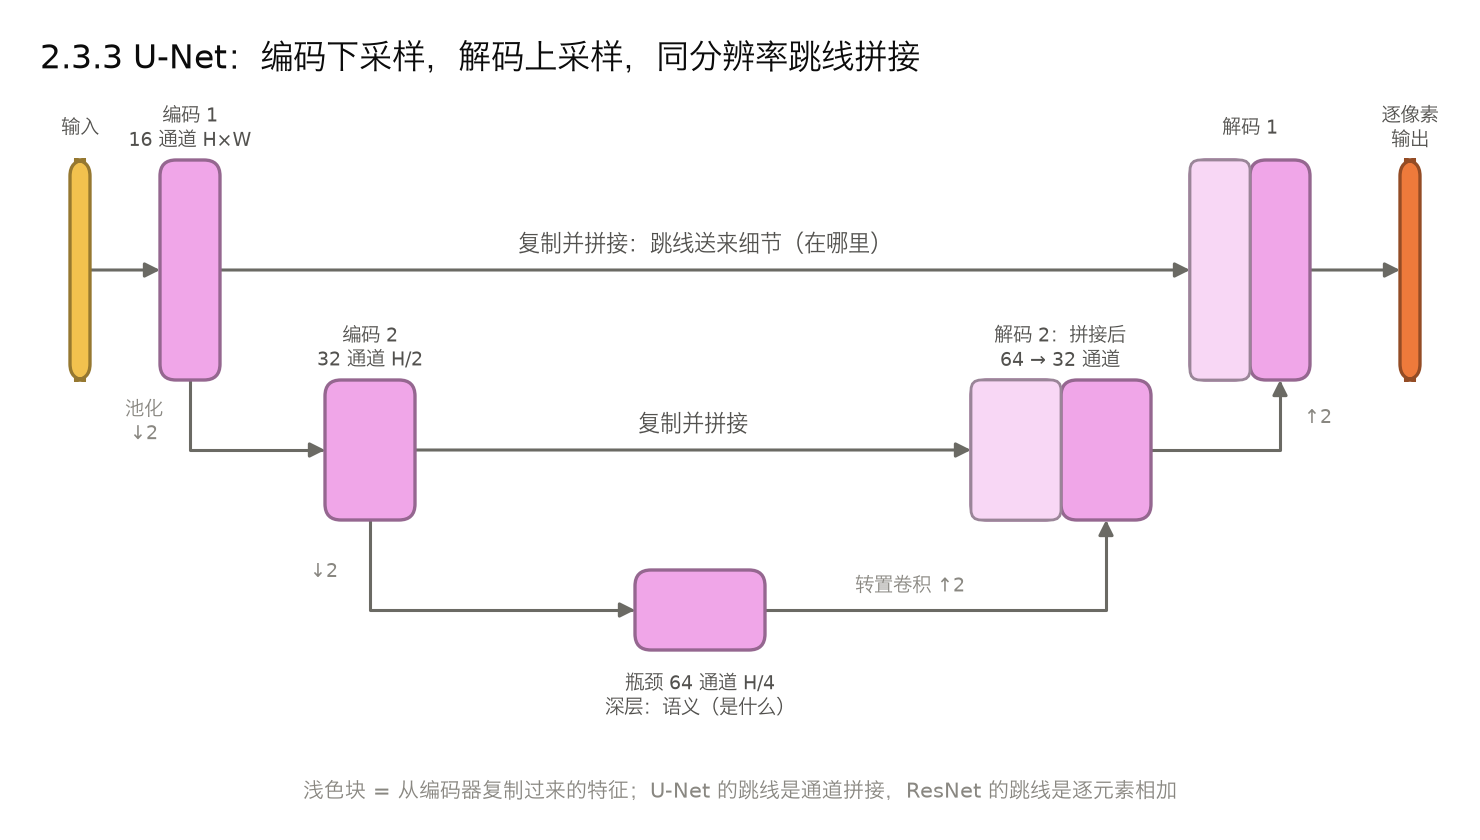
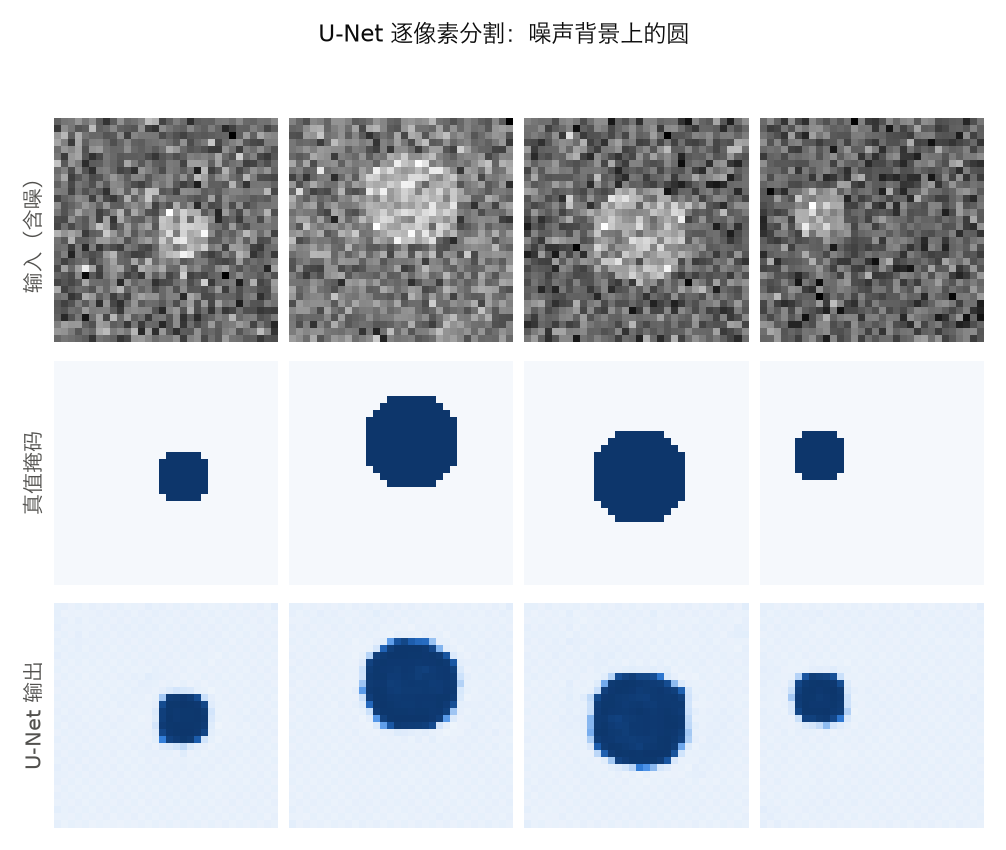
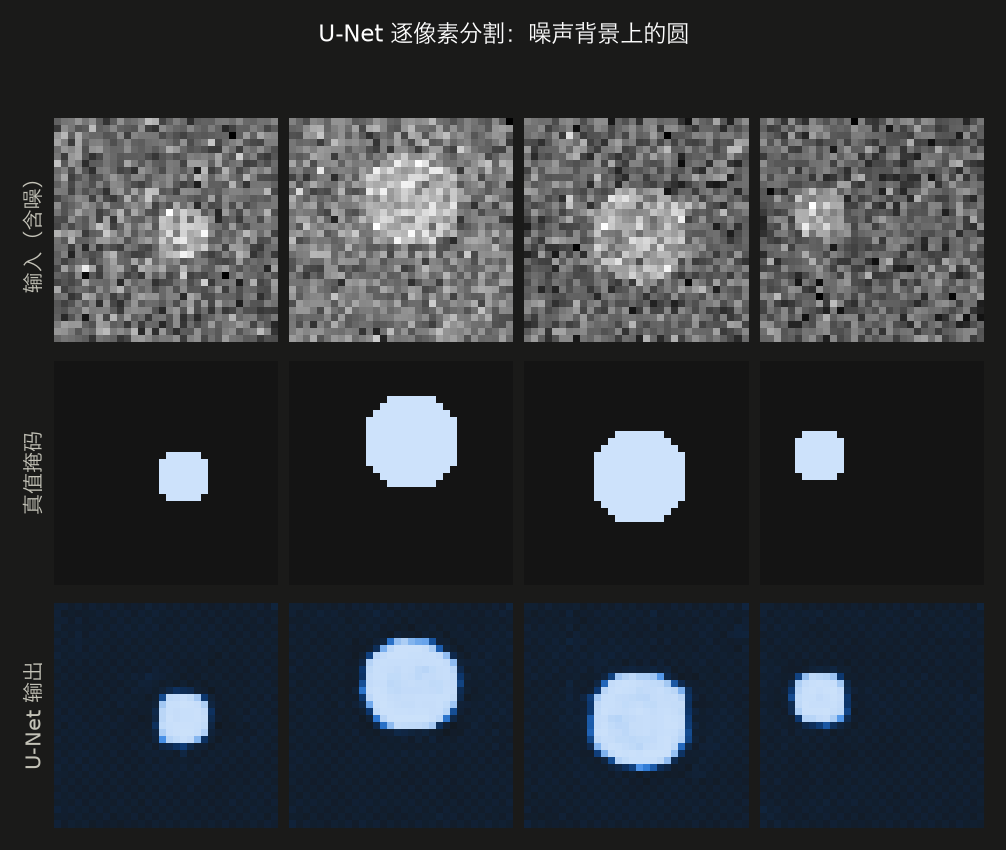
编码器逐层下采样提取语义,解码器逐层上采样恢复分辨率,同一分辨率的编码器特征通过跳线直接拼到解码器上;输出和输入逐像素对齐(常见的补零版本输出和输入同样大小;2015 年的原版不补零,572×572 的输入只输出中间 388×388 的区域)。
为什么要跳线:下采样会丢掉细节(边缘在哪个像素),只靠瓶颈的低分辨率特征上采样,输出会糊。跳线把编码器同层的高分辨率特征直接送过去,解码器同时拿到「是什么」(来自深层)和「在哪里」(来自浅层)。U-Net 的跳线把通道拼接起来,ResNet 的跳线则是逐元素相加。
1 | import torch |
典型例子
- 医学图像分割:原论文(2015)在电镜细胞分割上只用 30 张训练图,赢得 ISBI 挑战赛
- 扩散模型的去噪网络:DDPM、Stable Diffusion 的主体都是 U-Net(加了注意力层和条件注入)
- 图像翻译:pix2pix 的生成器
- 机器人:Diffusion Policy 用一维卷积 U-Net 对动作序列去噪,观测通过 FiLM 注入每一层(2.8.2)
- 优势:输出与输入逐像素对齐;同时保留细节和全局语义;数据少也能训(配合数据增强);结构对称,容易加注意力和条件
- 局限:跳线要保存高分辨率特征,显存占用大;感受野受深度限制(常在瓶颈处加注意力)
- 适合的数据:输入输出都是网格、且空间对齐的稠密预测:分割、去噪、修复、深度估计、超分辨率、扩散模型的去噪;一维版本适合动作序列、时间序列的逐步输出
2.3.4 目标检测与实例分割
一句话
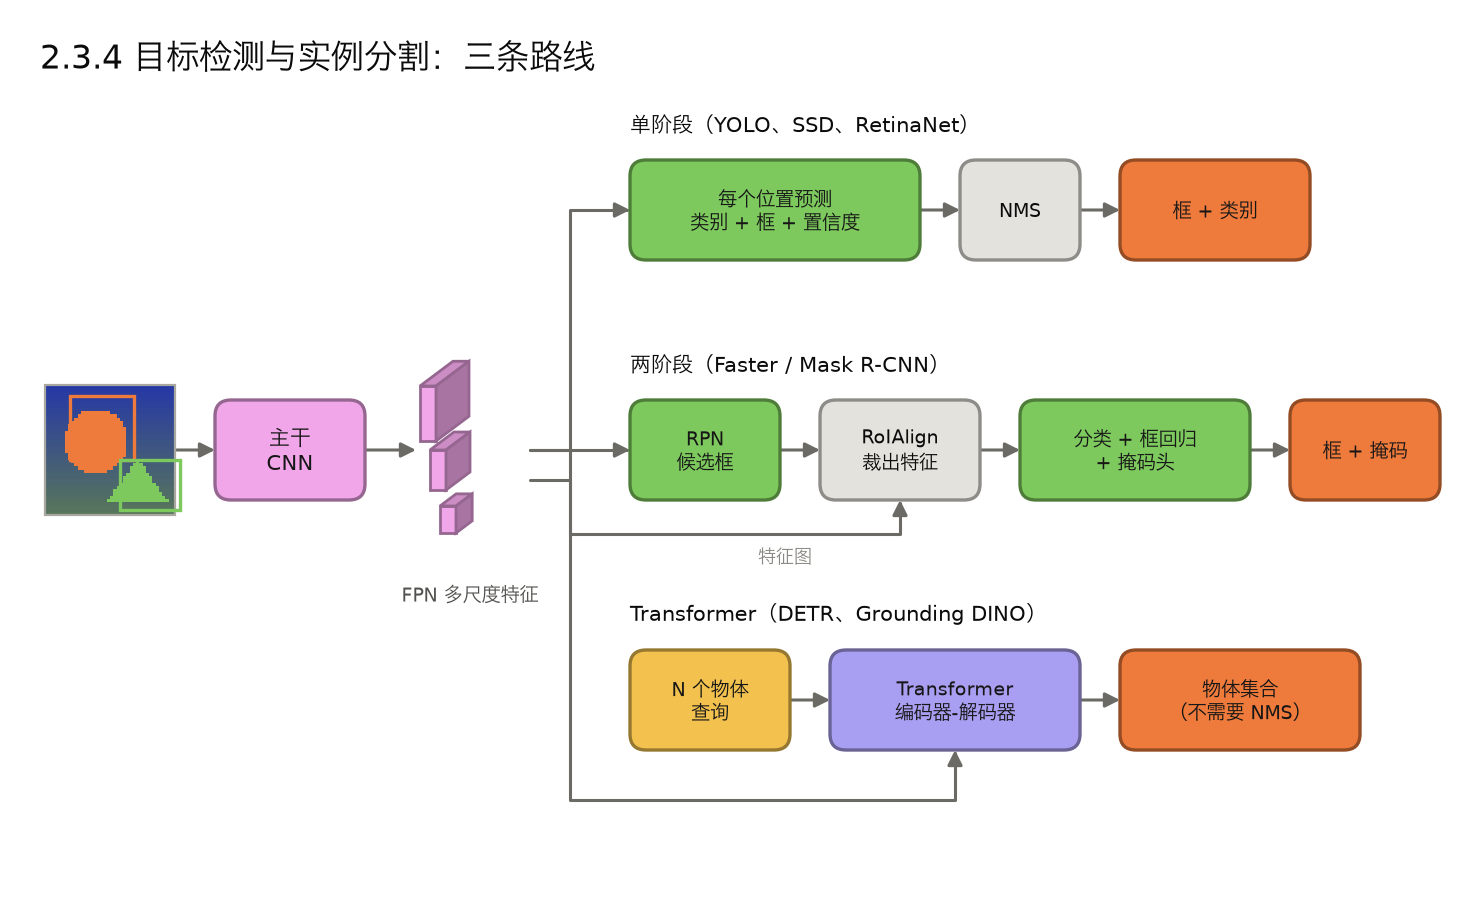
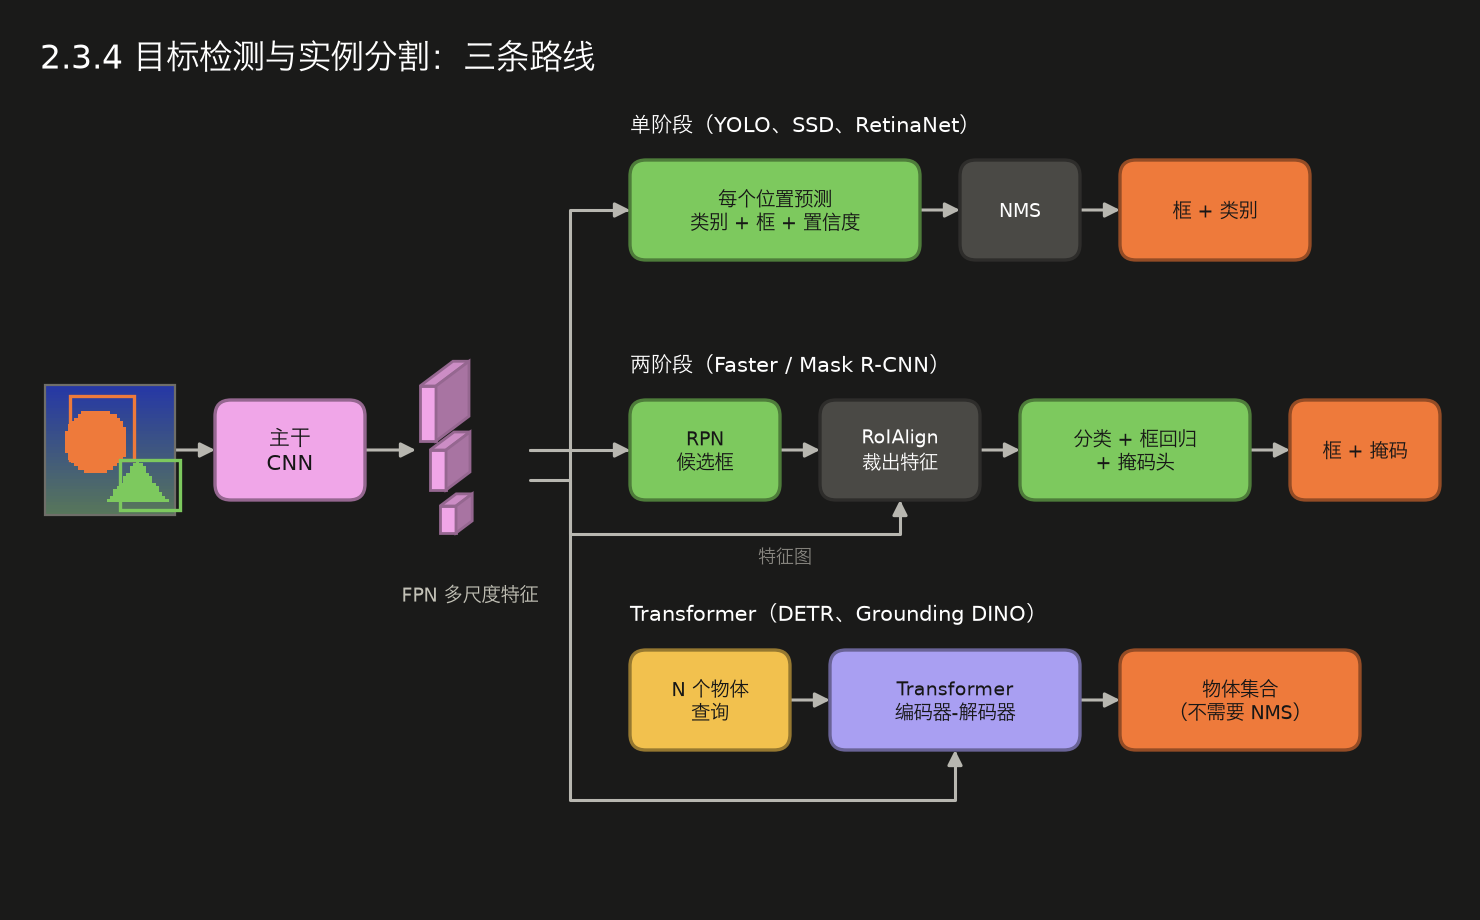
在卷积主干上接专门的头,同时预测「有哪些物体、各在哪个框里、是什么类别」,实例分割再给每个物体一张像素掩码。
任务区分
| 任务 | 输出 |
|---|---|
| 分类 | 整张图一个标签 |
| 目标检测 | 若干个框 + 每个框的类别和置信度 |
| 语义分割 | 每个像素一个类别,不区分同类的不同个体 |
| 实例分割 | 每个物体一个框 + 一张掩码 |
| 全景分割 | 语义分割 + 实例分割 |
两条路线
| 路线 | 做法 | 代表 |
|---|---|---|
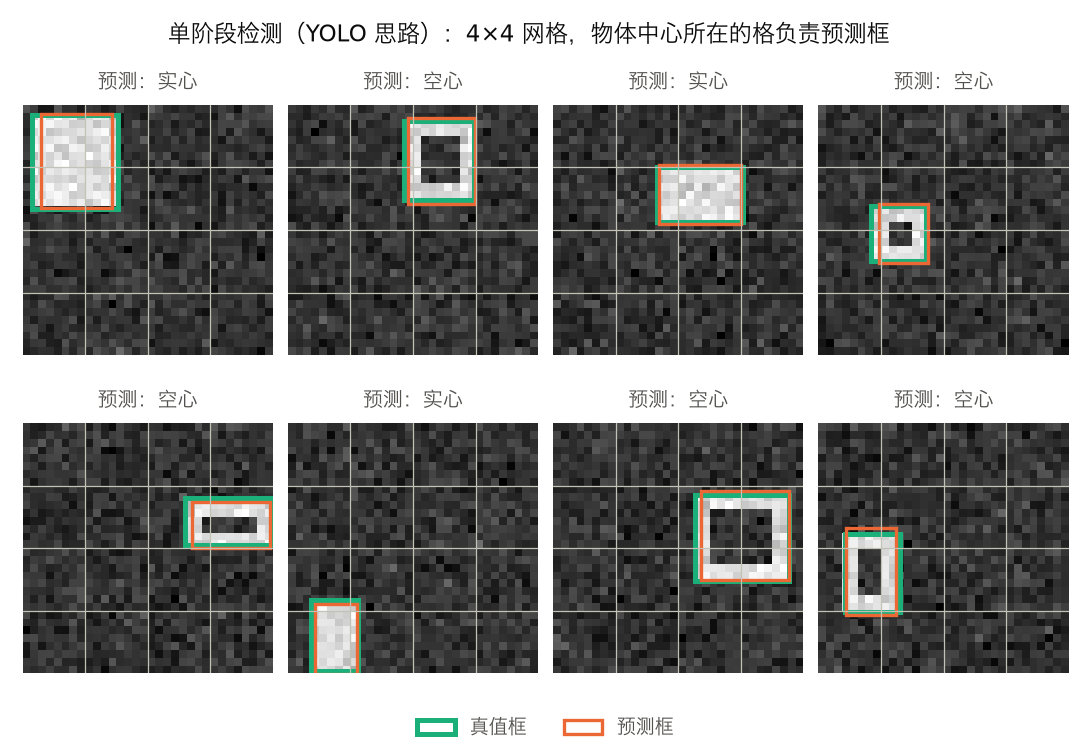
| 单阶段 | 在特征图的每个位置直接预测框和类别,一次前向出结果 | YOLO 系列(2016 至今)、SSD、RetinaNet(focal loss 解决前景背景极度不平衡)、FCOS / CenterNet(无锚框) |
| 两阶段 | 先给出可能有物体的候选框,再对每个候选框裁出特征精细分类和回归。R-CNN、Fast R-CNN 的候选框来自外部算法 Selective Search,Faster R-CNN 起改用网络内的区域提议网络(RPN) | R-CNN(2014)→ Fast R-CNN → Faster R-CNN(RPN)→ Mask R-CNN(加 RoIAlign 和掩码头) |
| Transformer | 用一组可学习的查询直接输出物体集合,训练时用匈牙利匹配,不需要非极大值抑制 | DETR(2020)、RT-DETR、Grounding DINO(开放词表,用文字指定要找什么) |
几个必备组件
- IoU(交并比):两个框交集面积 / 并集面积,衡量框准不准
- NMS(非极大值抑制):同一个物体会被预测出很多重叠的框,按置信度排序,保留最高的,删掉和它 IoU 超过阈值的,重复
- 锚框(anchor):在每个位置预设几种尺寸和长宽比的框,网络只预测相对锚框的偏移
- FPN(特征金字塔):把深层的语义特征上采样后与浅层特征融合,在多个分辨率上检测,兼顾大物体和小物体
- RoIAlign:从特征图上按候选框裁出固定大小的特征,用双线性插值避免取整误差,掩码因此更准
- mAP:先对每一类算平均精度(AP),再对所有类取平均,是检测的标准指标。PASCAL VOC 只用 IoU 阈值 0.5;COCO 的 AP 还要在 0.5 到 0.95 的 10 个 IoU 阈值上再平均
1 | import torch |
1 | import torch |
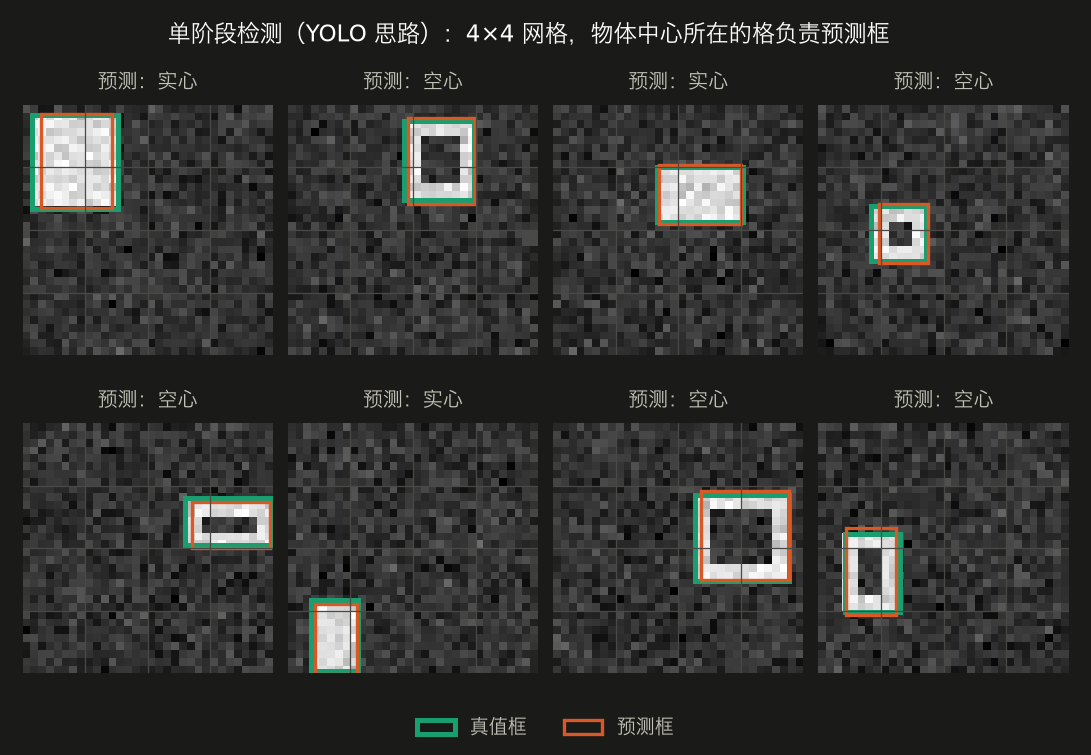
1 | import torch |
典型例子
- 自动驾驶感知:检测车辆、行人、交通标志
- 工业质检:在产线图像上框出缺陷;安防、零售货架识别
- YOLO 系列因为速度快,是边缘设备和实时视频上的常用选择
- 机器人抓取:先检测或分割出目标物体,再估计抓取位姿;SAM 一类的分割模型常用来给物体出掩码
- 开放词表检测(Grounding DINO):用一句话指定要找的物体,和语言指令天然对接
- 优势:同时给出「是什么」和「在哪里」;单阶段方法实时、两阶段方法精度高;COCO 预训练权重成熟,微调成本低
- 局限:需要框或掩码标注,标注贵;NMS 等后处理有超参;小物体、遮挡、密集场景仍难;类别集合固定(开放词表方法在补这个洞)
- 适合的数据:图像和视频中含有多个、位置不定的物体;需要定位或像素级轮廓的任务
2.3.5 TCN 与 WaveNet(因果膨胀卷积)
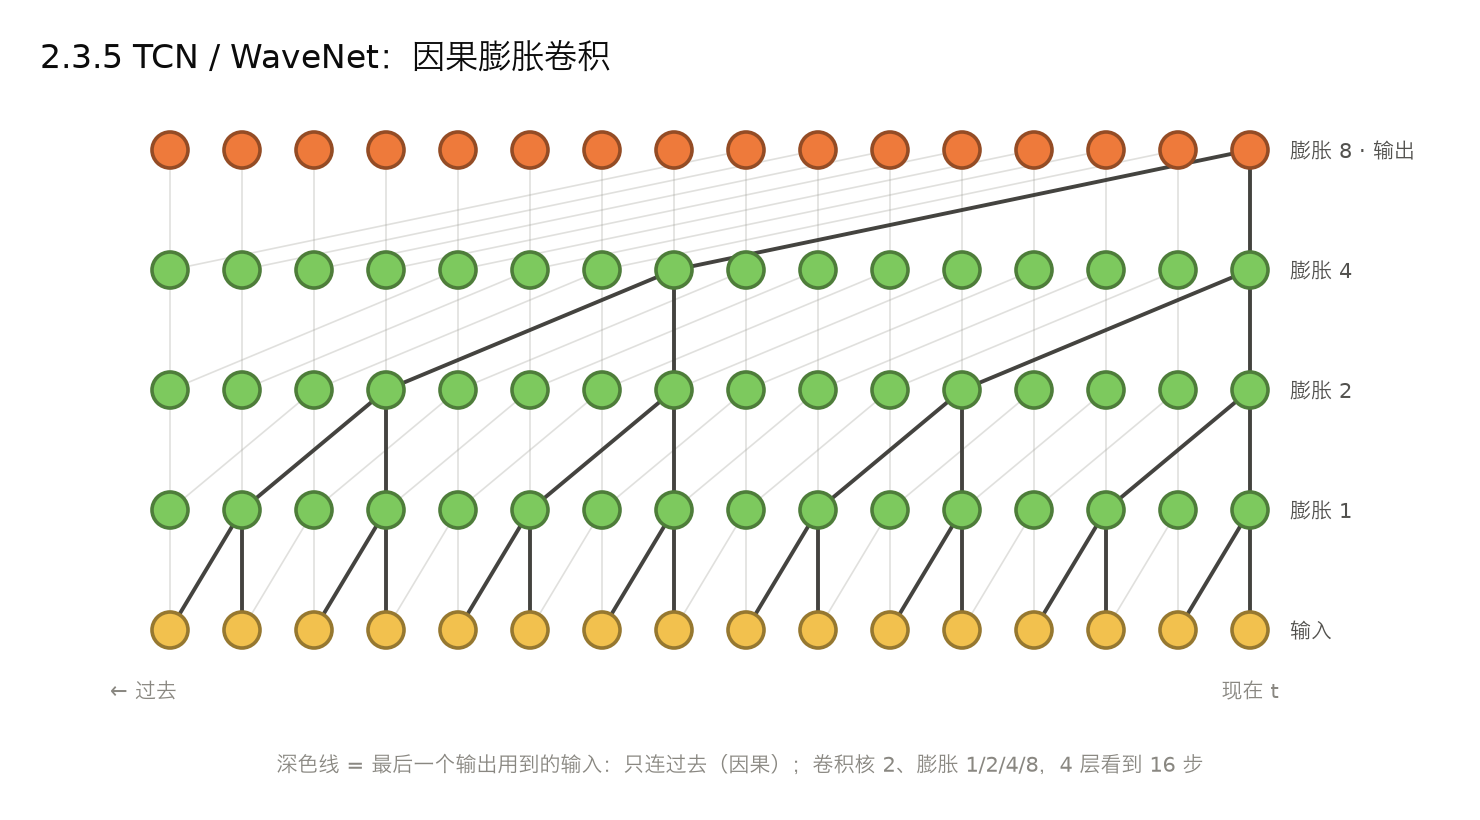
一句话
一维卷积只往过去看(因果),每层的膨胀率翻倍,感受野随层数指数增长;处理序列时训练可以完全并行。
因果卷积:只在序列左边补零,t 时刻的输出只依赖 ≤ t 的输入,不会偷看未来。
膨胀卷积:卷积核元素之间隔 d 个位置取值:
膨胀率逐层取 1, 2, 4, 8, …,L 层之后感受野是:
k = 3、10 层的感受野就有 2047 步。开头的架构图是 k = 2、4 层的情形,感受野 16。
WaveNet(2016):DeepMind 用因果膨胀卷积直接生成 16 kHz 的原始音频波形,每层用门控激活 tanh(·) ⊙ σ(·),大幅提升了语音合成的自然度。TCN(Bai 2018):把这套结构(加残差和 dropout)用于一般序列建模,在多个基准上和 LSTM/GRU 持平或更好。
1 | import torch |
典型例子
- 语音合成:WaveNet 2017 年起用于 Google Assistant 的语音
- 时间序列预测与分类:传感器数据、能耗、交通流量
- 动作分割:MS-TCN 把手术视频、做菜视频逐帧标注成动作阶段
- 机器人:力/力矩、IMU、触觉阵列等高频信号的编码,延迟固定、可以流式计算
- 优势:训练时所有时间步并行;梯度路径短而稳定(不像 RNN 沿时间连乘);感受野可以精确设计;推理延迟固定
- 局限:记忆长度被感受野硬性限制,超出范围的完全看不到;流式推理要缓存感受野内的历史;长程的、依赖内容的关系不如注意力灵活
- 适合的数据:一维时间序列与音频:传感器流(力、触觉、IMU)、语音波形、金融序列;需要严格因果、低延迟的在线预测
2.3.6 转置卷积网络 〔图:DN〕
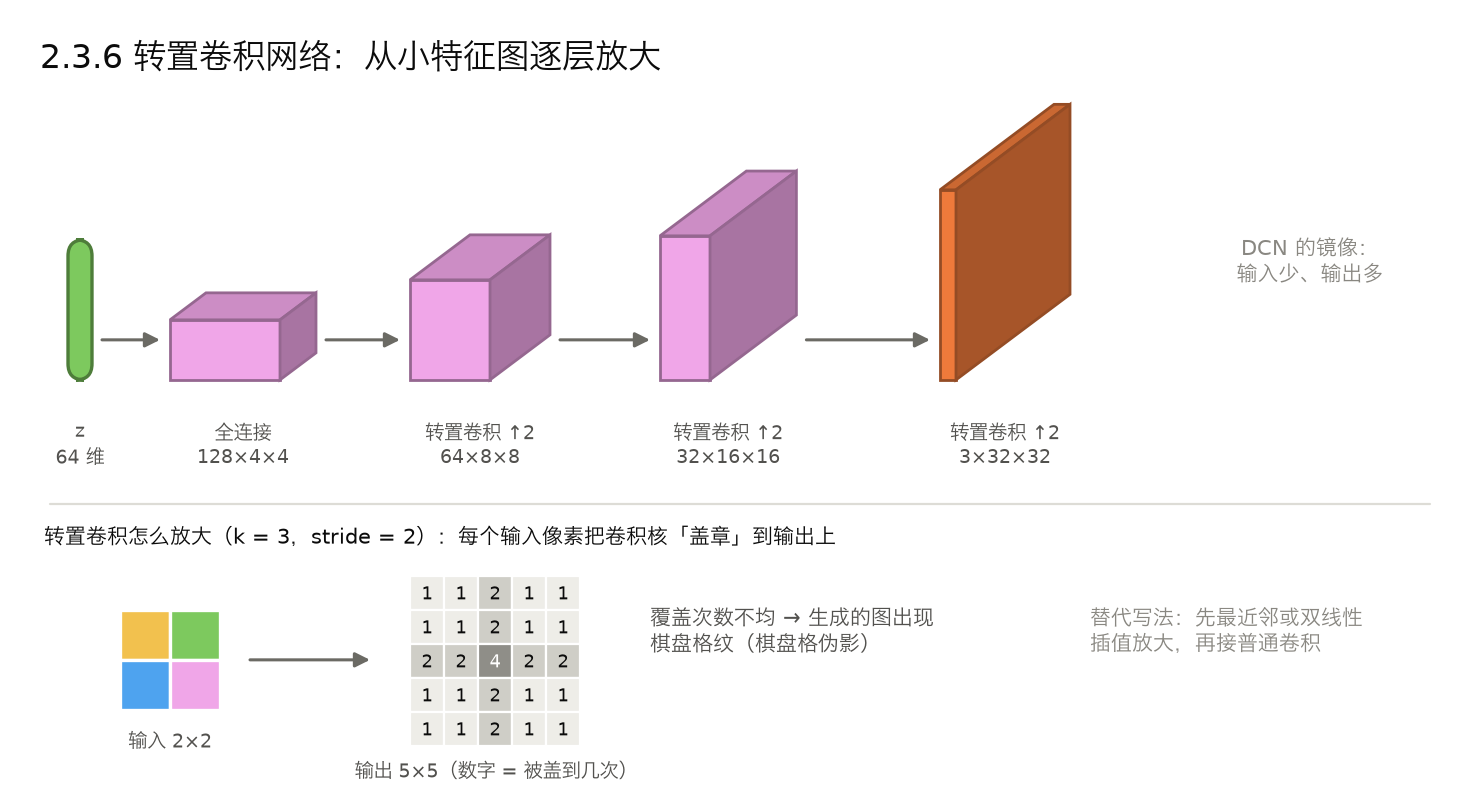
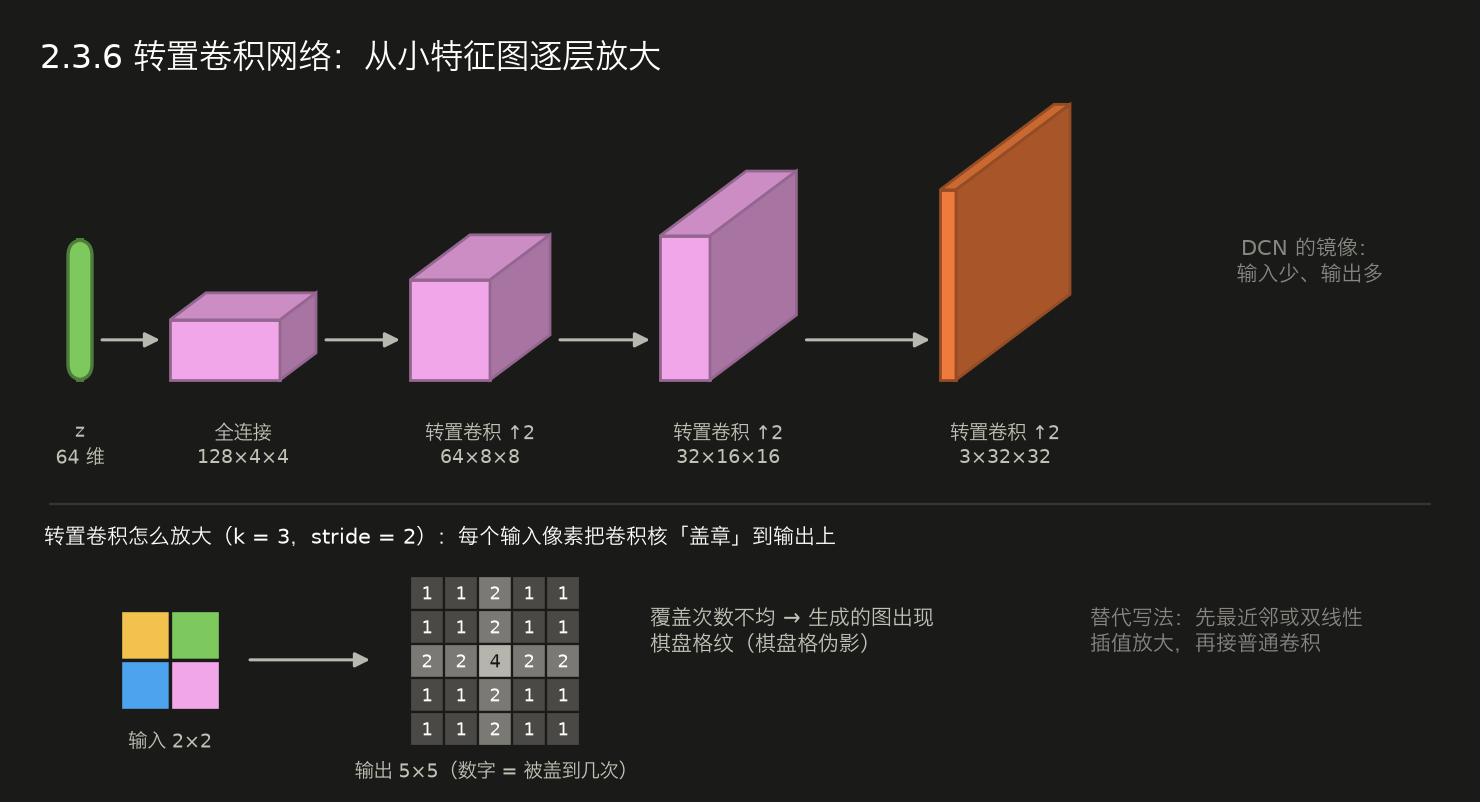
一句话
卷积网络倒过来用:从一个小特征图或向量出发,用转置卷积逐层放大分辨率,生成图像或掩码。
图中的 DN(Deconvolutional Network)就是 DCN 的镜像:输入很少,经过卷积核和池化单元逐层「展开」,输出很多。
「反卷积」只是个名字:它做的是转置卷积(也叫分数步长卷积),在数学上等于「普通卷积对输入求梯度」那个线性映射,并不能还原卷积之前的输入。名字来自 Zeiler 2010 / 2014 年的工作,他们用这类网络把卷积网络的中间特征映射回像素空间,看每个神经元在响应什么。
输出尺寸(不膨胀时;膨胀率为 d 时把 k 换成 d(k − 1) + 1):
棋盘格伪影:步长 2、卷积核 3 时,相邻输出像素被覆盖的次数不一样,生成的图像会出现格子纹。常见的替代写法是先最近邻或双线性插值放大,再接一个普通卷积。
1 | import torch |
典型例子
- DCGAN 的生成器:100 维噪声经四层转置卷积变成 64×64 图像
- 语义分割:FCN 用转置卷积把低分辨率的类别图放大回原图尺寸
- 自编码器、VAE 的图像解码器
- 可视化:Zeiler & Fergus(2014)用反卷积网络显示卷积网络各层神经元对应的图像模式
- 优势:可学习的上采样,能从低分辨率特征生成高分辨率输出;和卷积编码器对称,自然组成编码-解码结构
- 局限:棋盘格伪影;单独使用时缺少细节,通常需要 U-Net 那样的跳线
- 适合的数据:输出是网格数据的任务:图像生成、分割掩码、深度图、超分辨率、隐向量解码