神经网络训练
相关:深度学习与神经网络(含 PyTorch 代码的通用笔记)
0 训练在做什么
训练就是先定一个打分标准(损失函数),再沿着让分数变好的方向一小步一小步改参数(梯度下降);每一步往哪改,用反向传播来算。 基础版梯度下降会遇到两类问题:一类是走得不好(慢、卡住、步子不合适),另一类是学得太死(背住了训练数据,换数据就不行)。本笔记后半部分都在处理这两类问题。
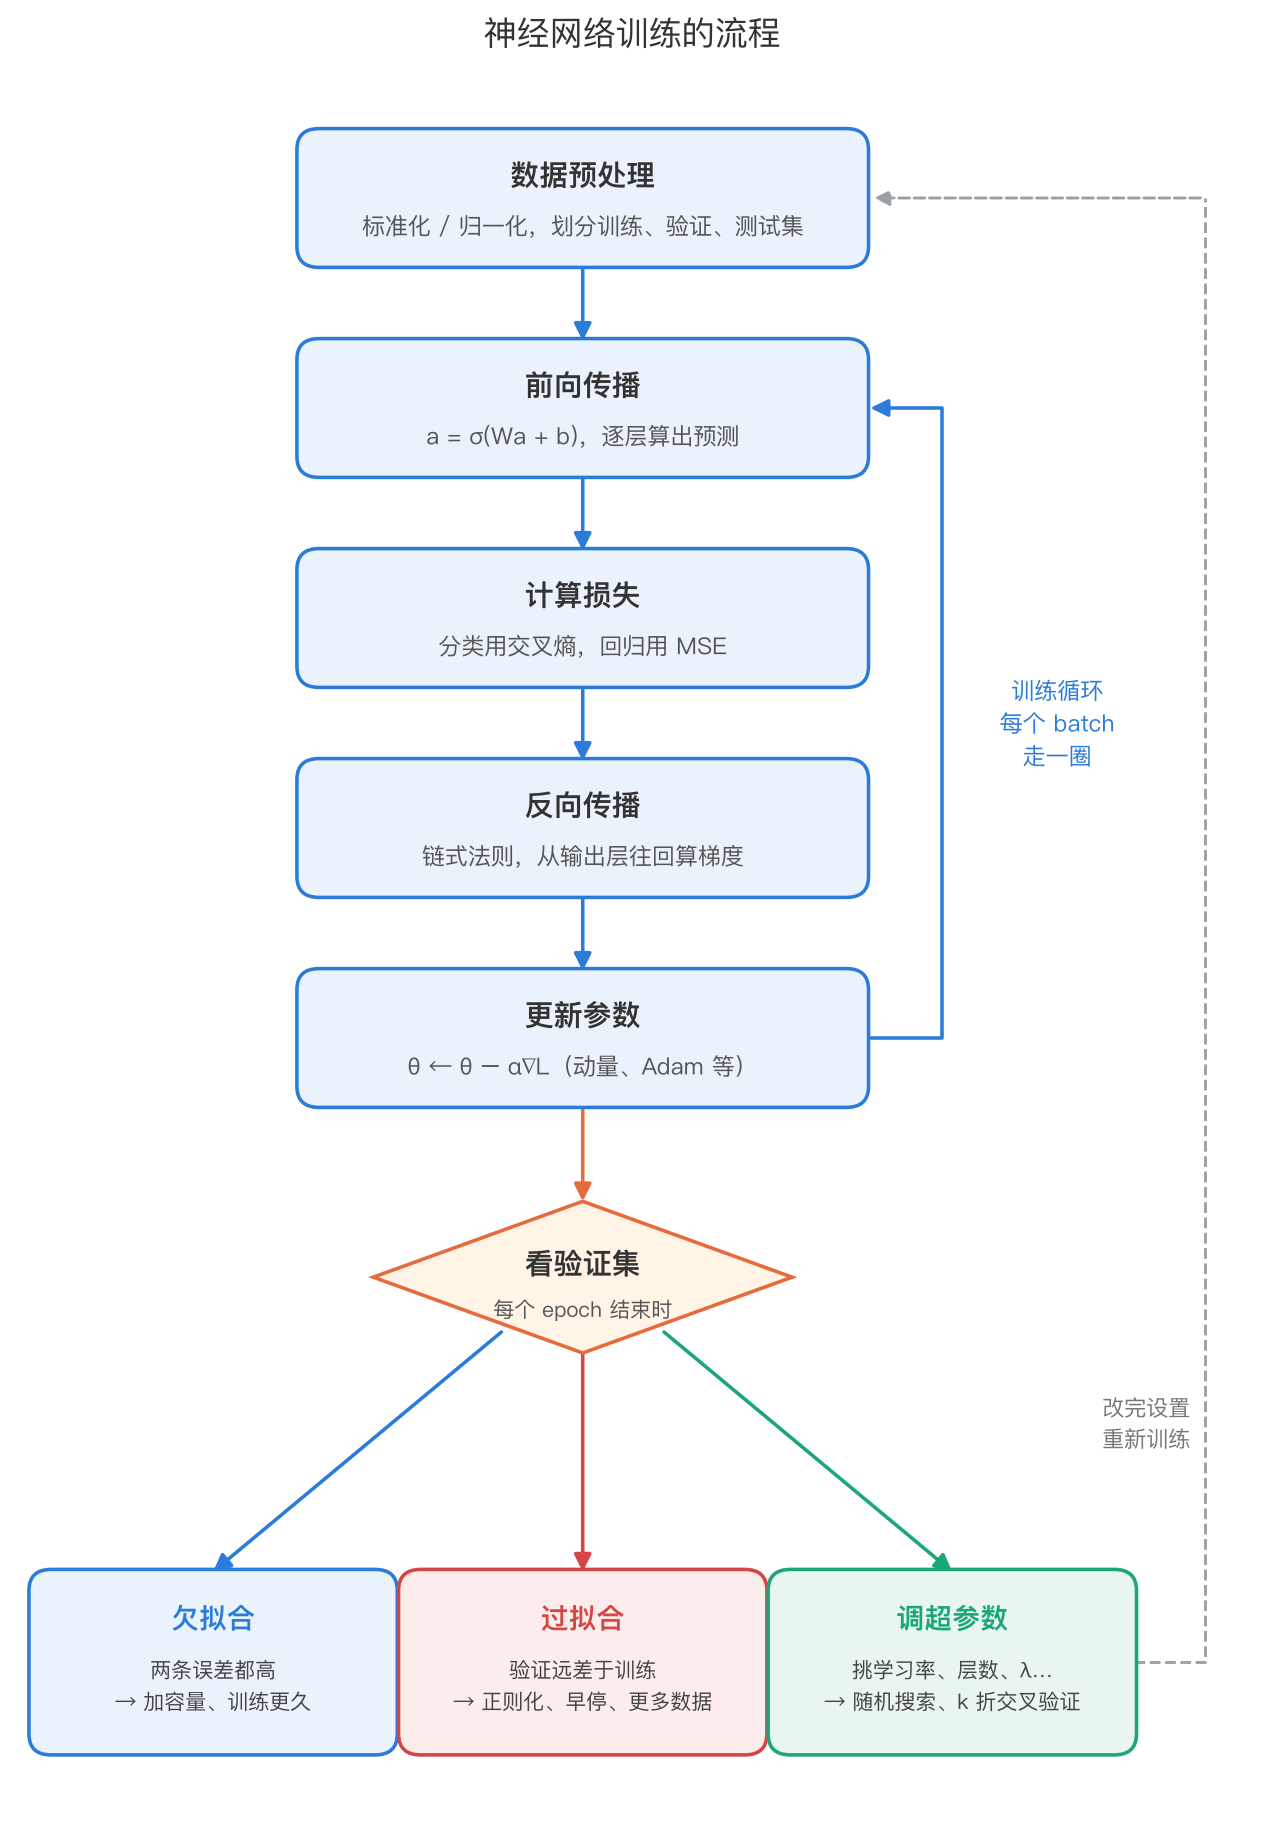
| 节 | 内容 |
|---|---|
| 1 | 网络怎么算出输出 |
| 2 | softmax、sigmoid、tanh、ReLU 系列,激活放在哪 |
| 3 | 参数、预处理、one-hot、交叉熵、MSE |
| 4 | 更新规则、链式法则、mini-batch |
| 5 | 平台与鞍点、动量、Adam、学习率与调度 |
| 6 | 成因与对策 |
| 7 | 症状、对策、验证集与测试集、网络大小 |
| 8 | L2、L1、dropout、早停、BatchNorm |
| 9 | 超参数清单、搜索方法、k 折交叉验证 |
| 10 | 全文浓缩 |
图都是用 Python 现做的;标「实测」的来自真实跑过的小实验(NumPy),设置写在图下。
1 前向传播
1.1 网络就是一个函数
以手写数字识别为例:16 × 16 = 256 个像素输入,10 个输出对应 0–9,网络就是一个函数 f: ℝ²⁵⁶ → ℝ¹⁰。训练的目标是让输入一张「2」时第 2 个输出最大。
输入和输出之间的层叫隐藏层。每层的每个神经元连着下一层的每个神经元,叫全连接,这样的网络叫多层感知机(MLP)。
1.2 逐层计算
每一层做同一件事:矩阵乘向量,加偏置,过激活函数。
整个网络是一个嵌套函数:
- W 的形状 = 本层神经元数 × 上一层输出数,第 i 行是第 i 个神经元的权重
- 一层的参数数 = 输入数 × 输出数 + 输出数(每个神经元一个偏置)
- 写成矩阵后,整个计算就是一串矩阵乘法,GPU 正擅长这个
一个三层小例子(输入 [1, −1],激活函数都是 sigmoid):
| 层 | W | b | 激活前 z | 输出 a |
|---|---|---|---|---|
| 1 | [[1, −2], [−1, 1]] | [1, 0] | [4, −2] | [0.98, 0.12] |
| 2 | [[2, −1], [−2, −1]] | [0, 0] | [1.84, −2.08] | [0.86, 0.11] |
| 3 | [[3, −1], [−1, 4]] | [−2, 2] | [0.47, 1.58] | [0.62, 0.83] |
手算时每层写出 z 和 a 两行,方便检查。
层与层之间别忘了激活函数
去掉每层的 σ,所有 W 相乘还是一个矩阵,整个网络退化成一层线性函数,叠多少层都没用。
1.3 层数的叫法
| 叫法 | 结构 |
|---|---|
| 2 层网络 = 1 个隐藏层 = single-hidden-layer | 输入 → 隐藏层 → 输出层 |
| 3 层网络 = 2 个隐藏层 | 输入 → 隐藏层 1 → 隐藏层 2 → 输出层 |
数层数不算输入层。输入只是信号进来的地方,不做任何运算;有权重、偏置和激活的才算一层神经元。
2 输出层与激活函数
2.1 softmax
多分类的输出层用 softmax。sigmoid 给每类各自打分,输出加起来不等于 1;softmax 让各类共享同一个总量 1。输入 softmax 的 z 叫 logits。
两步:先取指数(都变正数,差距放大),再除以总和(变成占比)。
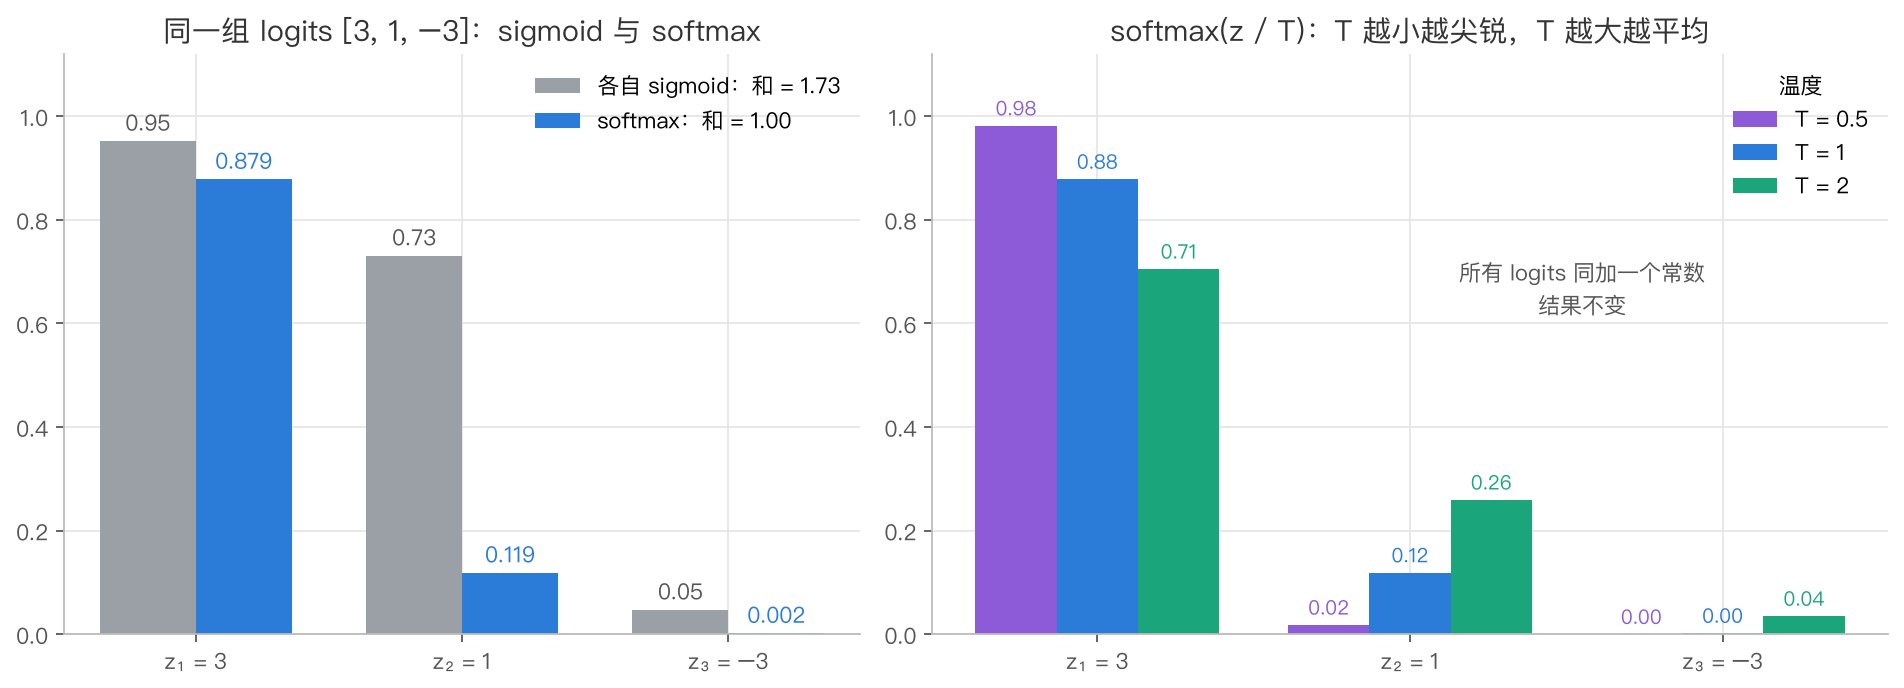
- 例:logits [3, 1, −3],e^z ≈ [20.09, 2.72, 0.05],和为 22.85,输出 ≈ [0.879, 0.119, 0.002]
- 有些 logit 为 0 时,e⁰ = 1 也要加进分母。比如 [3, 1, −3] 再加 7 个 0,分母变成 29.85,p₁ 从 0.879 降到 0.673
- 所有 logits 同加一个常数,结果不变(分子分母同乘 e^c)。实现时先减去最大值,防止指数溢出
- softmax 不改变大小顺序,logit 最大的类概率也最大
- 温度 T:用 z / T 代替 z。T 越小分布越尖锐,T 越大越平均
- 二分类可以只用一个 sigmoid 输出:它表示 P(类 1),P(类 0) = 1 − 它
softmax 输出算不算概率
它满足概率的形式(每个在 0–1 之间、加起来为 1),可以当作各类的概率来用。但只有模型训练得足够好时,它才接近真实的后验概率;实际网络常常过度自信,这是「校准」问题。
2.2 激活函数
| 激活 | 公式 | 值域 | 导数 | 优点 | 问题 |
|---|---|---|---|---|---|
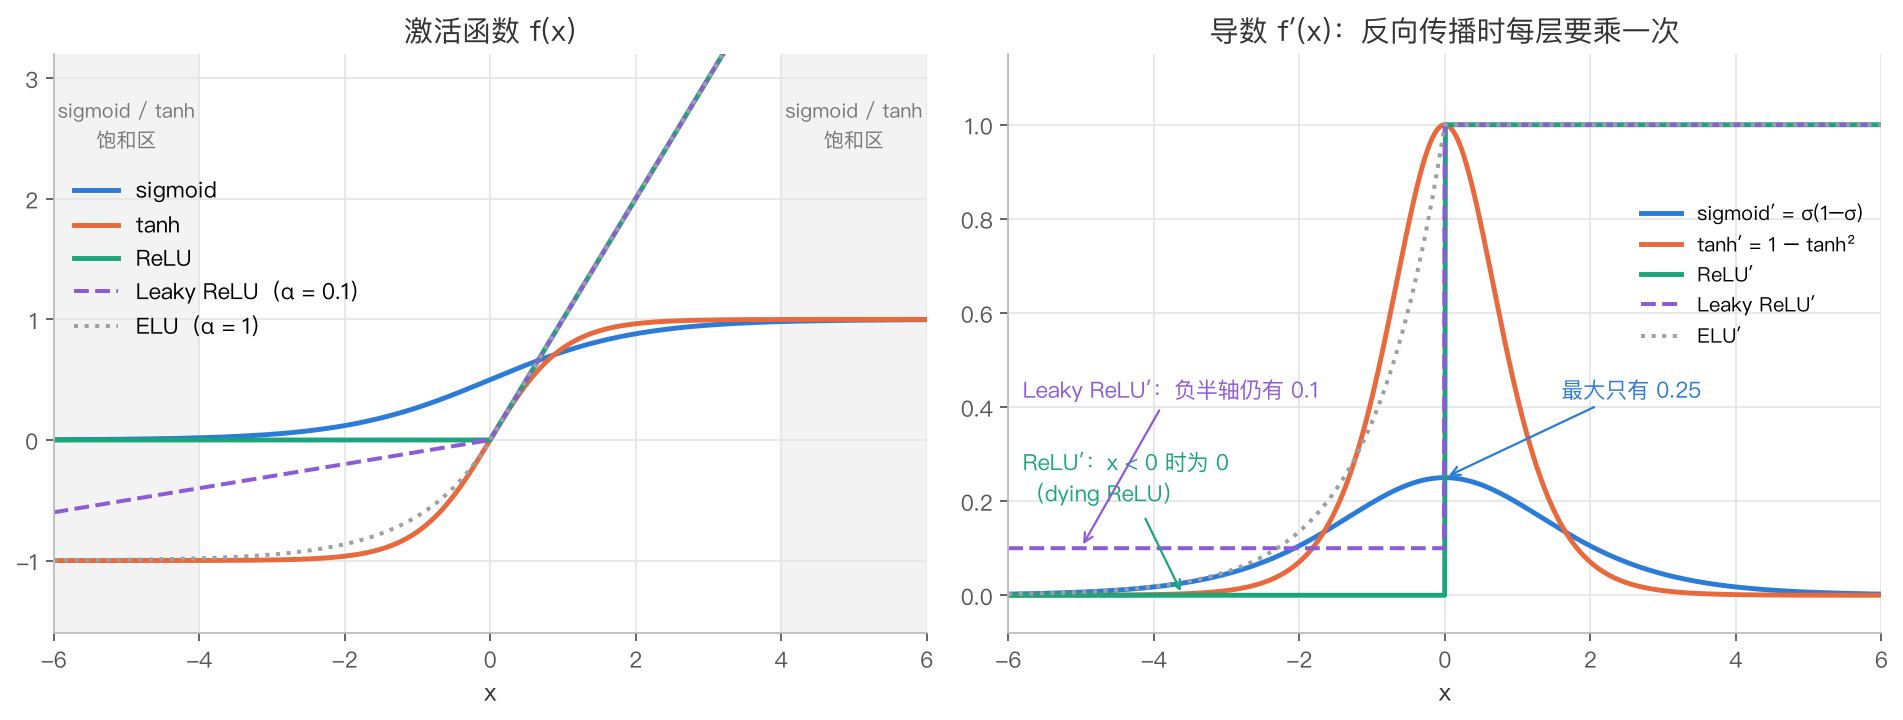
| sigmoid | 1 / (1 + e⁻ˣ) | (0, 1) | σ(1 − σ),最大 0.25 | 像生物神经元的放电率 | 两端饱和 → 梯度消失;要算指数 |
| tanh | 2σ(2x) − 1 | (−1, 1) | 1 − tanh²,最大 1 | 以 0 为中心 | 两端照样饱和 |
| ReLU | max(0, x) | [0, ∞) | x > 0 为 1,x < 0 为 0 | 计算快、正半轴不饱和、缓解梯度消失 | dying ReLU |
| Leaky ReLU | x ≥ 0 为 x,x < 0 为 αx | ℝ | 1 或 α | 负半轴有梯度 | 多一个超参数 α |
| ELU | x ≥ 0 为 x,x < 0 为 α(eˣ − 1) | (−α, ∞) | 两侧都不为 0 | 没有 dying ReLU | 要算指数 |
| Maxout | max(w₁ᵀx + b₁, w₂ᵀx + b₂) | ℝ | — | ReLU 是它的特例 | 参数翻倍 |
| 线性 | cx | ℝ | c | 回归的输出层 | 放在隐藏层会让网络退化 |
- 饱和:输出接近两端时曲线几乎平了,导数接近 0,梯度传不过去
- 以 0 为中心为什么好:sigmoid 输出全为正,下一层所有权重的梯度符号相同,只能一起增大或一起减小,路线走成锯齿
- dying ReLU:某次更新让偏置变得很负,所有输入的加权和都小于 0,输出和导数恒为 0,这个神经元的权重再也不更新。学习率太大时容易出现
- ReLU 只是缓解梯度消失:负半轴导数为 0,很深的网络照样可能出问题
- 现在的深度网络默认用 ReLU;学习率合适时 dying ReLU 一般可以避免
怎么判断一个函数能不能当激活函数:看它是不是非线性。分段函数要拆开看,比如「x ≥ 0 时 max(x, 0.1x),否则 min(x, 0.1x)」两段其实都是 x,整体是直线,不能用;min(x, 0.1x) 在 0 处有折点,可以用。
2.3 激活函数放在哪
| 任务 | 隐藏层 | 输出层 |
|---|---|---|
| 多分类 | 非线性(ReLU 等) | K 个神经元 + softmax |
| 二分类 | 非线性 | 1 个 sigmoid |
| 回归 / 函数逼近 | 非线性 | 线性,输出任意实数 |
隐藏层任何时候都不能全用线性;分类任务的输出层也不用线性。
3 损失函数
3.1 参数
参数 θ = 所有层的权重矩阵和偏置向量,常统称「权重」。它们由训练学出来;学习率、层数这类训练前就要定好的设置叫超参数(见 9.1 参数 vs 超参数)。
3.2 数据预处理
- 标准化后每个特征均值 0、标准差 1;归一化后落在 [0, 1]。图像像素 ÷ 255 是最常见的归一化
- 为什么有用:特征尺度差很多时,损失的等高线被拉成细长椭圆,梯度下降在窄谷里来回振荡;数值太大还会让 sigmoid、tanh 一开始就饱和
- 均值和标准差只能用训练集算,验证集、测试集沿用同一组数
3.3 分类的目标写法
- K 个类用 K 个输出神经元
- 第 k 类的目标是 one-hot:只有第 k 个为 1,其余为 0
- 预测时哪个输出最大,就判为哪一类
- 理论上,用交叉熵或 MSE 训练到全局最优时,输出逼近后验概率 P(类 k | x),取最大就是错误率最小的贝叶斯决策。实际只能到局部最优,所以这只是一个理想情况
3.4 交叉熵、BCE、MSE
二分类(1 个 sigmoid 输出)→ 二元交叉熵 BCE:
多分类(softmax + one-hot)→ 类别交叉熵,只剩真实类那一项:
回归 → 均方误差 MSE:
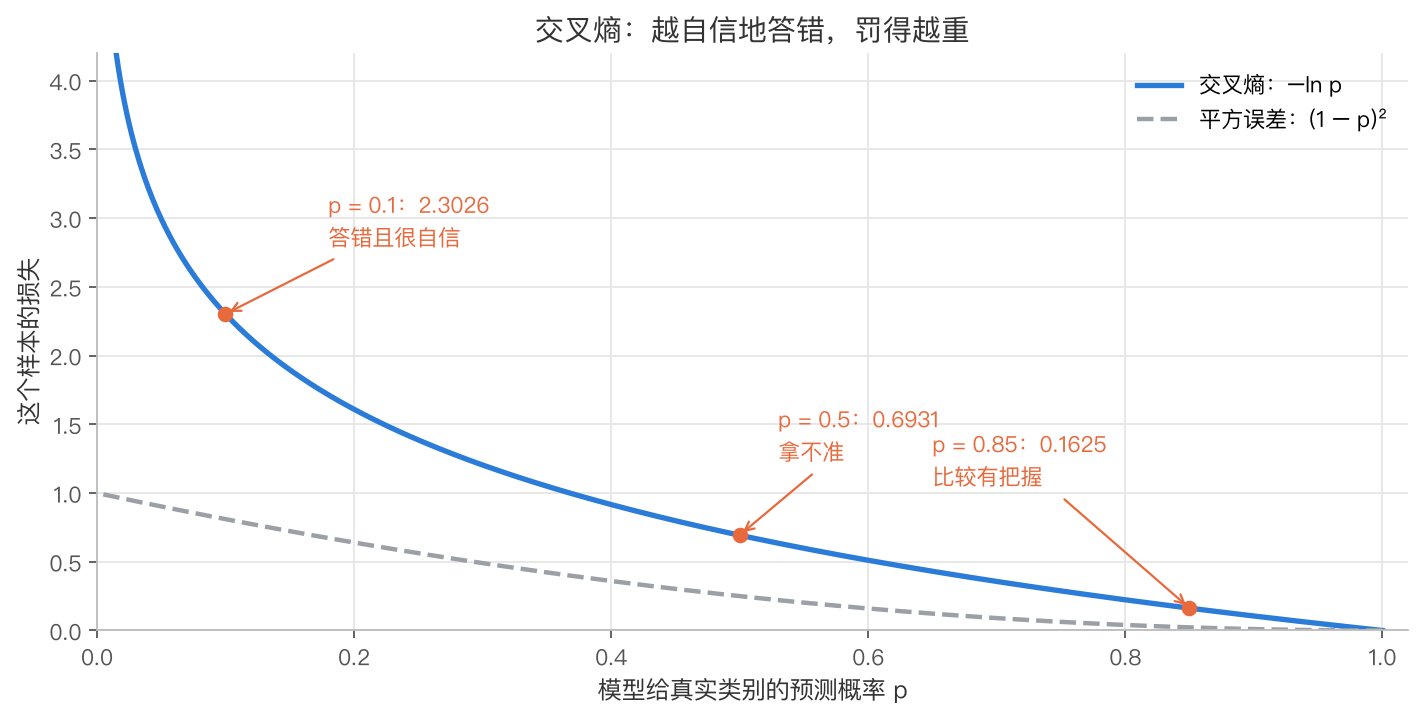
- 例:真实标签 1、预测 0.85,BCE = −ln 0.85 ≈ 0.1625
- 交叉熵的直觉:正确答案你给了多大把握?给 0.9 罚 0.105,给 0.1 罚 2.303,给 0.01 罚 4.6。越自信地答错,罚得越重
- 把「每个类都加 (1 − y)log(1 − ŷ)」的写法用在 softmax 多分类上是不对的,那是多标签(每类独立 sigmoid)的损失
- 交叉熵 = 负对数似然,所以最小化交叉熵就是最大似然估计(MLE);再加 L2 正则就是 MAP(见 8.1 L2 正则)
- 目标函数(objective)一般指要最大化的量,代价函数(cost)指要最小化的量,两者差一个负号;loss 和 cost 通常混用
框架里的交叉熵要喂 logits
PyTorch 的 cross_entropy 内部会先做 softmax,输入应该是 logits。先自己做 softmax 再喂进去,等于做了两次,损失数值会错。
3.5 训练误差为 0 并非目标
真正要的是在没见过的数据上表现好。训练误差可以靠「把每个训练点单独记住」降到 0,但那只是背答案,换一个稍有不同的输入就错。训练损失要小,但追求到 0 往往意味着过拟合(见 7 泛化:欠拟合与过拟合)。
4 梯度下降与反向传播
4.1 梯度下降
梯度指向损失上升最快的方向,所以沿负梯度走。像蒙着眼下山:用脚感觉哪边最陡,往下坡迈一步,再感觉、再迈。学习率就是一步迈多大。
- 随机初始化 θ⁰
- 计算当前位置的梯度 ∇L(θ)
- 更新:
- 重复 2–3,直到满足终止条件
例:w = 0.04,∂L/∂w = 0.45,学习率 0.1 → w = 0.04 − 0.045 = −0.005。
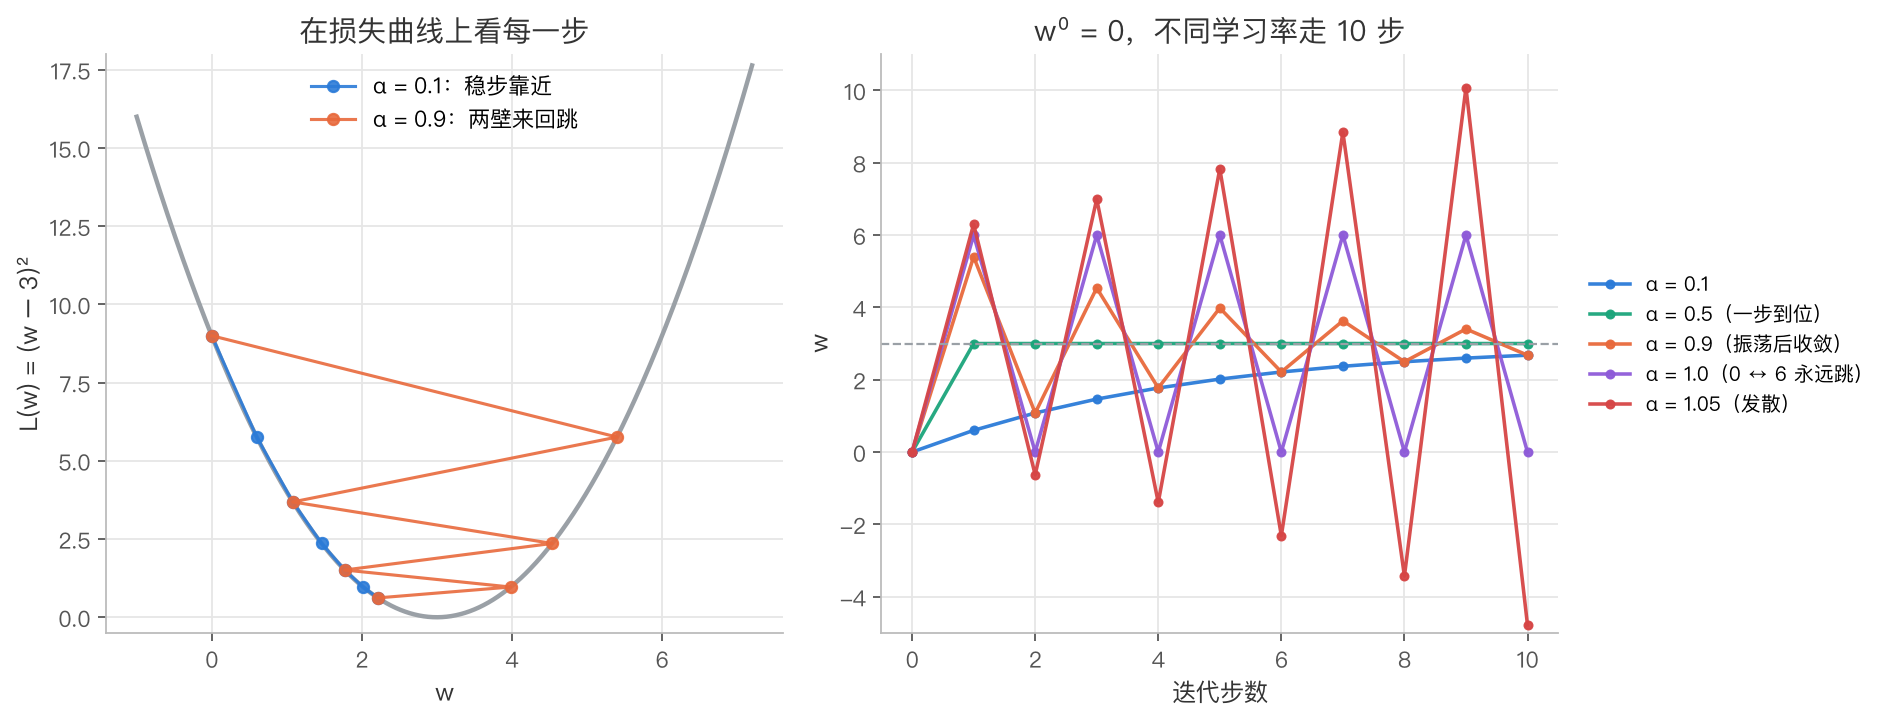
图里 L(w) = (w − 3)²,梯度是 2(w − 3),每步 w ← w − 2α(w − 3),离最小值的距离每步乘 (1 − 2α):α = 0.5 时恰好为 0,一步到位;α = 1 时为 −1,永远在 0 和 6 之间跳;α > 1 时绝对值大于 1,发散。
4.2 局部最小、非凸
- 梯度下降在局部最小停下,不保证全局最小;但经验上对神经网络效果很好
- 损失曲面高度非凸;每次随机初始化起点不同,会到不同的极小值,同一网络训练两次结果可能不同
- 目前没有算法能保证对任意损失函数找到全局最小(EM 算法也有同样的性质)
4.3 反向传播
- 前向传播:输入经过各层得到输出,再算损失。这一步不算梯度
- 反向传播:从输出往输入方向,用链式法则逐层算损失对各参数的偏导。下层的梯度要用到上层已经算好的那一串导数,所以从后往前算
- 先把所有参数的梯度都算完,再统一更新(PyTorch 里先
loss.backward()再optimizer.step()) - 每更新一次 = 一次前向 + 一次反向(对一个 batch)
- 深度学习框架都能自动求导,不用手推
最简单的例子:单个 sigmoid 神经元 + BCE,z = wx + b,ŷ = σ(z)
同理 ∂L/∂b = ŷ − y。「sigmoid + 交叉熵」和「softmax + 交叉熵」对 logits 的梯度都是「预测 − 标签」,所以它们是标准搭配。
4.4 batch、mini-batch、SGD
| 每次更新用多少样本 | 每步速度 | 梯度噪声 | 用得多吗 | |
|---|---|---|---|---|
| 批量 GD | 全部 N 个 | 慢 | 无 | 大数据集上基本不用 |
| mini-batch GD | 32–256 个 | 快 | 中等 | 最常用 |
| SGD(严格意义) | 1 个 | 最快 | 大,损失剧烈波动 | 较少 |
- mini-batch 可行,是因为一小批的梯度已经能很好地近似全体的梯度,像民意调查只问 1000 人
- epoch = 所有训练数据用过一遍;每个 epoch 的更新次数 = ⌈N / batch 大小⌉。例:60000 张图、batch 64 → 每 epoch 938 次
- 每个 epoch 开始前打乱数据
- 框架里说的 SGD 通常指 mini-batch GD(可带动量)
- 梯度带点噪声不全是坏事,有时能帮参数跳出平台和浅的局部最小
5 优化:动量、Adam、学习率
5.1 平台、鞍点、局部最小
| 位置 | 梯度 | 结果 |
|---|---|---|
| 平台(plateau) | ≈ 0 | 很慢 |
| 鞍点(saddle point) | = 0 | 卡住 |
| 局部最小 | = 0 | 卡住 |
- 鞍点像马鞍中心:一个方向往上翘,另一个方向往下掉,正中间坡度为 0
- 高维里鞍点比局部最小更常见:要成为局部最小,几百万个方向都得往上翘
实测设置
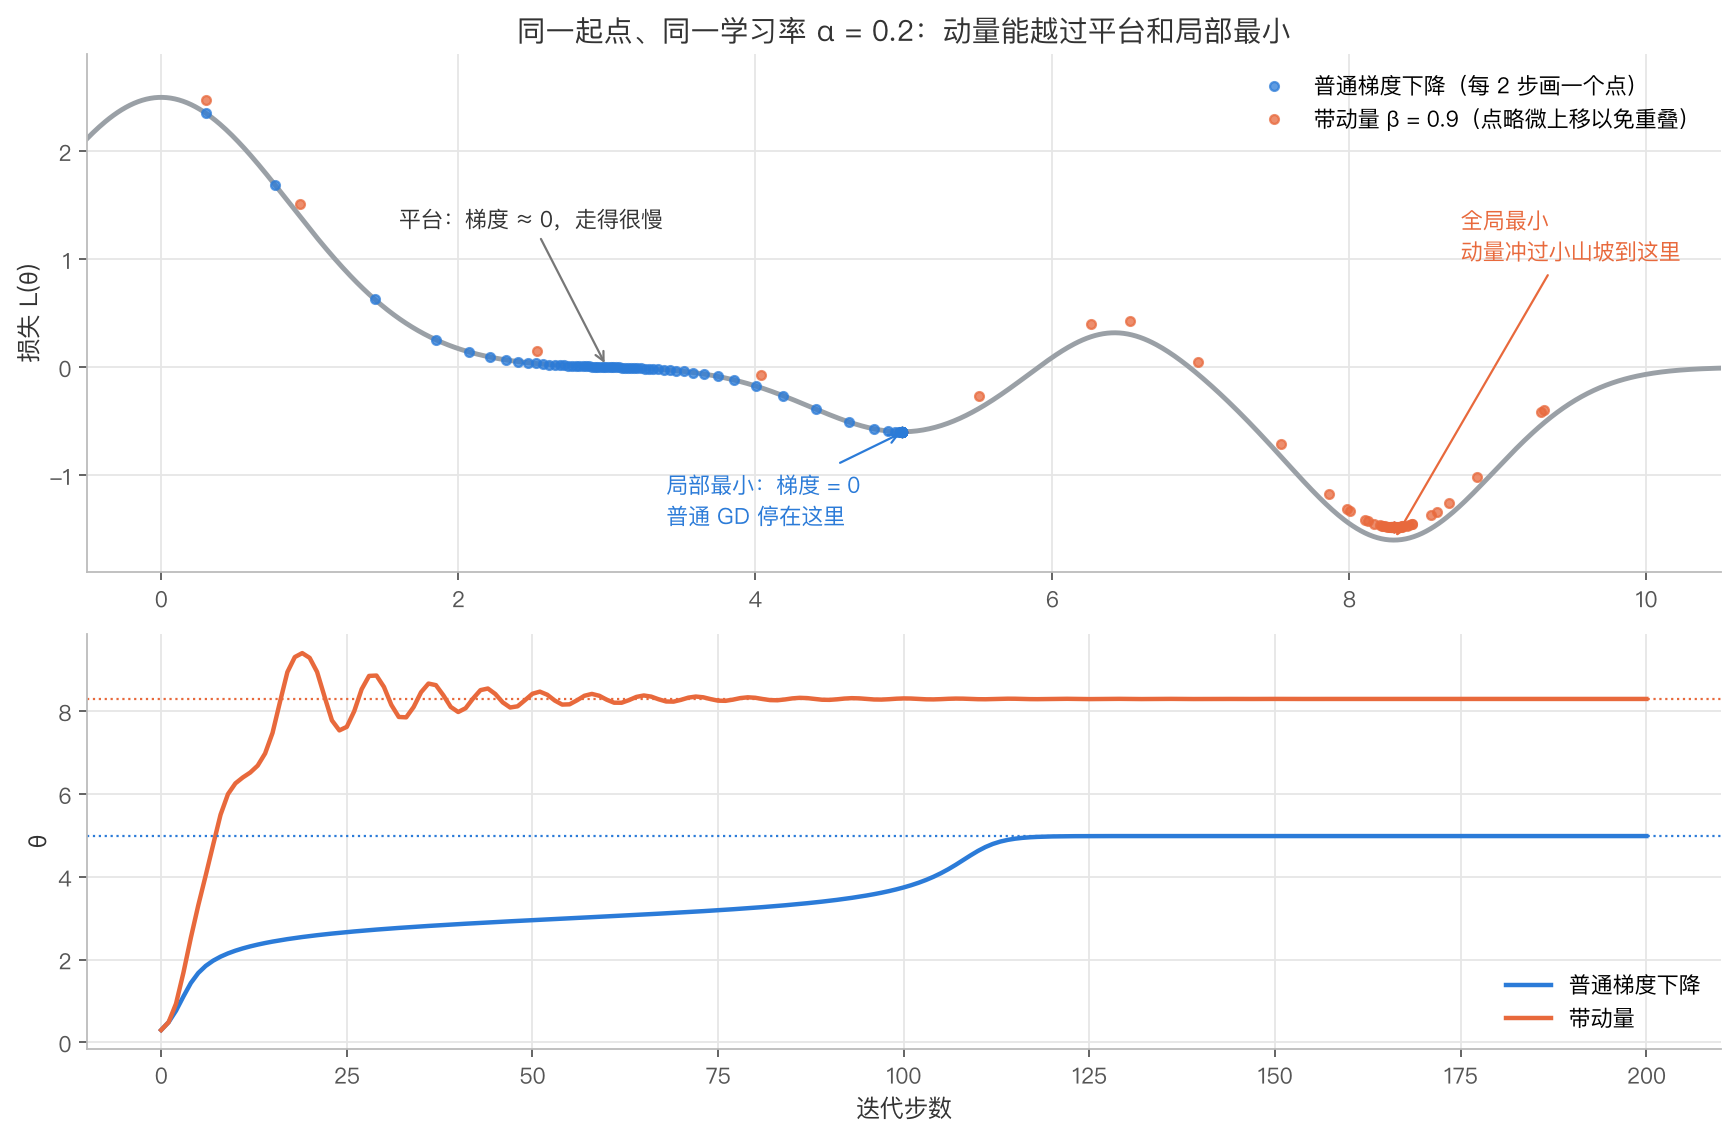
一维损失由几个高斯凸起叠成;起点 θ = 0.3,学习率 α = 0.2,各走 200 步,动量 β = 0.9。普通 GD 在平台上挪了约 100 步,最后停在局部最小 θ ≈ 5;动量越过小山坡,停在全局最小 θ ≈ 8.3。
越过局部最小不是必然的:同一个函数把 α 改成 0.1,两种方法都停在局部最小。
5.2 动量
实际移动 = 负梯度 + 之前积累的速度:
- v 是「速度」,β 常取 0.9;β = 0 时退化成普通梯度下降
- 像一个有惯性的球:平台上越滚越快;梯度为 0 时靠惯性冲过鞍点和浅坑;窄谷里左右方向的梯度一正一负互相抵消,沿谷底方向的一致累加
- 代价:惯性会冲过头,在最小值附近来回晃
- 例:L(w) = (w − 3)²,w⁰ = 0,α = 0.1。普通 GD 两步到 1.08;动量 β = 0.9 时 v¹ = 0.6、w¹ = 0.6,v² = 0.54 + 0.48 = 1.02、w² = 1.62
- Nesterov 动量:先按动量预判下一步到哪,在预判位置算梯度,能更早刹车
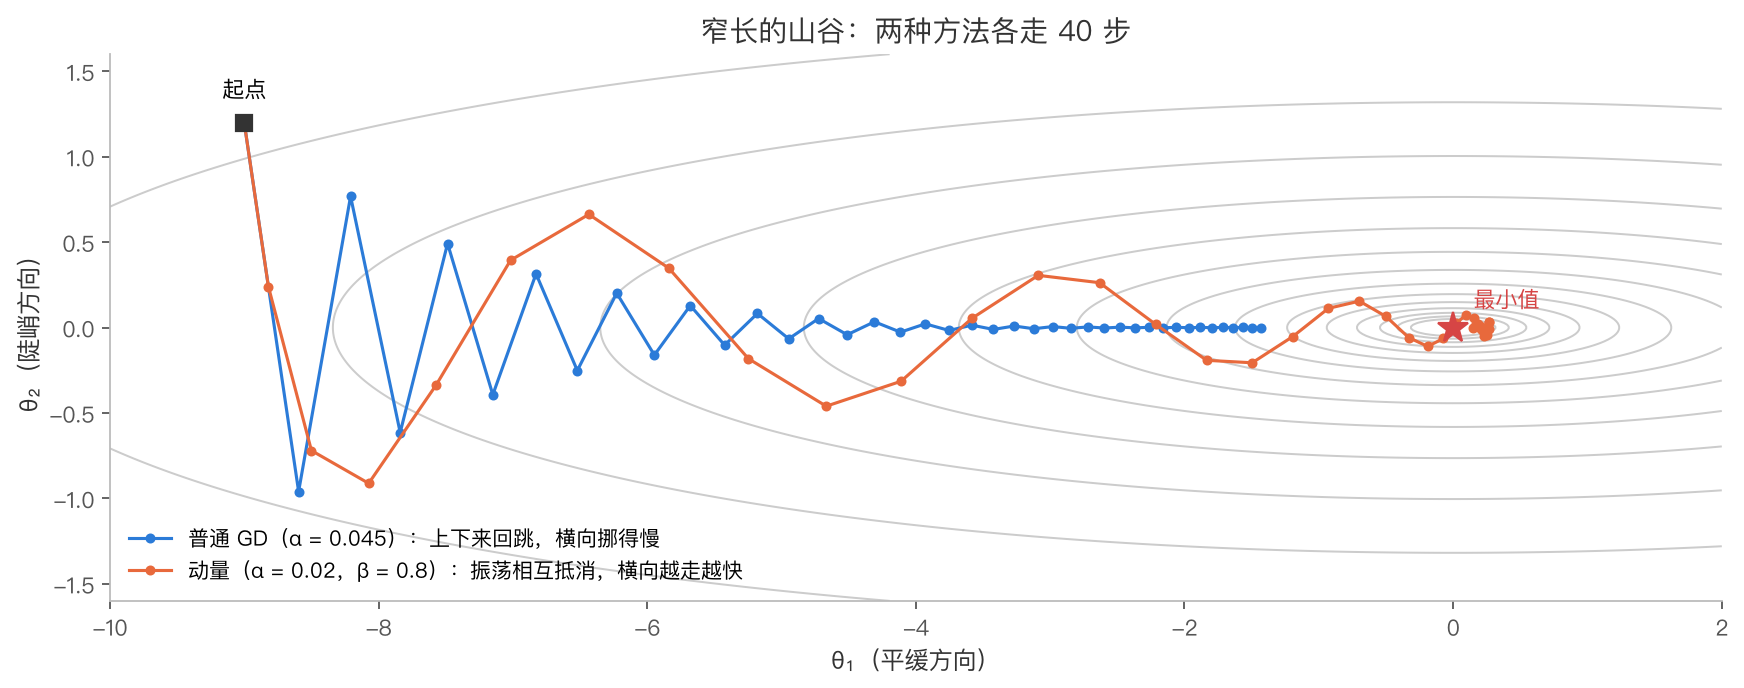
实测设置
L = ½(θ₁² + 40θ₂²),起点 (−9, 1.2),各走 40 步。普通 GD(α = 0.045)结束时 θ₁ ≈ −1.43;动量(α = 0.02,β = 0.8)结束时 θ₁ ≈ 0.15。
5.3 Adam
- 一阶矩:过去梯度的加权平均,相当于动量
- 二阶矩:过去梯度平方的加权平均,用来给每个参数单独调步长:梯度一直大的参数步子小一点,一直小的步子大一点
- 更新大致是 θ ← θ − α · m / (√v + ε)
- 其他:Adagrad、Adadelta、RMSprop、Nadam
- 现在最常用的是 Adam 和 SGD + 动量
5.4 学习率
梯度只告诉方向,没告诉走多远。学习率(步长)是最重要的超参数之一。
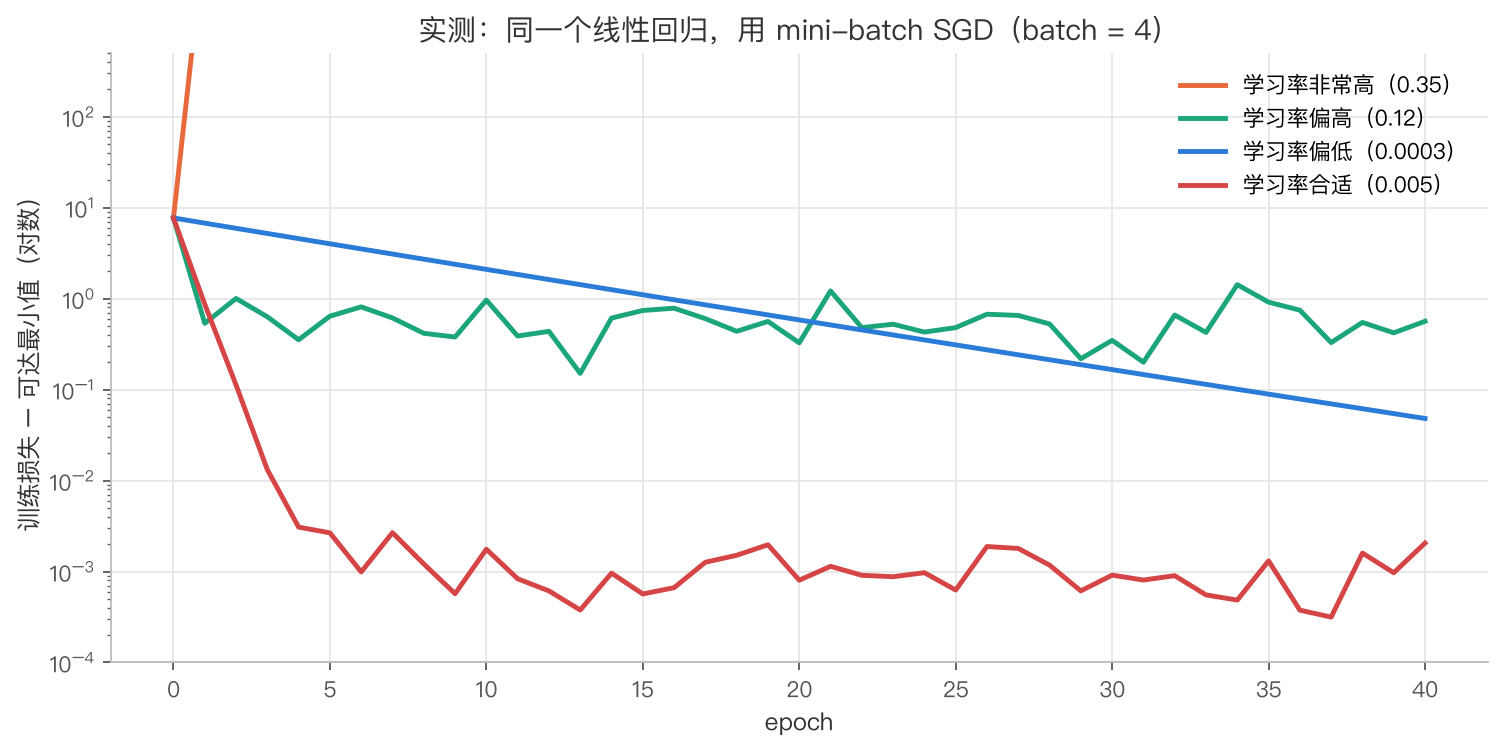
实测设置
10 维线性回归,400 个样本,噪声标准差 1,batch = 4,40 个 epoch。纵轴是训练 MSE 减去最小二乘解的 MSE(对数)。学习率 0.35 第一个 epoch 就发散;0.12 很快停在高处来回抖;0.0003 一路慢慢降;0.005 快速降到很低。
| 训练损失曲线的形状 | 学习率 |
|---|---|
| 先降一点就往上飙,或者变成 NaN | 太高,发散 |
| 一开始降得快,然后停在较高水平不动 | 偏高,在最小值附近跳,进不去 |
| 几乎一条直线缓慢下降 | 偏低 |
| 快速下降后继续平稳降到很低 | 合适 |
5.5 学习率调度
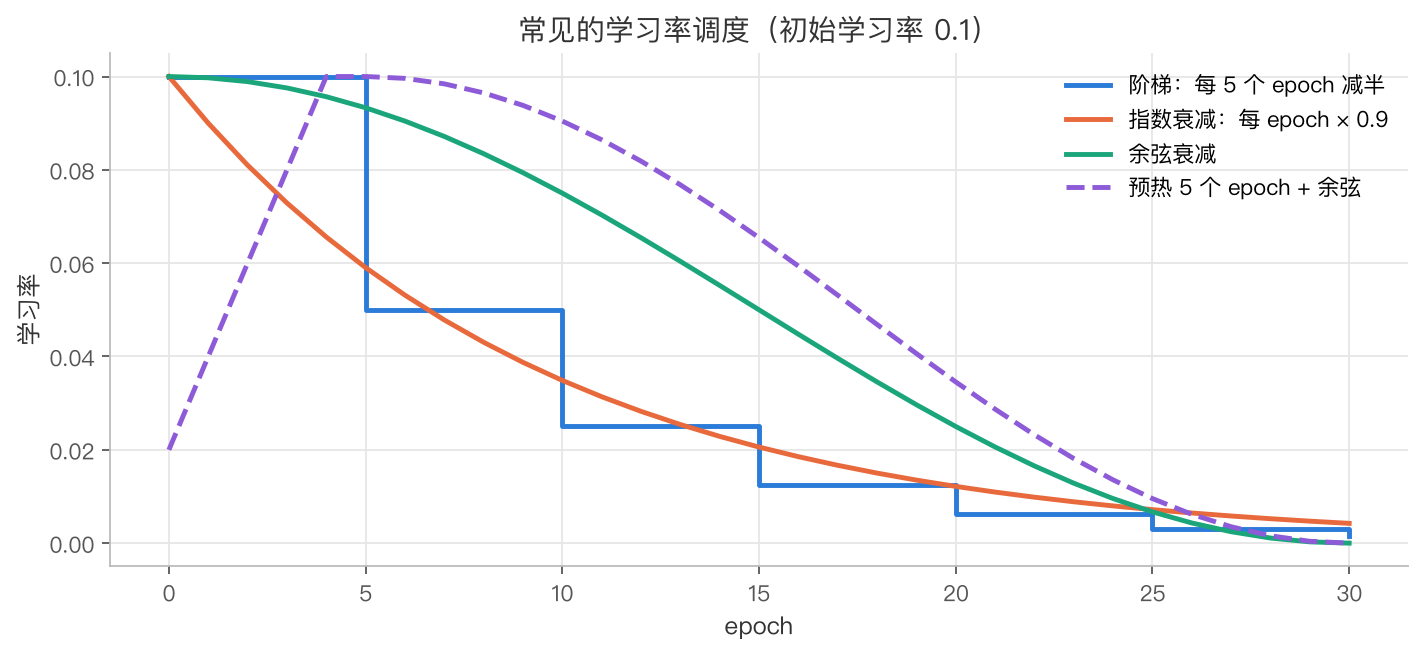
- 退火 / 学习率衰减:阶梯式(每 5 个 epoch 减半,或每 20 个 epoch 除以 10)、指数衰减、余弦衰减、验证损失不再改善时就降(如因子 0.1、patience 10、最小 1e−6)
- 预热:开始时逐渐增大学习率,之后再降。刚开始参数随机、梯度很乱,先小步试探
- 思路:先大步赶路,快到了换小步
- 很多时候挑一个合适的固定学习率也够用
调度器放在哪个循环
按 epoch 衰减的调度器要放在外层循环。误放进内层循环,每个 batch 都衰减一次:比如每 epoch 4 个 batch、γ = 0.9,50 个 epoch 后学习率乘了 0.9²⁰⁰ ≈ 7 × 10⁻¹⁰,训练基本停了。
6 梯度消失与梯度爆炸
梯度可能变得非常小(消失)或非常大(爆炸),导致参数更新太小或太大。消失比爆炸更常见,越靠近输入的层越严重。
成因:反向传播时,第 1 层的梯度是一长串数的连乘
每个因子都小于 1 → 越乘越小;都大于 1 → 越乘越大。sigmoid 的导数最大只有 0.25,十层光这一项就最多 0.25¹⁰ ≈ 10⁻⁶。
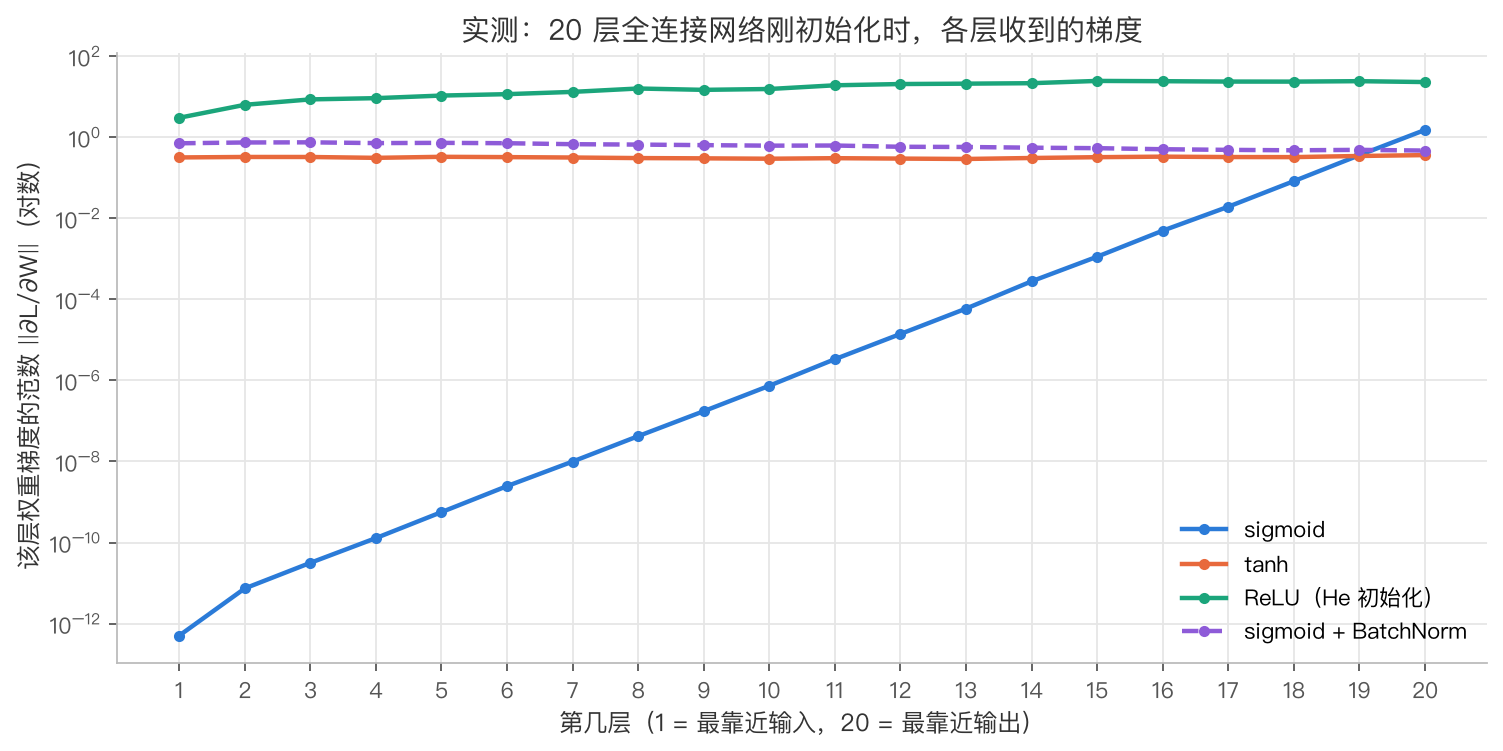
实测设置
20 层全连接、每层 100 个神经元,batch 128,随机输入和目标,MSE 损失,刚初始化时计算每层权重梯度的范数,5 个随机种子平均。sigmoid、tanh 用 Xavier 初始化(方差 1/n),ReLU 用 He 初始化(方差 2/n)。
- sigmoid:第 1 层的梯度只有第 20 层的约 3 × 10⁻¹³
- tanh、ReLU:初始化匹配时各层梯度大小基本持平
- sigmoid + BatchNorm:每层先归一化再过 sigmoid,各层梯度基本持平
对策:
| 方法 | 为什么有效 |
|---|---|
| ReLU / Leaky ReLU | 正半轴导数恒为 1,连乘不会因激活函数变小;Leaky 还让负半轴有梯度 |
| BatchNorm | 把每层输入拉回均值 0、方差 1,sigmoid、tanh 落在斜率大的区域 |
| 合适的初始化 | Xavier / He 让每层输出和梯度的尺度保持稳定 |
| 残差连接 | 梯度可以沿跳跃连接直接传回去 |
| 梯度裁剪 | 针对爆炸:梯度范数超过阈值就按比例缩小 |
加数据、调学习率解决不了梯度消失:问题出在梯度传不回去,和数据量无关;梯度接近 0 时乘多大的学习率,更新量都接近 0。
7 泛化:欠拟合与过拟合
7.1 症状与对策
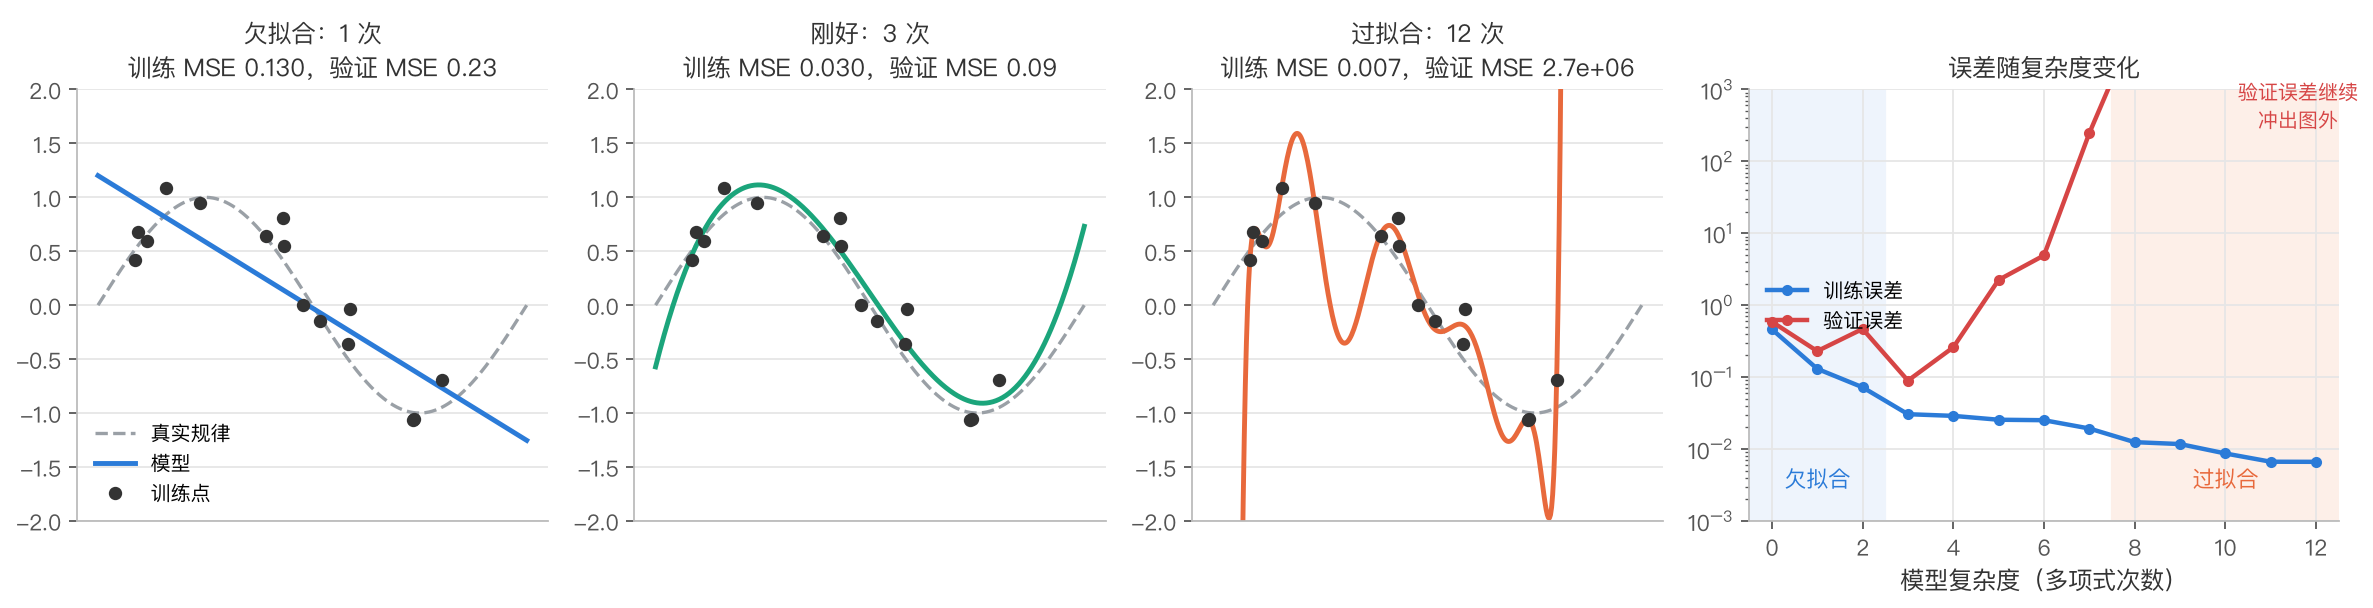
| 欠拟合 | 刚好 | 过拟合 | |
|---|---|---|---|
| 原因 | 模型太简单 | — | 学到了训练数据特有的模式和噪声 |
| 训练误差 | 高 | 低 | 很低 |
| 验证误差 | 高,和训练误差接近 | 略高于训练误差 | 远高于训练误差 |
| 术语 | 高偏差 | — | 高方差 |
| 对策 | 加大模型、加特征、训练更久 | — | 正则化、更多数据、数据增强、早停 |
实测设置
15 个训练点 y = sin(2πx) + N(0, 0.25²),300 个验证点,用多项式回归示意,多项式次数相当于网络大小。3 次时验证误差最低;12 次时训练 MSE 只有 0.007,验证 MSE 冲到 10⁶ 量级。
- 偏差:模型太死板,换多少数据都差不多,但都不准
- 方差:模型太灵活,换一批训练数据学出来的就很不一样
- 神经元已经很多、简单函数还是拟合不好时,问题多半在训练本身(学习率、迭代次数、输入没标准化),而非容量不够
看训练 / 验证曲线:
- 两条线都还在上升(准确率)或下降(误差),差距不大 → 还没训练完,继续训
- 训练一直变好,验证先变好后变差,差距越来越大 → 过拟合
- 两条线贴在一起、都停在较差的水平 → 欠拟合
- 注意纵轴是准确率(越高越好)还是误差(越低越好)
7.2 训练集、验证集、测试集
| 来自哪 | 调权重吗 | 用来做什么 | |
|---|---|---|---|
| 训练集 | 训练数据 | 调(前向 + 反向) | 学参数 |
| 验证集 | 训练数据里留出的一部分 | 不调,不做反向传播 | 检查训练效果、挑超参数、决定何时早停 |
| 测试集 | 训练过程中从没用过 | 不调 | 最后评估一次泛化能力 |
验证集相当于发布前的内部测试:结果不好就回去改设置重训,所以它本质上仍是训练流程的一部分。测试集一旦参与了挑选,就不再能代表真实表现。
7.3 网络大小与容量
容量指模型能表示多复杂的函数,大致随神经元数和层数增长。
- 太小 → 欠拟合:目标函数波动越多,需要的隐藏神经元越多
- 太大 → 过拟合:参数比数据点还多时,网络有足够的自由度穿过每个训练点,同时在点与点之间乱拐。例:11 个训练点,1-2-1 网络 7 个参数拟合得很平滑,1-9-1 网络 28 个参数就会在点之间起伏
- 神经元数量要和问题复杂度匹配,太大时配合正则化
8 正则化
8.1 L2 正则
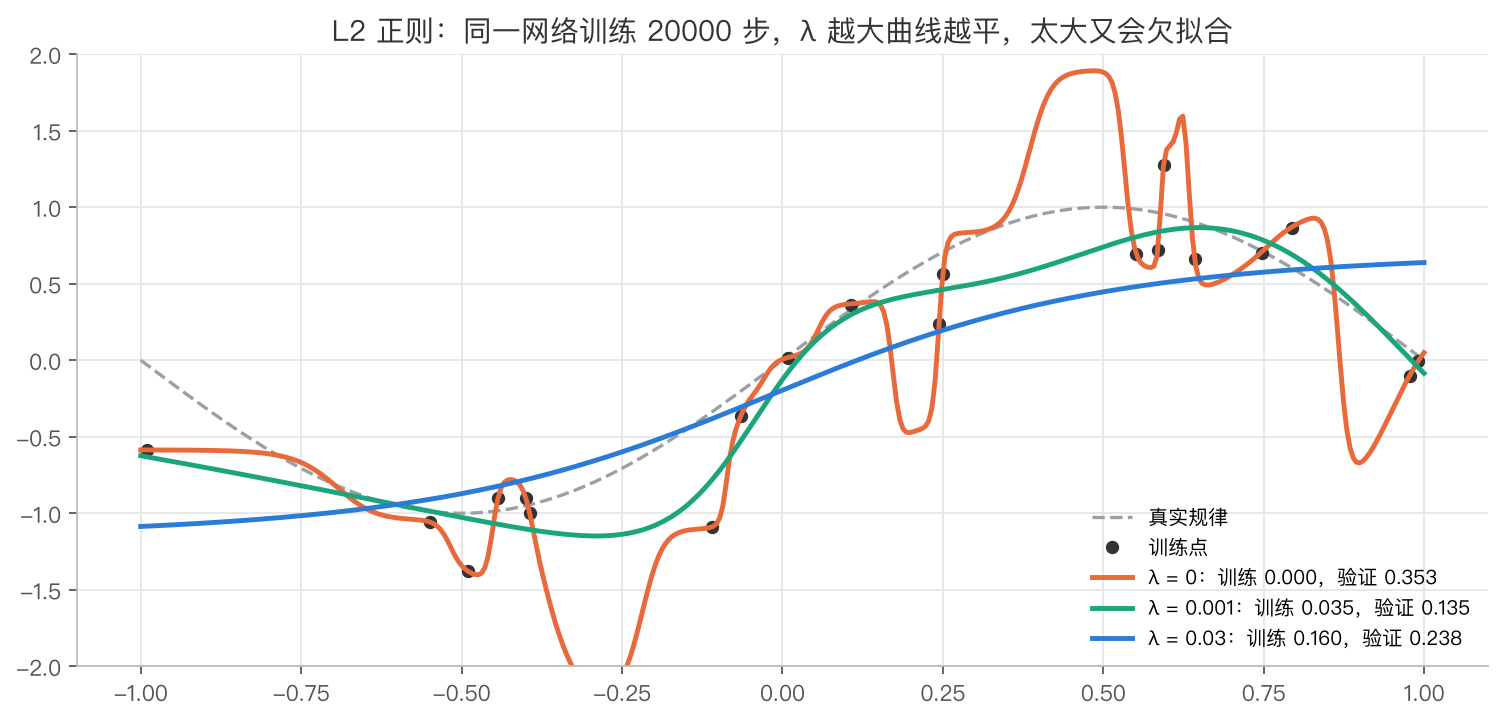
- 惩罚大权重。过拟合的曲线要拐很多急弯,需要很大的权重;罚掉大权重就只能画平缓的曲线
- λ 是超参数:太小管不住过拟合,太大会欠拟合
- 偏置通常不加正则
为什么也叫 weight decay:
每步先把权重乘一个略小于 1 的数。PyTorch 里写成优化器的 weight_decay 参数。
例:w = 2,数据梯度 0.5,α = 0.1,λ = 0.05 → 总梯度 0.5 + 2 × 0.05 × 2 = 0.7,w = 1.93(不加正则是 1.95)。
和贝叶斯的关系:L2 等于给参数加高斯先验 N(0, s²) 做 MAP,因为 −log p(θ) = θ²/(2s²) + 常数;L1 对应拉普拉斯先验。
实测设置
1-64-64-1 tanh 网络,20 个训练点 y = sin(πx) + N(0, 0.3²),400 个验证点,Adam(学习率 0.01)全批量训练 20000 步,正则项 λΣW²。
| λ | 训练 MSE | 验证 MSE |
|---|---|---|
| 0 | 0.000 | 0.353 |
| 0.001 | 0.035 | 0.135 |
| 0.03 | 0.160 | 0.238 |
噪声方差是 0.09,验证 MSE 不可能低于它。λ = 0.03 时训练误差也上去了,已经偏欠拟合。
8.2 L1 与弹性网络
- L1 会把很多权重压到正好为 0(稀疏,相当于自动挑特征);L2 让权重都变小但很少恰好为 0
- 神经网络里 L1 不太常用,效果常不如 L2
8.3 dropout
- 训练时每个神经元以概率 p 随机丢弃(连同连接),彼此独立;p 是超参数,常取 20%–50%
- 每次随机让一部分神经元缺席,网络不能依赖特定的几个神经元,学出来的特征更稳健
- 一种集成学习:每个 mini-batch 训练的是一个不同的子网络,测试时用完整网络,近似对这些子网络取平均
- 测试时关闭:PyTorch 里
model.eval()切到评估模式,再调用模型 - PyTorch 训练时把保留下来的输出乘 1/(1 − p)(p = 0.5 时乘 2),让训练和测试的输出期望一致,测试时不用再缩放
8.4 早停
- 训练时留出验证集(如验证 : 训练 ≈ 1 : 3)
- 验证准确率或损失连续 n 个 epoch 没有改善就停,n 叫 patience;保留验证误差最低时的权重
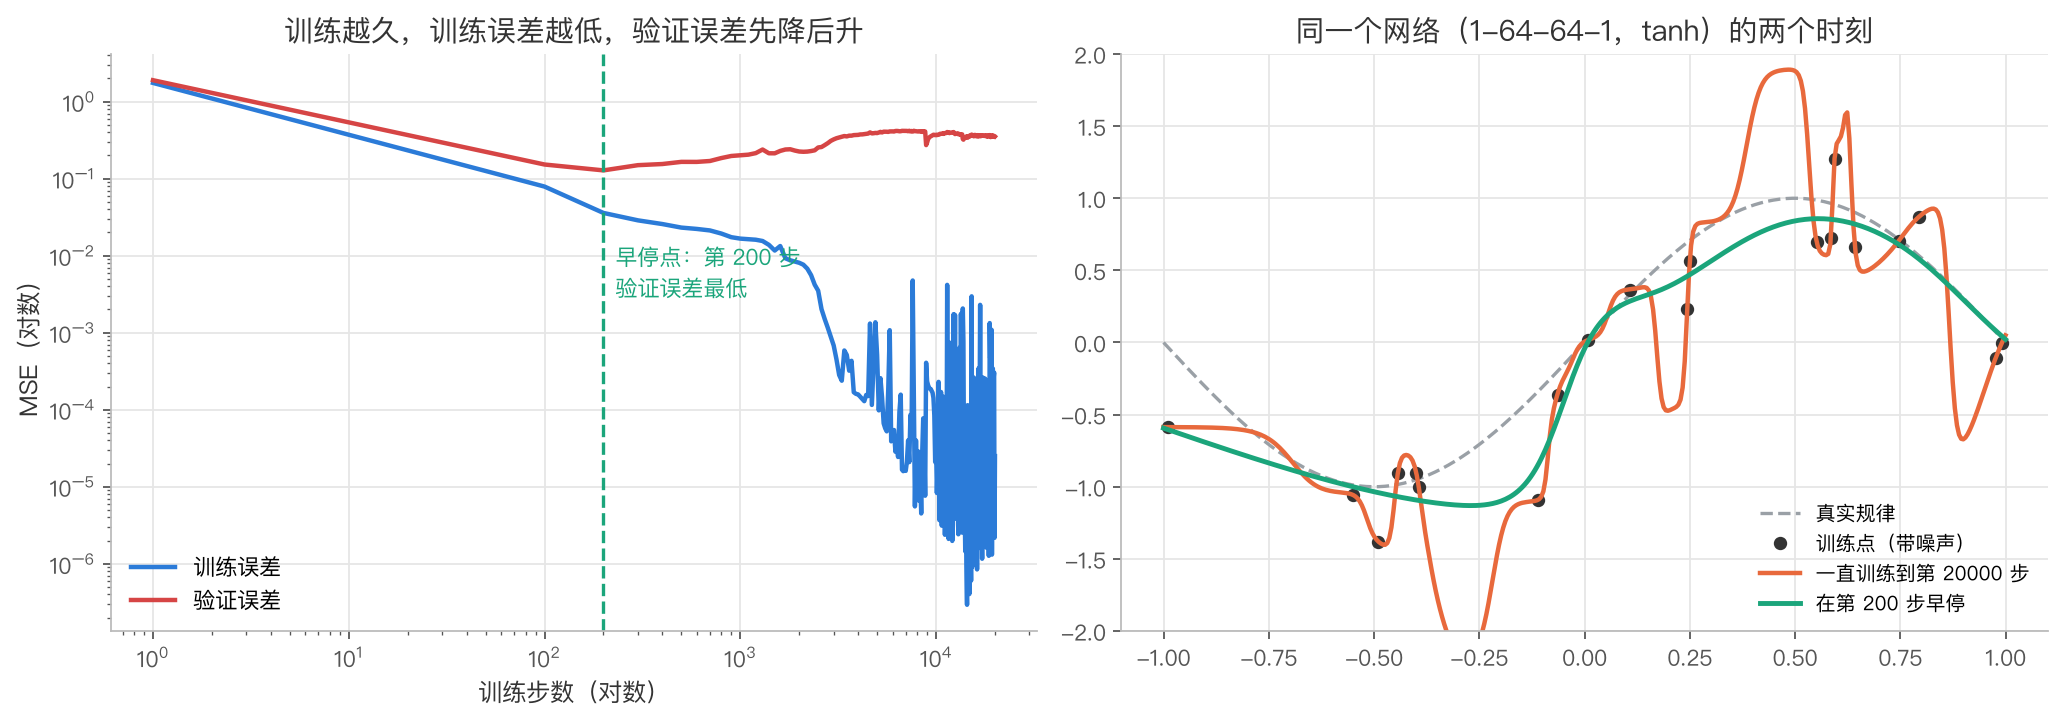
- 训练误差一直降,验证误差先降后升,停在最低点
- 它算正则化:训练越久越去拟合噪声,相当于模型越来越复杂
- 和「验证损失不改善就降学习率」的区别:一个降学习率继续训,一个直接停
实测设置
和 8.1 同一个网络和数据,λ = 0。验证误差在第 200 步最低(0.128);一直训练到 20000 步时,训练 MSE 降到 2.5 × 10⁻⁵,验证 MSE 回升到 0.353。右图绿线是第 200 步的网络,橙线是第 20000 步的。
8.5 BatchNorm
对一个 batch 里的每个特征(卷积网络里是每个通道)做归一化,再做可学习的缩放和平移:
- μ_B、σ_B² 是这个 batch 的均值和方差;ε 防止除以 0
- γ、β 是可学习参数,每个特征 / 通道各一对,共 2 个。例:8 个通道的 BatchNorm 层有 16 个可学习参数。没有这一步,每层输出被强行固定成均值 0、方差 1,表达能力受限
- 训练时还会记录均值方差的滑动平均,测试时用它代替 batch 统计量;这两个是统计量,不算可学习参数
作用:
- 归一化激活值,减少对初始化尺度的依赖 → 不容易梯度消失 / 爆炸
- 减少内部协变量偏移:前面各层参数一直在变,后面层收到的输入分布一直在漂,像练投篮时篮筐一直在动
- 训练更稳定,可以用更大的学习率,收敛更快
- 在卷积网络里非常常见,通常放在激活函数之前
9 超参数与交叉验证
9.1 参数 vs 超参数
| 是什么 | 怎么确定 | 例子 | |
|---|---|---|---|
| 参数 | 网络里被学习的数 | 训练(梯度下降)学出来 | W、b、BatchNorm 的 γ 和 β |
| 超参数 | 控制结构和训练过程的设置 | 训练前由人定,用验证集挑 | 层数、每层神经元数、初始学习率、学习率调度、优化器类型、L2 系数、dropout 率、batch 大小、激活函数、损失函数 |
9.2 怎么搜超参数
- 网格搜索:范围内按步长逐一试遍
- 随机搜索:随机抽值,通常比网格好。往往只有少数几个超参数要紧:试 9 次、调 2 个超参数时,网格 3 × 3 每个只试了 3 个值,随机试了 9 个
- 贝叶斯优化:根据已经试过的结果,挑下一个最有希望的点
- 学习率、λ 这类跨数量级的超参数,在对数尺度上取值
9.3 k 折交叉验证
- 先把数据分成训练数据和测试数据
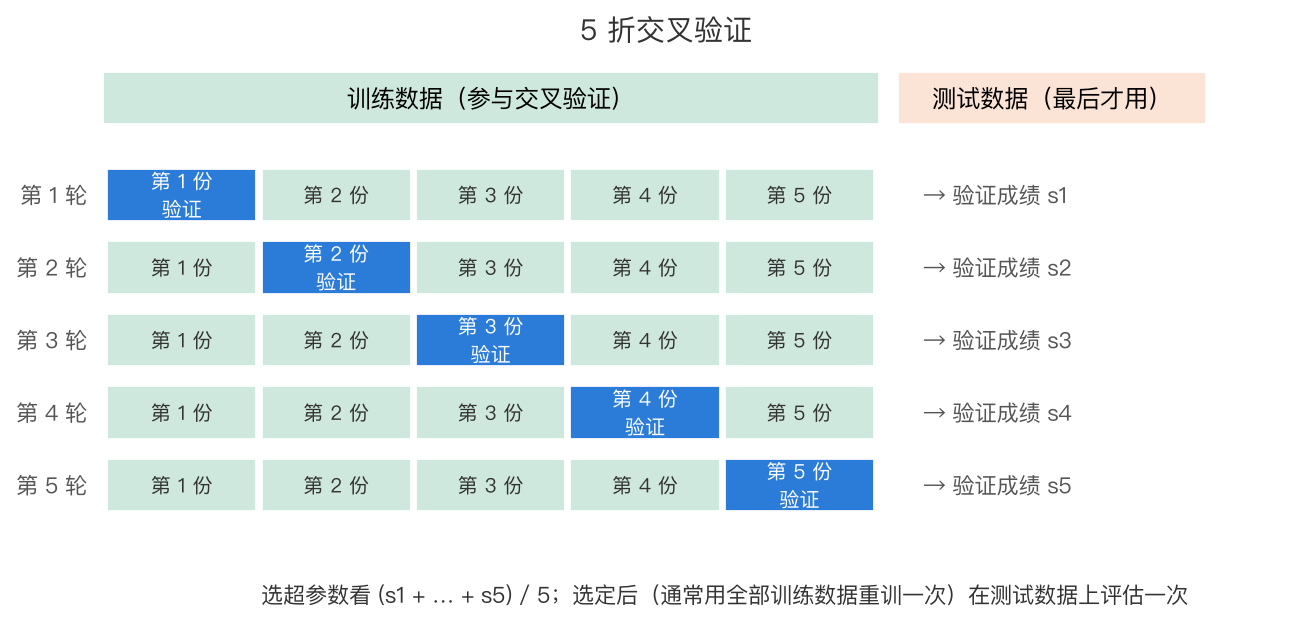
- 训练数据分成 k 等份
- 每轮用 1 份验证、其余训练,轮流做 k 次
- 对 k 次结果取平均,用来比较超参数
- 选定超参数后(通常用全部训练数据重训一次),在测试数据上评估
- 数据少时用:单独划一块验证集太浪费,而且那块碰巧好或碰巧差都会误导;数据大时训练 k 次太贵
- 测试集全程不参与
- 代价:每组超参数训练 k 次。例:2000 个训练样本、10 折、6 组超参数 → 每次 1800 训练 / 200 验证,共训练 60 次
9.4 深网络 vs 浅网络
- 一个隐藏层在理论上就能逼近任意连续函数(万能近似定理),但没说需要多少神经元
- 同样数量的神经元,分到多层往往比全放一层更有效
- 层数增加到一定程度后性能不再提升,太深还会遇到梯度消失,需要 ReLU、BatchNorm、残差连接这类部件
10 要点速查
- 前向:a^l = σ(W^l a^(l−1) + b^l);W 形状 = 本层神经元数 × 上层输出数;「n 层网络」不算输入层;层间必须有非线性激活
- 输出层:多分类 K 个 + softmax;二分类 1 个 sigmoid;回归线性
- softmax:e^(z_i) / Σe^(z_j);同加常数不变;e⁰ = 1 也要进分母;温度越低越尖锐
- 激活:sigmoid 导数 ≤ 0.25、两端饱和;tanh 以 0 为中心;ReLU 快、缓解梯度消失、会 dying;Leaky ReLU 负半轴 αx
- 损失:BCE −[y ln ŷ + (1 − y) ln(1 − ŷ)];多分类 −ln(正确类概率);MSE (1/n)Σ(y − ŷ)²;交叉熵 = 负对数似然
- 梯度下降:θ ← θ − α∇L;只保证局部最小,依赖初始化
- 反向传播:前向算损失 → 反向链式法则算梯度 → 统一更新;sigmoid / softmax + 交叉熵对 logits 的梯度 = 预测 − 标签
- batch:每 epoch 更新 ⌈N / batch⌉ 次;mini-batch 最常用
- 动量:v = βv − α∇L,θ = θ + v,β ≈ 0.9;平台加速、冲过鞍点、减少窄谷振荡,会在最小值附近晃
- Adam:一阶矩 + 二阶矩,按参数自适应步长;最常用 Adam 与 SGD + 动量
- 学习率曲线:上飙 → 太高;停在高处 → 偏高;缓慢直线 → 偏低;快降后到很低 → 合适
- 梯度消失:链式法则连乘;ReLU、BatchNorm、合适的初始化、残差连接;加数据、改学习率没用
- 欠拟合 / 过拟合:都高且接近 → 欠拟合;差距大 → 过拟合
- 验证集:不调权重,用来检查、挑超参数、早停;测试集只在最后用一次
- L2:L + λΣθ² = weight decay = 高斯先验 MAP;λ 太大欠拟合。L1:λΣ|θ|,稀疏
- dropout:p 取 20%–50%,集成学习,测试时关闭,训练时输出乘 1/(1 − p)
- 早停:验证误差 patience 个 epoch 不改善就停,保留最好的权重
- BatchNorm:(x − μ)/√(σ² + ε),再 γx̂ + β;每通道 2 个可学习参数;缓解梯度消失、允许更大学习率
- 参数 vs 超参数:参数训练学出(W、b、γ、β);超参数训练前设定、用验证集挑
- k 折:轮流验证取平均;数据少时用;测试集不参与;每组超参数训练 k 次