深度学习与神经网络3
2.1 注意力与 Transformer
2.1.0 注意力机制(家族公共部分)
一句话
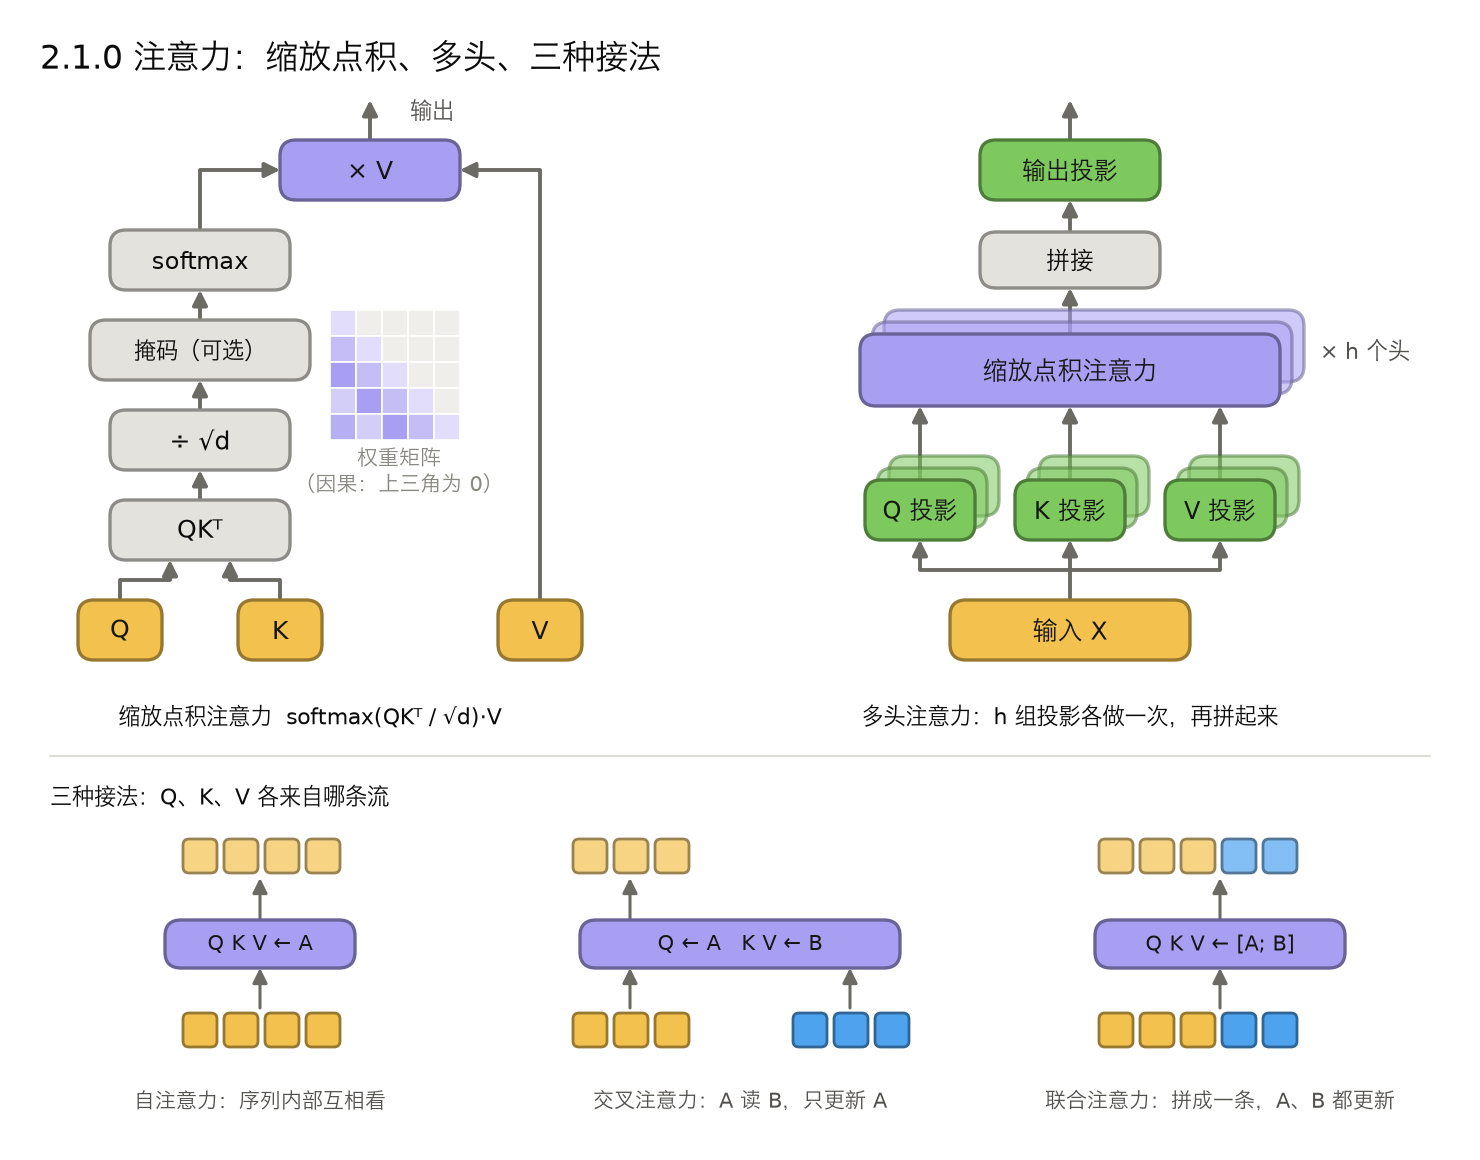
注意力 = 软检索:用一个查询(Query)和一组键(Key)算相似度,按相似度对对应的值(Value)加权求和。
三个角色
| 角色 | 比喻 | 作用 |
|---|---|---|
| Query(Q) | 我要查什么 | 发起检索的一方 |
| Key(K) | 我能被什么查到 | 和 Q 算相似度,决定「看谁、看多少」 |
| Value(V) | 我携带的内容 | 按权重被取出来 |
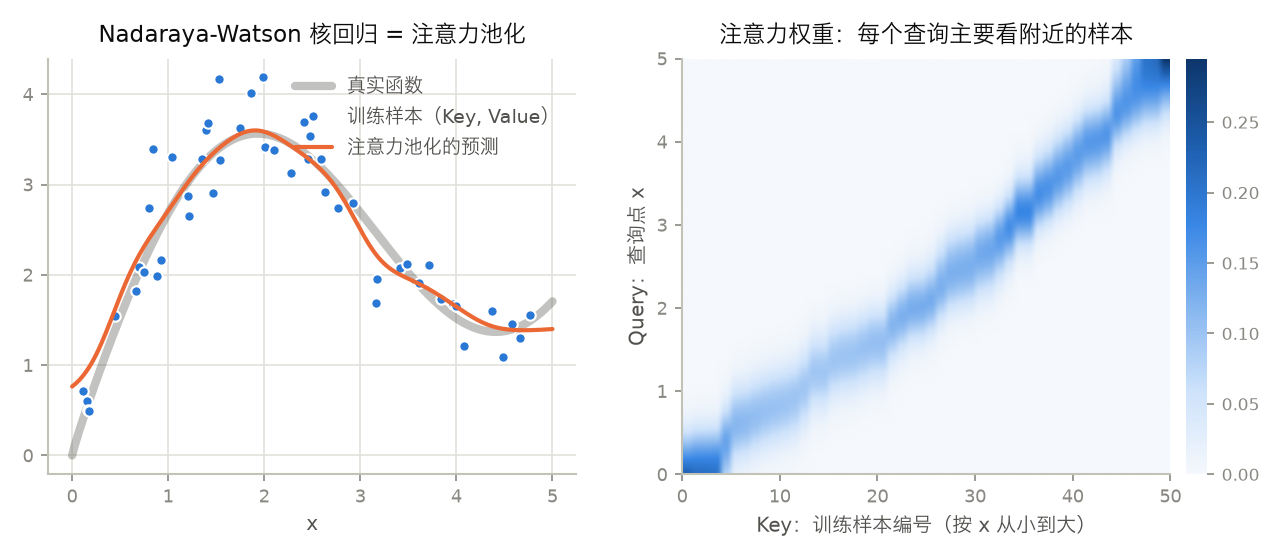
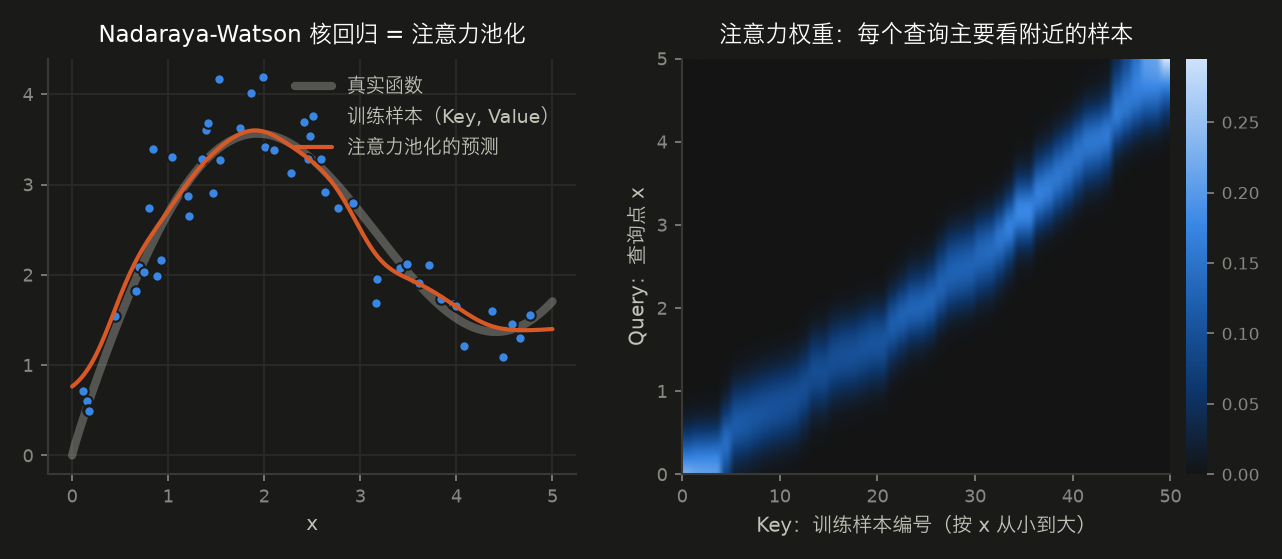
最早的形态:注意力池化。1964 年的 Nadaraya-Watson 核回归就是注意力:要预测查询点 x 的值,把所有训练样本的 y_i 加权平均,权重由 x 和 x_i 有多近决定:
这里 x 是 Query,x_i 是 Key,y_i 是 Value,打分函数是固定的高斯核,σ 是核的宽度(越小越只看附近的点)。现代注意力把打分函数换成可学习的。
两种打分函数
加性打分允许 q、k 维度不同;缩放点积全是矩阵乘,快,是现在的标准。除以 √d 的原因:假设 q、k 各分量相互独立、均值为 0、方差为 1,点积的方差就是 d。d 大了 softmax 的输入会很极端,输出接近 one-hot,梯度几乎为 0;除以 √d 把方差拉回 1。
矩阵形式(一次算整条序列):
掩码:在 softmax 前把不允许看的位置设成 −∞,权重就变成 0。两种常见掩码:padding 掩码(不看补齐的空位)、因果掩码(位置 t 只能看 ≤ t 的位置,用于自回归生成)。
多头注意力:把 d 维拆成 h 个头,每个头用自己的投影在 d/h 维的子空间里独立做注意力,再拼起来过一个输出投影。不同的头可以关注不同的关系(有的看相邻词,有的看指代对象)。
三种接法:Q、K、V 各来自哪条流
| 接法 | Q 来自 | K、V 来自 | 谁被更新 | 方向 | 代表 |
|---|---|---|---|---|---|
| 自注意力 self | 序列 A | 序列 A | A | 序列内部 | Transformer 每一层 |
| 交叉注意力 cross | 序列 A | 序列 B | 只有 A | 单向:A 读 B | 原版 Transformer 解码器读编码器、Stable Diffusion 的图像读文本、多数 VLA 的动作读观测 |
| 联合注意力 joint / shared | A、B 拼成一条 | 同左 | A 和 B 都更新;各自能读到哪些 token 由掩码决定 | 不加掩码时双向;加块状掩码可以只让一方读另一方 | SD3 的 MMDiT(双向)、π0(块因果掩码:动作读观测,观测不读动作)、MoT 类多模态模型(各模态可以用各自的投影矩阵,见 2.7.2) |
用法上的差别:交叉注意力把「A 读 B」这条通路写死在结构里,每个 A 的 token 都会去 B 里检索;通路一定存在,但这一路对最终输出贡献多大,还要看训练结果。联合注意力里所有 token 在同一个 softmax 里竞争权重,如果 B 只有几个 token、A 有几百个,B 分到的权重往往很少,这是学出来的结果,结构上没有任何保证。多模态里「触觉 token 很少、视觉 token 很多」时要注意这一点(见 2.8)。交叉注意力也只保证 A 会去读 B 整体:B 里如果同时放了视觉和触觉,它们照样在同一个 softmax 里竞争。
复杂度:T 个 token 两两算相似度,计算量是 O(T²);标准实现要把 T×T 的注意力矩阵存下来,显存也是 O(T²)。FlashAttention 分块计算、不存完整矩阵,结果不变,注意力部分的显存降到随 T 线性增长,计算量仍是 O(T²)。序列再长,就要换稀疏注意力、线性注意力,或者换成 SSM(2.5.3)。
1 | import math |
1 | import torch |
典型例子
- 机器翻译里的对齐:译出某个词时,注意力权重集中在原句对应的词上
- 检索:RAG 可以和 Q/K/V 类比,问题像 Q、文档像 K/V;实际的 RAG 先用检索器从文档索引里取 top-k 篇,再和问题一起交给生成器,并不是让生成器对整个文档库做注意力
- 现代 Hopfield 网络的一步更新在数学上就是注意力(2.12.1)
- 优势:任意两个位置一步直连,没有距离衰减;权重随输入内容变化(CNN 的卷积核是固定的);权重可视化能看出这一层、这个头在汇聚哪些位置的信息(要说明哪些输入对最终决策重要,还要配合其他分析或干预实验);对集合和序列都适用
- 局限:计算量 O(T²)(标准实现的显存也是 O(T²));对 V 只是加权平均,逐 token 的特征变换要靠后面的 FFN;本身不知道顺序(没有因果掩码时完全不知道),需要位置编码
- 适合的数据:能切成一组 token 的任何东西:文本、图像块、音频帧、点、图节点、动作步、多模态混合序列
2.1.1 Transformer
一句话
只用注意力和逐 token 的前馈网络堆起来的序列模型,去掉了循环,训练时序列里的各个位置可以并行计算(层与层之间仍是先后依赖)。
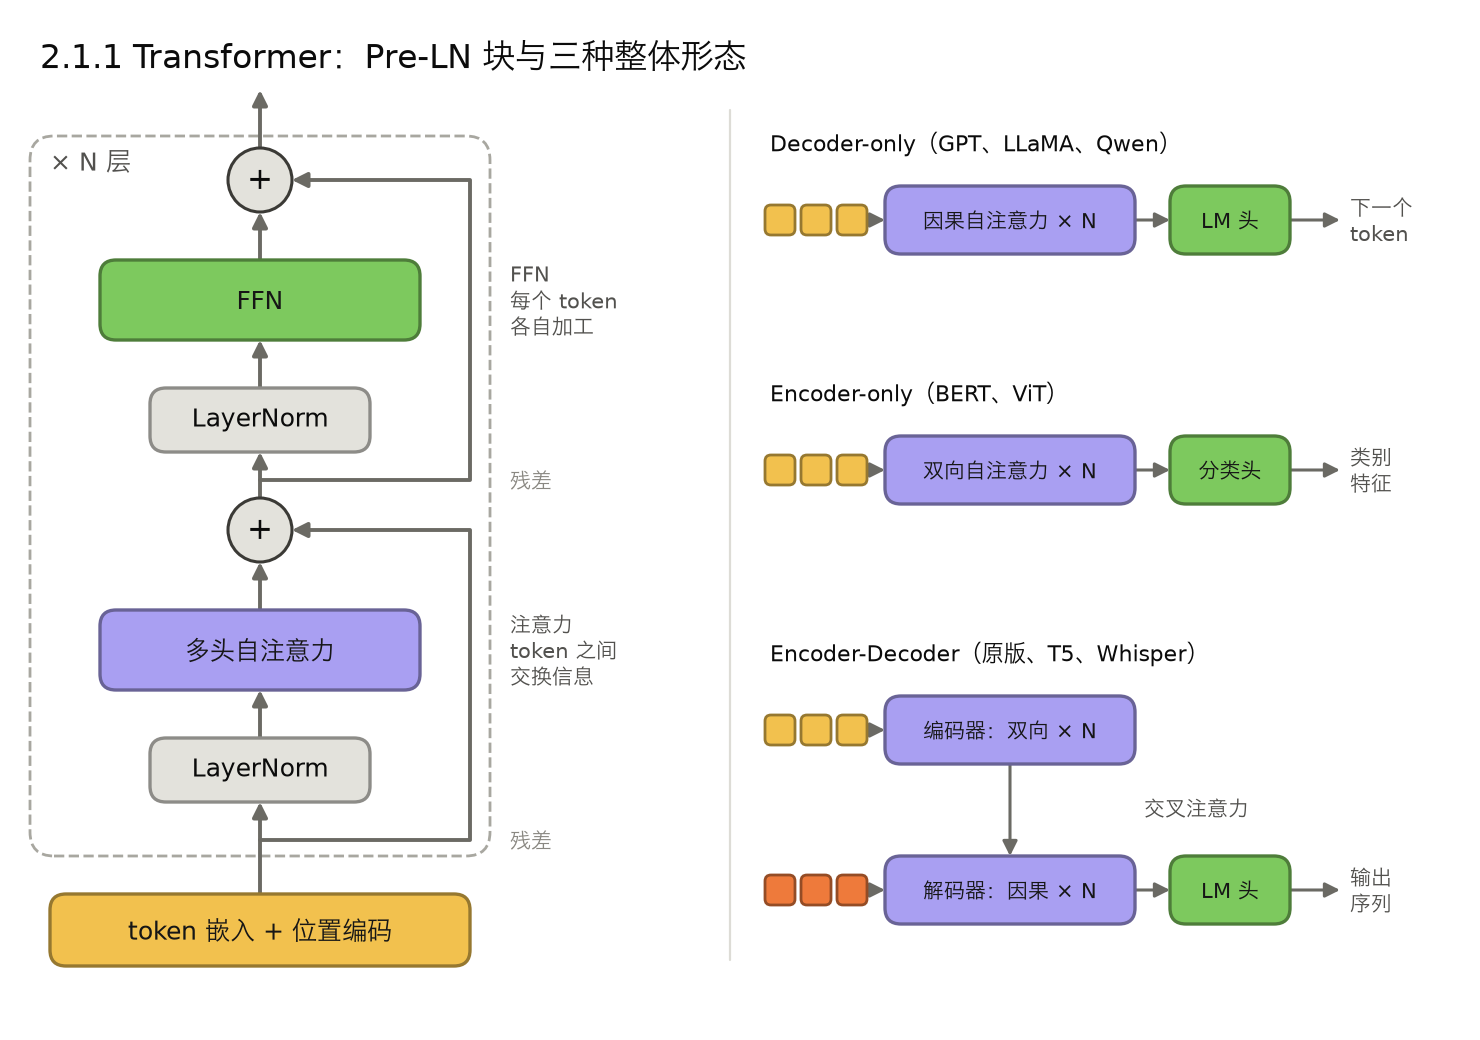
一个 block 的结构(现代通用的 Pre-LN 写法,见上图左):
原版论文把 LayerNorm 放在残差相加之后(Post-LN),层数多了不好训;现在基本都用 Pre-LN。
分工:注意力决定「看谁」,按内容算出权重,把各个 token 的 V 混合起来。权重随输入变化、还要过 softmax,所以注意力对输入也是非线性的,但它不对单个 token 的特征做逐维的非线性变换;FFN 决定「看完之后怎么想」,逐 token 的非线性变换主要发生在 FFN 里。FFN 逐个 token 独立作用,同一层里词与词之间在 FFN 这一步不交换信息。
参数在哪:注意力有 Q、K、V、O 四个 d×d 投影,共 4d²;FFN 两个矩阵 d×4d 和 4d×d,共 8d²。FFN 占一个 block 参数的 2/3。所以混合专家(2.7.1)想在不增加单 token 计算量的前提下扩大参数,复制的是 FFN。SwiGLU 版 FFN 有三个矩阵,一般把中间维度调成 8d/3 来保持参数量不变。
为什么需要位置编码:不加位置信息、也没有因果掩码这类固定顺序的掩码时,自注意力对输入顺序是置换等变的:打乱输入顺序,输出也只是同样被打乱,模型不知道谁在前谁在后。因果掩码本身会带进一部分顺序信息(只用因果掩码、不加位置编码的解码器也能学到位置),但常规做法仍是显式加位置编码。位置编码把位置信息加进 token:
| 位置编码 | 做法 | 谁在用 |
|---|---|---|
| RoPE 旋转位置编码 | 把 q、k 的每两维看成一个复数,按位置旋转一个角度;旋转后的点积仍取决于 q、k 的内容,但位置的作用只通过相对位置差体现 | LLaMA、Qwen 等绝大多数新大模型 |
| 可学习的绝对位置 | 每个位置一个可学习向量,加到输入上 | BERT、GPT-2、ViT |
| 正弦位置编码 | 不同频率的 sin/cos,原版论文用 | 原版 Transformer |
| ALiBi 等相对偏置 | 在注意力分数上按距离加一个惩罚 | 部分长上下文模型 |
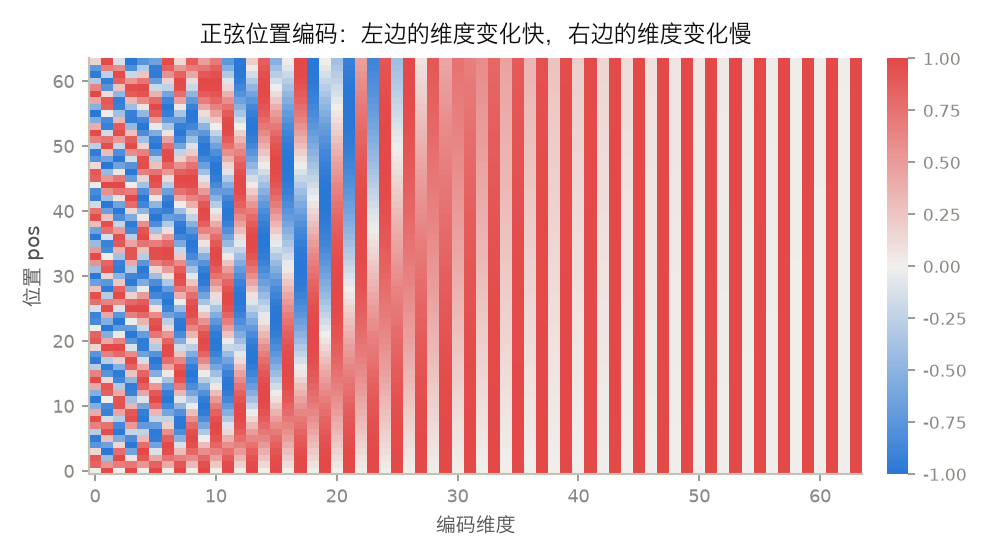
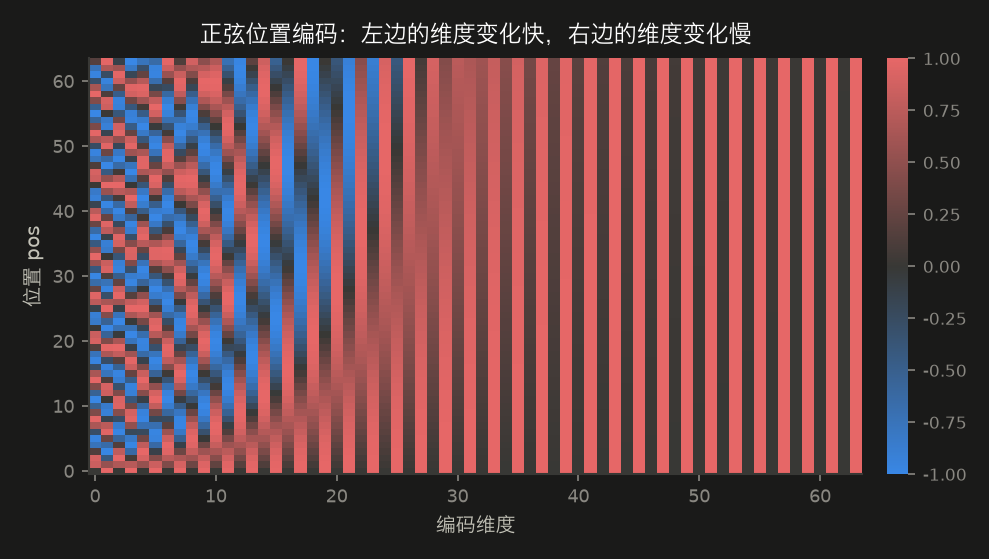
每一行是一个位置的编码向量。低维的正弦频率高,相邻位置差别大;高维的频率低,用来区分远距离的位置。
三种整体形态
| 形态 | 掩码 | 典型预训练目标 | 代表 | 用途 |
|---|---|---|---|---|
| Decoder-only | 因果 | 预测下一个 token | GPT、LLaMA、Qwen、DeepSeek | 生成,现在的大语言模型几乎都是这一种(2.1.2) |
| Encoder-only | 无,双向 | BERT:掩码语言模型(随机选约 15% 的 token 让它预测,其中 80% 换成 [MASK]、10% 换成随机词、10% 保持原样);ViT:有监督图像分类,或 MAE 式掩码重建(2.6.2) | BERT、ViT | 理解、分类、提特征 |
| Encoder-Decoder | 编码器双向,解码器因果 + 交叉注意力 | 去噪、翻译 | 原版 Transformer、T5、Whisper | 输入输出是两种序列的转换 |
1 | import torch |
1 | import torch |
典型例子
- 机器翻译:原版论文(2017)在 WMT14 英德翻译上 BLEU 28.4,训练成本远低于当时的 RNN 方案
- BERT(2018):Encoder-only,掩码语言模型预训练后微调,刷新了 11 项 NLP 任务
- 大语言模型:GPT、LLaMA、Qwen、DeepSeek,全部是 Decoder-only
- 语音:Whisper(Encoder-Decoder,音频频谱 → 文字)
- 蛋白质结构:AlphaFold2 的 Evoformer 用注意力处理序列比对和残基对
- 机器人:RT-2、OpenVLA、π0 等视觉-语言-动作模型的主干
- 优势:长程依赖一步到位;训练时各位置可以并行,GPU 利用率高;任何模态切成 token 都能处理,一套架构吃所有模态;规模越大效果越好的趋势很稳定(scaling law)
- 局限:O(T²) 开销;归纳偏置少,小数据从头训容易过拟合,通常要预训练;自回归推理要逐 token 生成;推理延迟高,难直接上几百 Hz 的控制回路
- 适合的数据:token 序列与集合,尤其是数据量大、依赖跨度长的场景:文本、代码、图像块、音频、视频、动作序列、多模态混合序列
2.1.2 GPT 式解码器与大语言模型
一句话
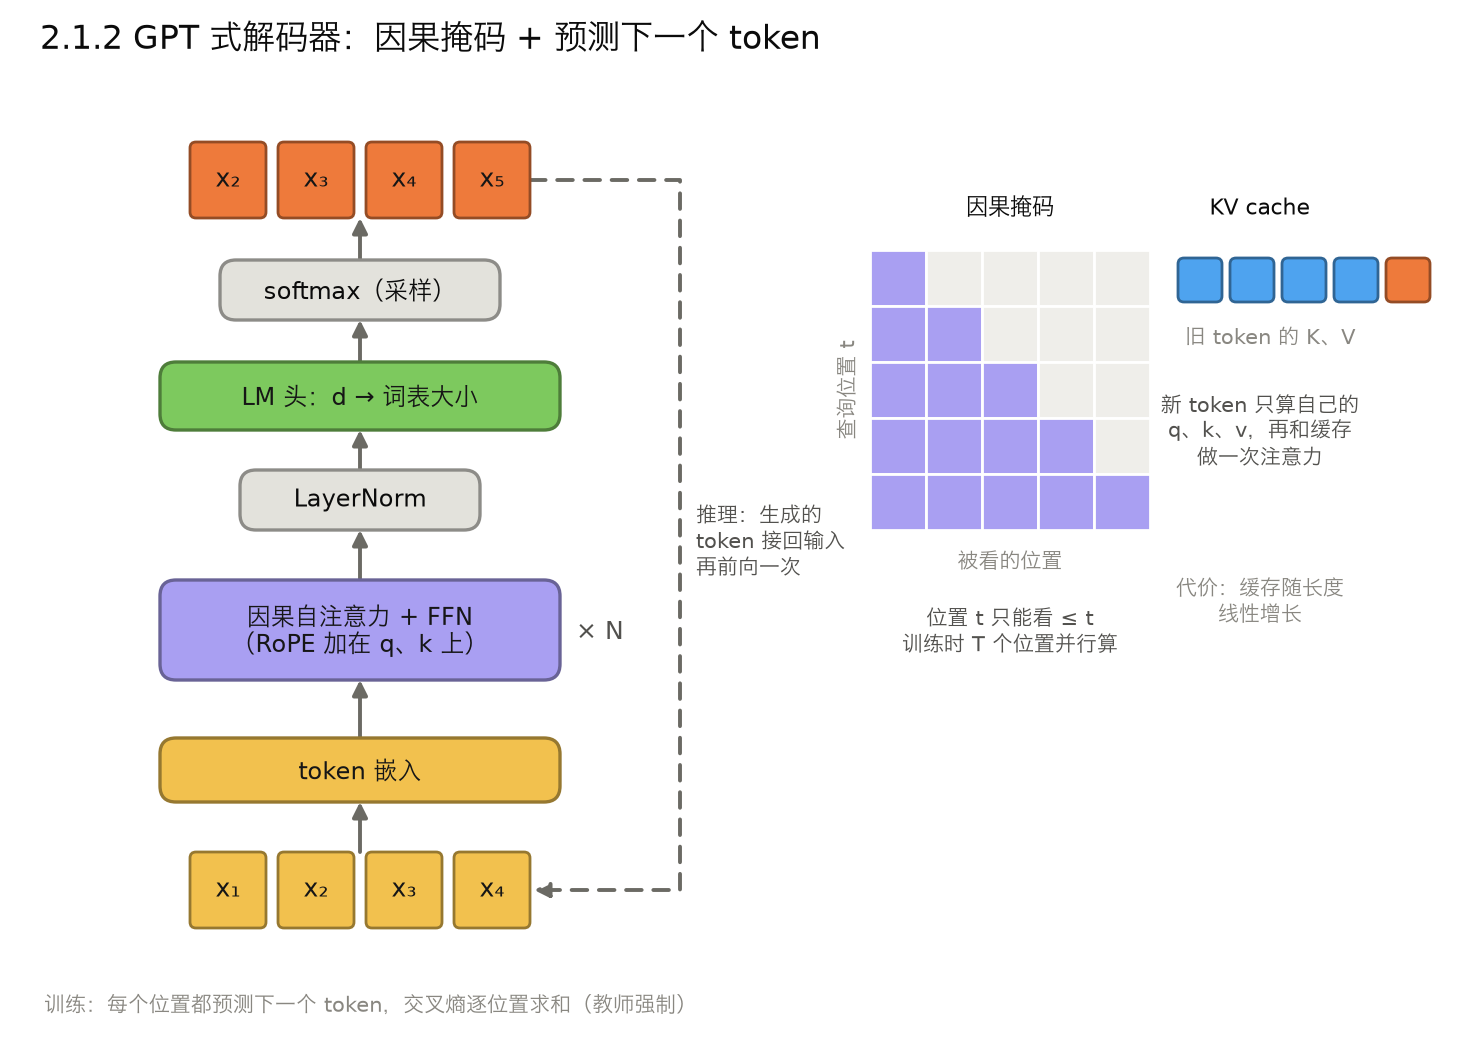
Decoder-only Transformer + 因果掩码 + 「预测下一个 token」,把这个目标在海量文本上训练,就是大语言模型的预训练。
自回归分解:把一个序列的联合概率拆成逐个 token 的条件概率连乘:
损失就是每个位置上的交叉熵(1.4 节的 NLL)。
训练并行、推理串行:训练时整句一次喂进去,因果掩码保证位置 t 只能看到 t 之前,T 个位置的预测同时算,这叫教师强制(teacher forcing)。推理时只能一个一个生成,每生成一个 token 接到末尾再喂回去。
KV cache:推理时,之前 token 的 K、V 不会变,存起来;每步只给新 token 算 q、k、v,新 token 的 q 去和全部缓存的 K、V 做注意力。每步计算从重算整条序列变成只算一个位置。代价是缓存随序列长度线性增长,长上下文时 KV cache 往往比模型权重还占显存。
采样策略
| 策略 | 做法 | 效果 |
|---|---|---|
| 贪心 | 每步取概率最大的 | 确定、容易重复 |
| 温度 | logits 除以 T 再 softmax | T < 1 更保守,T > 1 更随机 |
| top-k | 只在概率最高的 k 个里采样 | 去掉长尾的离谱选项 |
| top-p(nucleus) | 只在累计概率达到 p 的最小集合里采样 | 候选数随分布形状自适应 |
一个大语言模型从无到有
1 | 文本 → 分词器(BPE,把文本切成子词 token) |
规模定律:损失随参数量、数据量、计算量按幂律下降(Kaplan 2020)。Chinchilla(2022)给出计算量固定时的最优配比:大约每个参数配 20 个训练 token。这是在他们的模型族和计算预算范围内拟合出的经验值,不是固定配方;为了让推理便宜,实际常用比这多得多的数据去训练较小的模型。
1 | import torch |
1 | import torch |
典型例子
- ChatGPT、Claude、LLaMA、Qwen、DeepSeek 等对话模型
- 代码模型:补全、生成、修 bug
- 文本以外的自回归:DALL·E 第一版把图像切成离散 token 后自回归生成;AudioLM 对音频 token 自回归;RT-2 和 OpenVLA 把机器人动作离散成 256 个区间当成词表里的 token
- 动作离散化之后,训练目标和训练语言模型完全一样(交叉熵),整套 LLM 训练与推理设施可以原样复用
- 优势:训练目标简单统一(下一个 token),数据不需要标注;似然可以精确计算;一个模型通过提示词完成多种任务;可以直接继承语言模型的预训练权重
- 局限:逐 token 生成,顺序解码的轮数随输出长度线性增加,全注意力时每轮的注意力代价还随上下文变长而增加,总耗时还要看模型、缓存和硬件;早期生成错了会一路影响后面(误差级联);连续量(如机器人动作)要先离散化,精度受区间数限制
- 适合的数据:天然离散的序列(文本、代码);或者能被分词器变成离散 token 的任何数据(图像、音频、动作经 VQ 或分箱离散化后)
2.1.3 ViT(Vision Transformer)
一句话
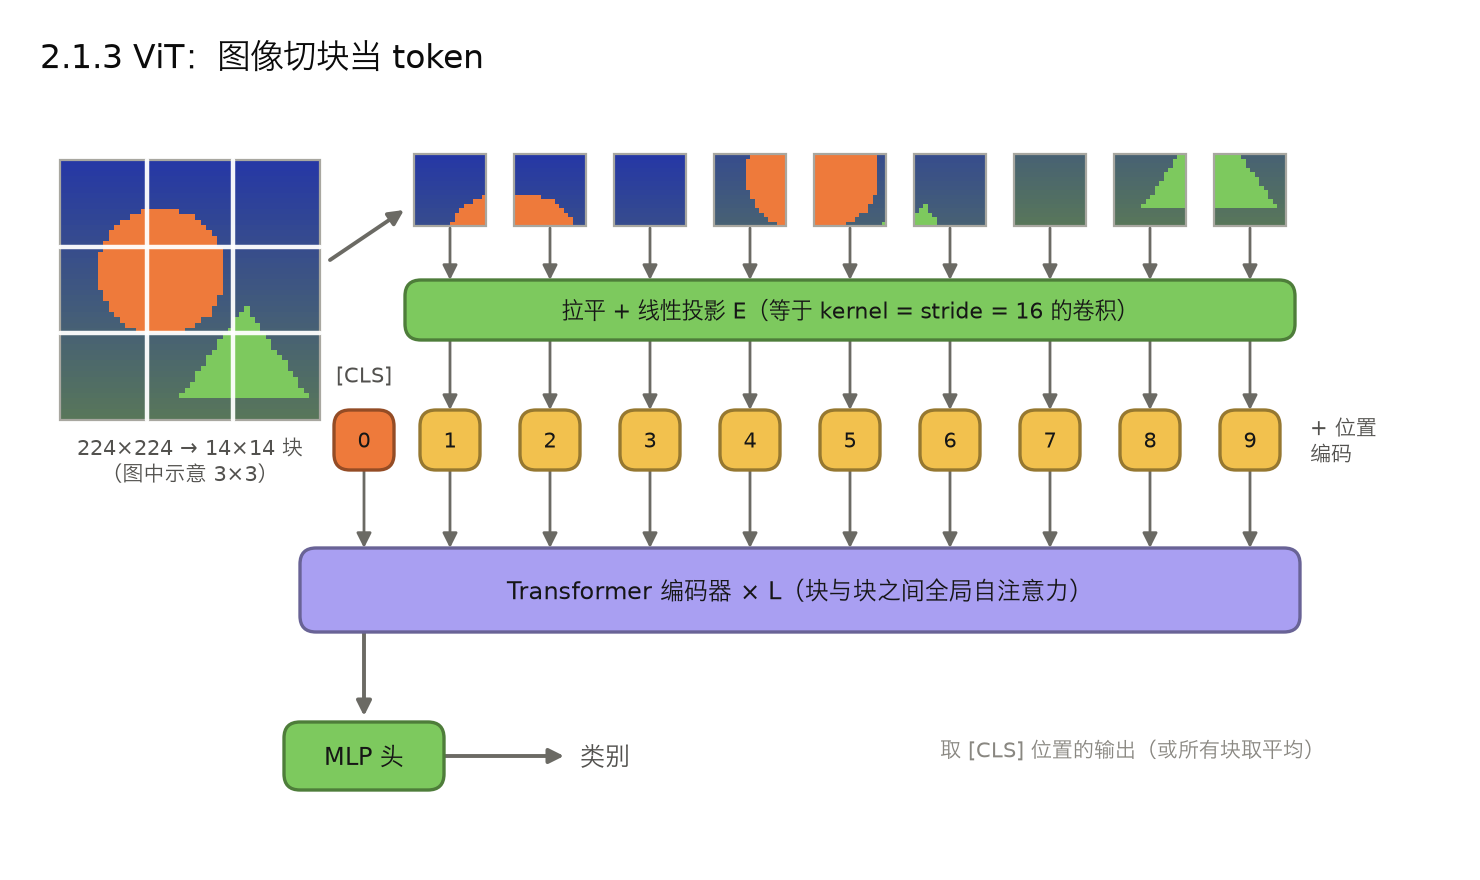
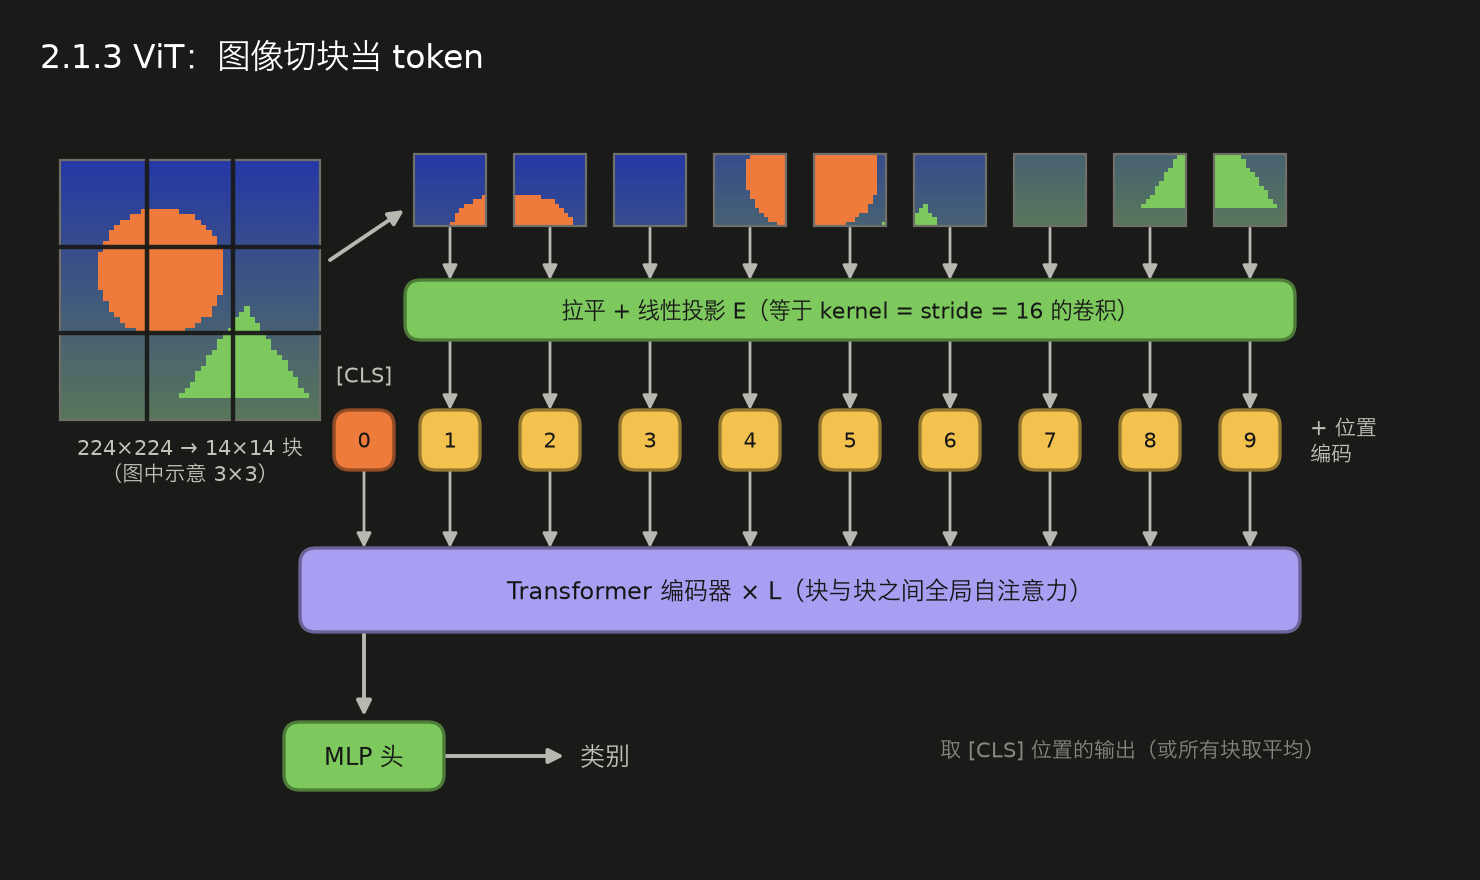
把图像切成 16×16 的小块,每块当一个 token,送进 Transformer 编码器做分类。
流程
- 切块 + 线性投影:224×224 的图切成 14×14 = 196 个 16×16 的块,每块拉平后乘一个矩阵变成 d 维向量。这一步等价于一个 kernel = stride = 16 的卷积
- 加 [CLS] token 和位置编码:在序列最前面加一个可学习的 [CLS] 向量,再给每个位置加可学习的位置编码
- Transformer 编码器:L 层,块与块之间做全局自注意力
- 分类:取 [CLS] 位置的输出接一个线性层(也可以对所有块取平均)
数据量是门槛:ViT 没有卷积的局部性和平移等变先验。原论文在 ImageNet(130 万张)上从头训不如同等规模的 ResNet;在 ImageNet-21k(1400 万张)或 JFT-300M(3 亿张)上预训练后,在多个基准上接近或超过当时最好的结果,预训练数据越大优势越明显。具体胜负还取决于任务、模型规模、训练方法和算力。之后的改进围绕「少数据也能训」和「高分辨率也能算」展开:
| 变体 | 改了什么 |
|---|---|
| DeiT | 强数据增强 + 蒸馏,只用 ImageNet 也能训好 |
| Swin Transformer | 在固定大小的局部窗口内做注意力、逐层合并;模型尺寸和窗口固定时,计算量随像素数(token 数)近似线性增长,适合检测分割 |
| MAE | 遮住 75% 的块让模型重建,自监督预训练(2.6.2) |
| DINO / DINOv2 | 自蒸馏预训练,特征直接拿来做检索、分割、机器人视觉编码(2.6.3) |
| CLIP / SigLIP 的图像编码器 | 用图文对比学习预训练(2.6.1),多数 VLA 的视觉编码器 |
| MLP-Mixer | 把注意力换成在块维度上的 MLP,说明「切块 + 混合」这个结构本身就很有效 |
1 | import torch |
典型例子
- 图像分类:ViT-L/16 在大规模预训练后超过 ResNet
- 通用视觉特征:SigLIP、DINOv2 和常用的 CLIP-ViT 版本的图像编码器都是 ViT(CLIP 也有 ResNet 版本),下游检索、分割、VLA 直接复用
- 分割一切:SAM 的图像编码器是 MAE 预训练的 ViT
- 触觉:GelSight 一类视触觉传感器输出的是图像,可以直接用 ViT 编码
- 优势:第一层就有全局感受野;与文本 Transformer 结构统一,图文多模态拼接方便;数据和模型规模上去后性能持续提升;自监督预训练效果好
- 局限:小数据从头训不如 CNN;块大小固定时 token 数和像素数成正比:图像边长变成 r 倍,token 数变成 r² 倍,全局注意力的两两交互变成 r⁴ 倍,高分辨率代价大;块内部的细粒度位置靠块嵌入自己学
- 适合的数据:图像等网格数据,前提是有大规模数据或现成的预训练权重;需要和语言等其他模态对齐的视觉任务
2.1.4 Seq2Seq 与注意力的起源
一句话
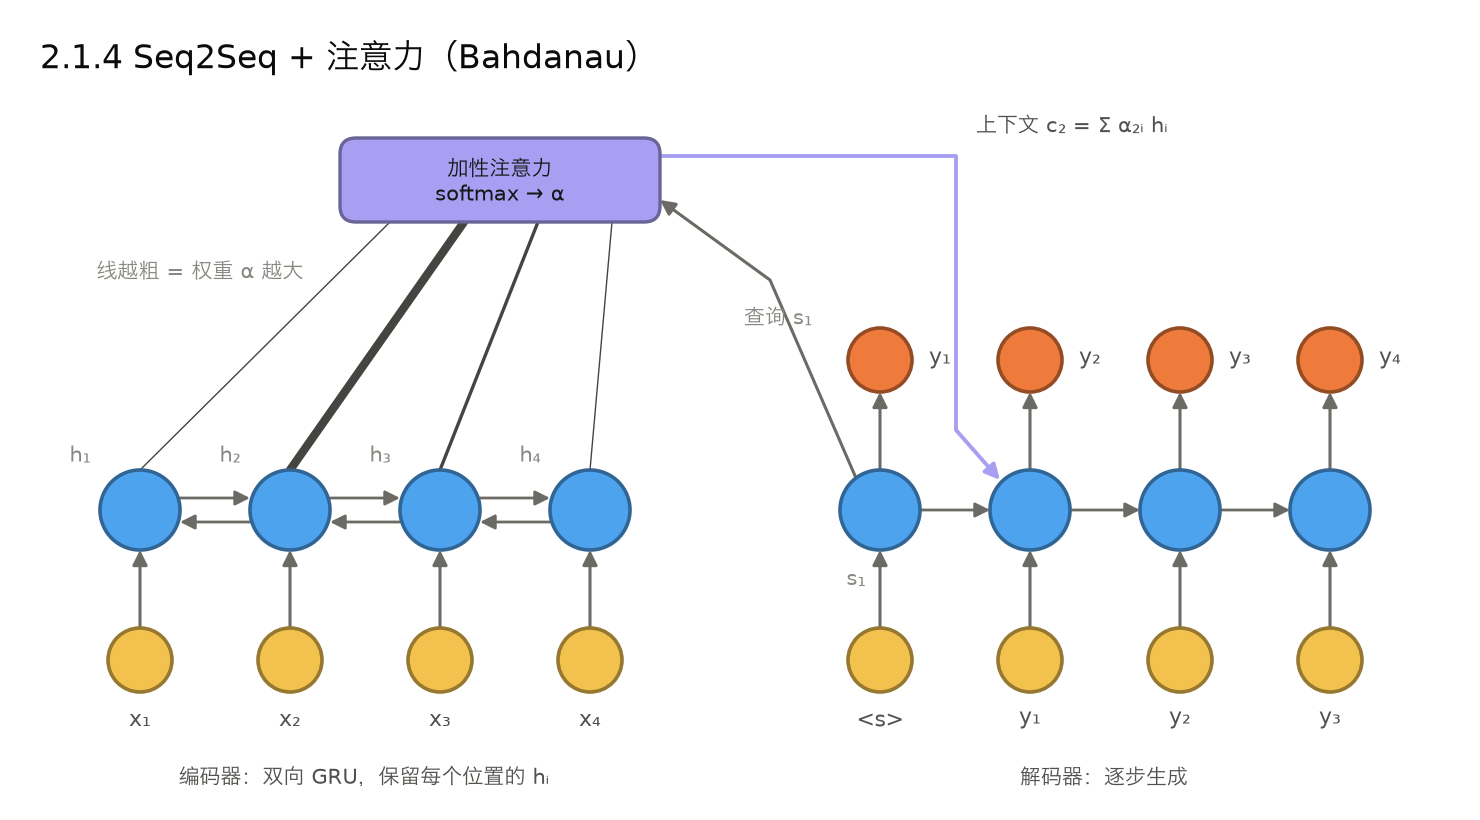
编码器 RNN 读完输入序列,解码器 RNN 逐步生成输出序列;注意力让解码器每一步都能回头看输入的任意位置。
编码器-解码器(Sutskever 2014):编码器把整个输入压成一个固定长度的向量,解码器从这个向量出发生成输出。问题是长句子的信息全挤在一个向量里,句子越长效果越差。
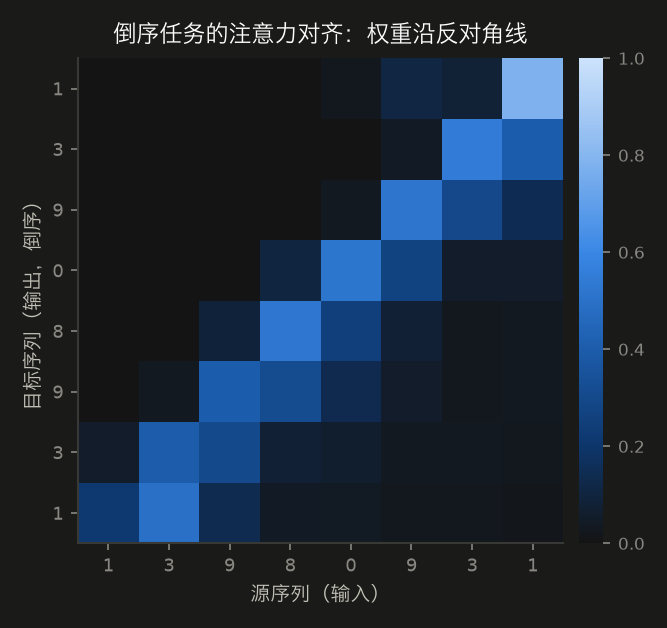
加注意力(Bahdanau 2014):编码器保留每个位置的隐状态 h_1…h_S。解码器在第 t 步用自己的状态 s_{t−1} 当 Query,对所有 h_i 打分、softmax、加权求和,得到这一步专属的上下文向量 c_t:
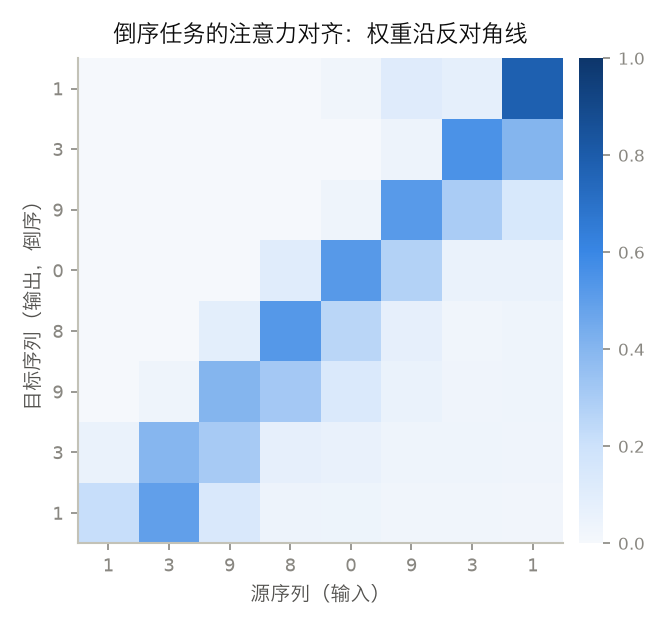
注意力权重 α 画出来,常能看出输入与输出之间的对齐关系。三年后 Transformer 把 RNN 整个去掉,只留注意力。
训练与推理不一致:训练时解码器每步的输入是正确答案的上一个词(教师强制),推理时只能用自己上一步的输出,错误会累积,这叫 exposure bias。
1 | import torch |
典型例子
- 神经机器翻译:Google 2016 年上线的 GNMT 是 8 层 LSTM 编码器-解码器加注意力
- 语音识别:Listen, Attend and Spell
- 图像描述:Show, Attend and Tell,生成每个词时注意力落在图像的对应区域
- 文本摘要
- 优势:输入输出长度可以不同;注意力去掉了固定长度向量的瓶颈,长句效果大幅提升;对齐关系可以可视化(权重高不直接等于对输出的因果贡献)
- 局限:编码器、解码器都是 RNN,训练不能沿时间并行;逐步解码,误差累积;主流任务上大多已换成 Transformer,流式语音识别等场景仍有用循环解码器的
- 适合的数据:序列到序列的转换:翻译、摘要、语音转文字、图像描述;今天主要作为理解 Transformer 来历的一环