深度学习与神经网络13
第三部分 组合与范式
3.1 预训练、迁移学习与微调
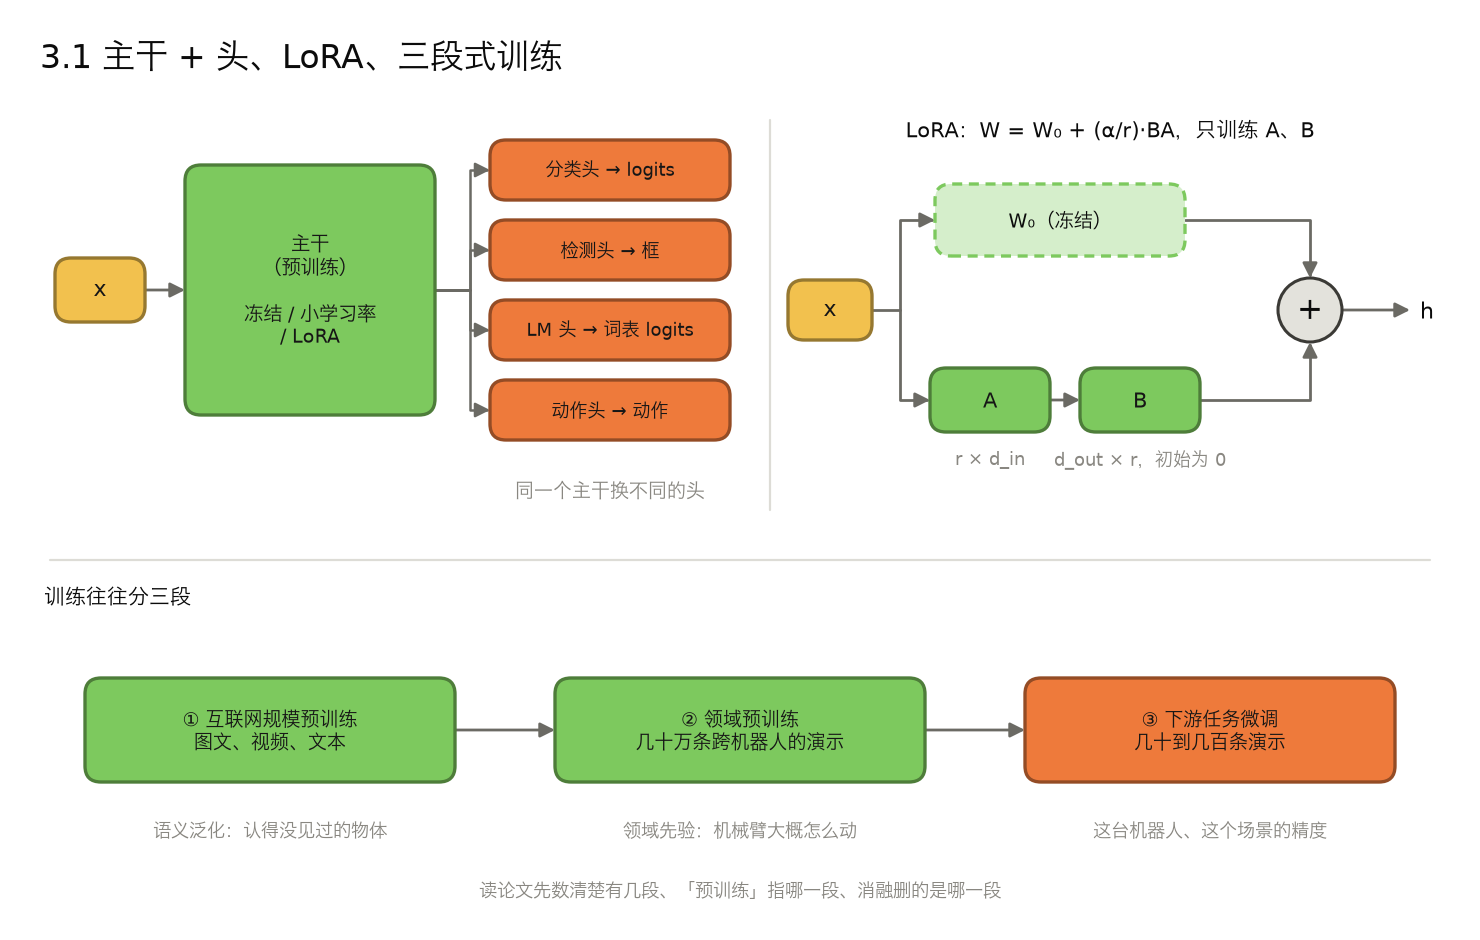
主干与头:一个模型通常分成两段。主干(backbone,也叫基座) 把原始输入变成通用特征,参数多、通常来自预训练;头(head) 是装在主干输出端的小模块,把通用特征变成具体任务的输出。同一个主干换不同的头就能做不同任务:
| 头 | 输出 |
|---|---|
| 分类头 | 类别 logits |
| 检测头 | 框的坐标和类别 |
| 语言模型头(LM head) | 词表上的 logits |
| 动作头 | 机器人动作(直接回归、离散 token,或者一个扩散/流匹配生成器) |
迁移学习的几种做法
| 做法 | 训练什么 | 什么时候用 |
|---|---|---|
| 特征提取 | 冻结主干,只训练新的头 | 数据很少;新任务和预训练任务很像 |
| 全量微调 | 主干和头一起训,主干用小学习率 | 数据较多;新任务和预训练差别较大 |
| 部分微调 | 只解冻靠近输出的几层 | 介于两者之间 |
| 分层学习率 | 主干学习率比头小一个数量级 | 全量微调时的常见设置 |
| 参数高效微调(LoRA 等) | 冻结原权重,只训练少量新增参数 | 大模型、显存有限 |
「基座」不等于冻结:基座只说明权重从哪里初始化,训练时锁不锁住是另一个决定。机器人上的两个例子:OpenVLA 冻结视觉编码器时成功率 47.0%,微调视觉编码器 69.7%(论文这组实验用的是只带 SigLIP 编码器的较小版本);Diffusion Policy 的消融里,冻结预训练的 ResNet 明显差于从头训练(ResNet-18:0.58 对 0.94),用小 10 倍的学习率微调预训练编码器整体最好(CLIP 预训练的 ViT-B 0.98);ViT 从头训练只有 0.22,作者认为是数据太少。一种解释是互联网预训练学的是「这是什么」,机器人还需要「它在哪、离夹爪多远」这样的空间精度。
训练往往分三段
- ① 互联网规模预训练(图文、视频、文本)→ 语义泛化:认得没见过的物体、听得懂新说法
- ② 领域预训练(如几十万条跨机器人的演示)→ 领域先验:机械臂大概怎么动
- ③ 下游任务微调(目标任务几十到几百条演示)→ 这台机器人、这个场景的精度
读论文时先数清楚它有几个阶段、「预训练」指的是哪一段、消融实验删的是哪一段。同一个词 “scratch”,在一篇论文里可能是「完全随机初始化」,在另一篇里只是「跳过第 ② 段」。
灾难性遗忘:只用新数据微调,模型会把旧能力忘掉。常见对策是混合训练(co-fine-tuning:新旧数据混在一起喂)、降低学习率、只训练少量新增参数。
LoRA(低秩适配,Hu 2021):冻结原权重 W₀,给它加一个低秩的「补丁」:低秩因子是 BA,实际的增量是 ΔW = (α/r)BA,只训练 A 和 B:
B 初始化为 0,所以训练开始时模型和原模型完全一样;训练完可以把 (α/r)BA 加回 W₀,合并成一个线性层,推理没有额外开销(缩放已经并进 A 或 B 时,才能直接加 BA)。OpenVLA 论文的这组实验里,rank 32 的 LoRA 只训练 1.4% 的参数,成功率 68.2%,和全量微调的 69.7% 接近;batch 16 时显存从约 163 GB(全量微调,两张 GPU 用 FSDP 分片)降到约 60 GB;rank 从 32 加到 64,平均成功率没有提升。这组实验用的是只带 SigLIP 编码器、在较小的机器人数据混合上预训练的版本,不是公开的 DINOv2 + SigLIP 检查点,数字不能直接套到别的配置上。QLoRA 再把冻结的原权重量化到 4 bit,进一步省显存。
参数量的口径:「7B 模型」通常只按语言模型主干算,不含视觉编码器。比如 OpenVLA 叫 7B,实际约 7.5B(权重文件共 75.4 亿个参数):除了 Llama 2 7B 主干,还有 DINOv2 + SigLIP 两个视觉编码器(论文说约 6 亿参数)和一个投影层。比较参数量、估显存时要先对齐口径。
1 | import torch |
3.2 真实系统怎么拼
前面各节讲的都是零件。真实系统是若干零件按「编码 → 融合 → 生成 / 判别」接起来的。下面四个系统,括号里是对应的章节。
3.2.1 Stable Diffusion(文生图)
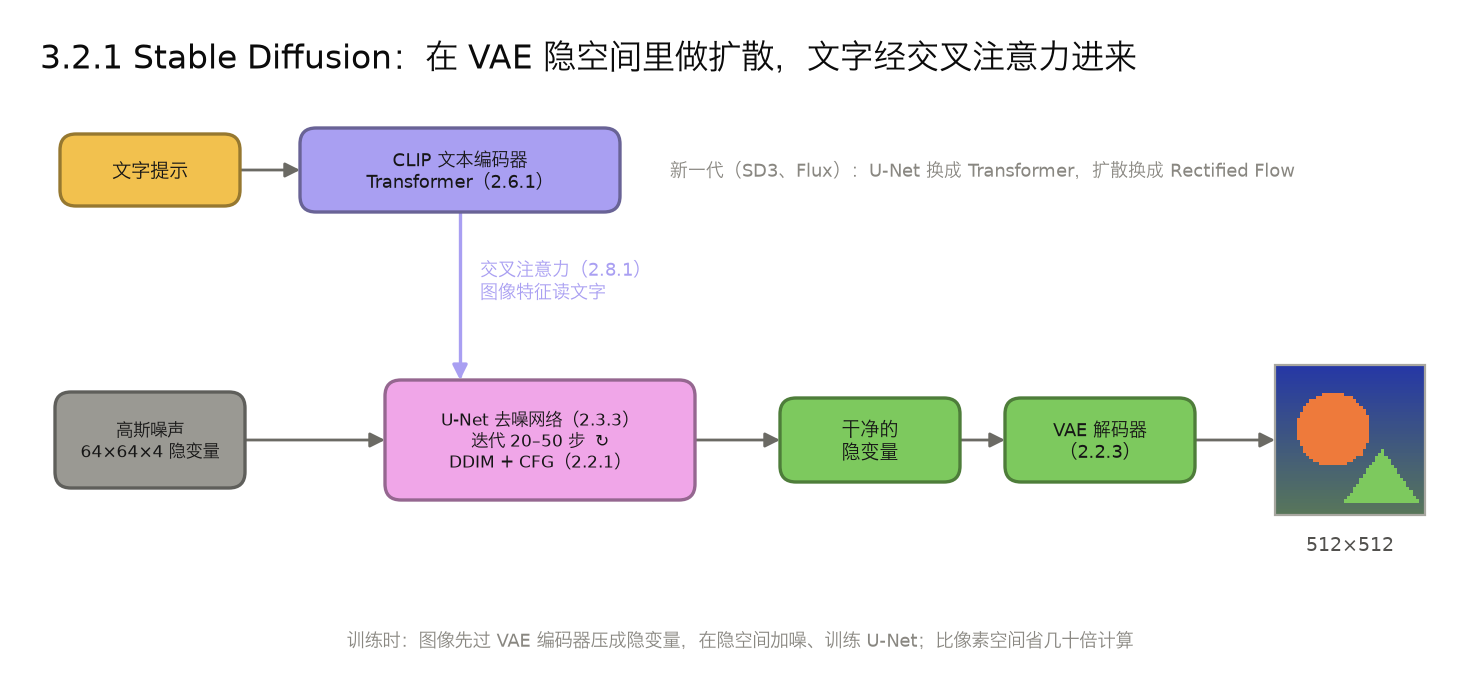
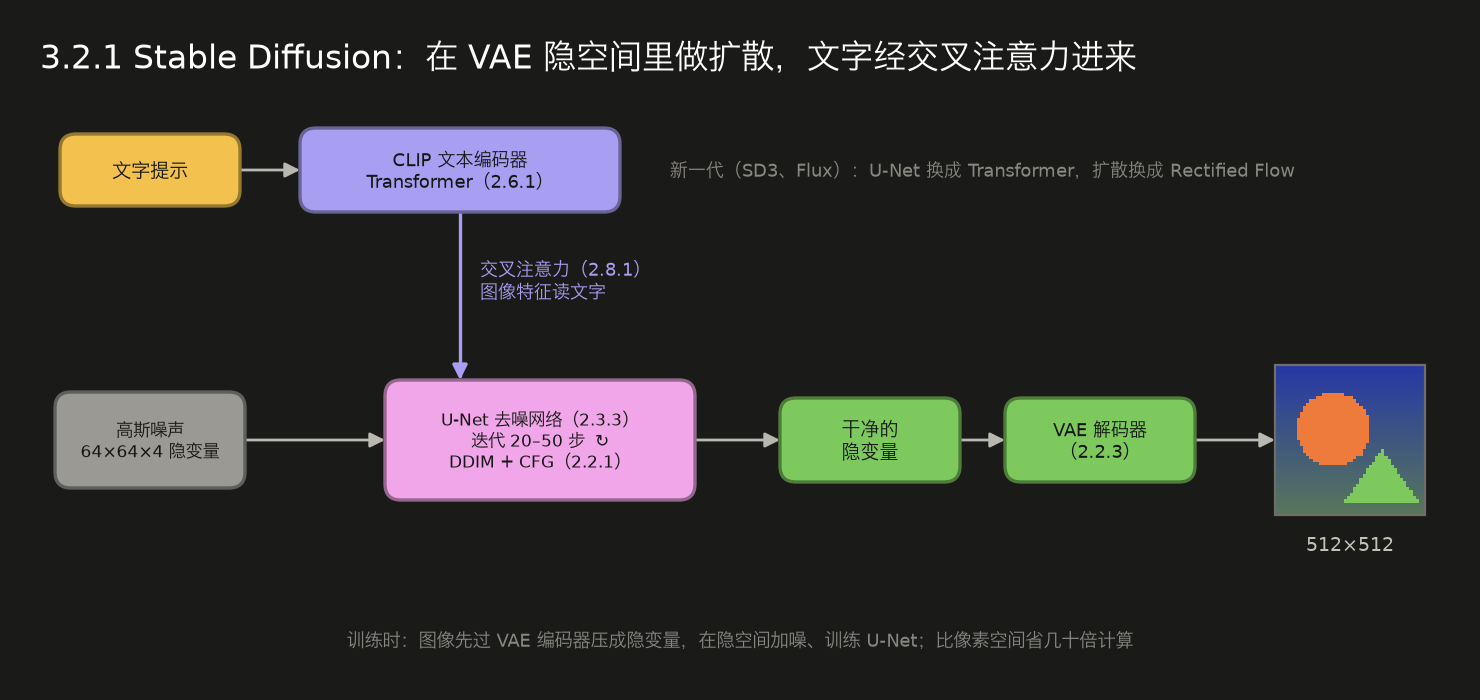
- 扩散在 VAE 的隐空间里做(潜空间扩散),比直接在像素上做省几十倍计算
- 文字条件通过 U-Net 多个分辨率上的交叉注意力进入;无分类器引导(CFG)让结果更贴合文字
- 新一代(SD3、Flux)把 U-Net 换成 Transformer,把扩散换成 Rectified Flow(2.2.2)
3.2.2 Diffusion Policy(视觉运动策略)
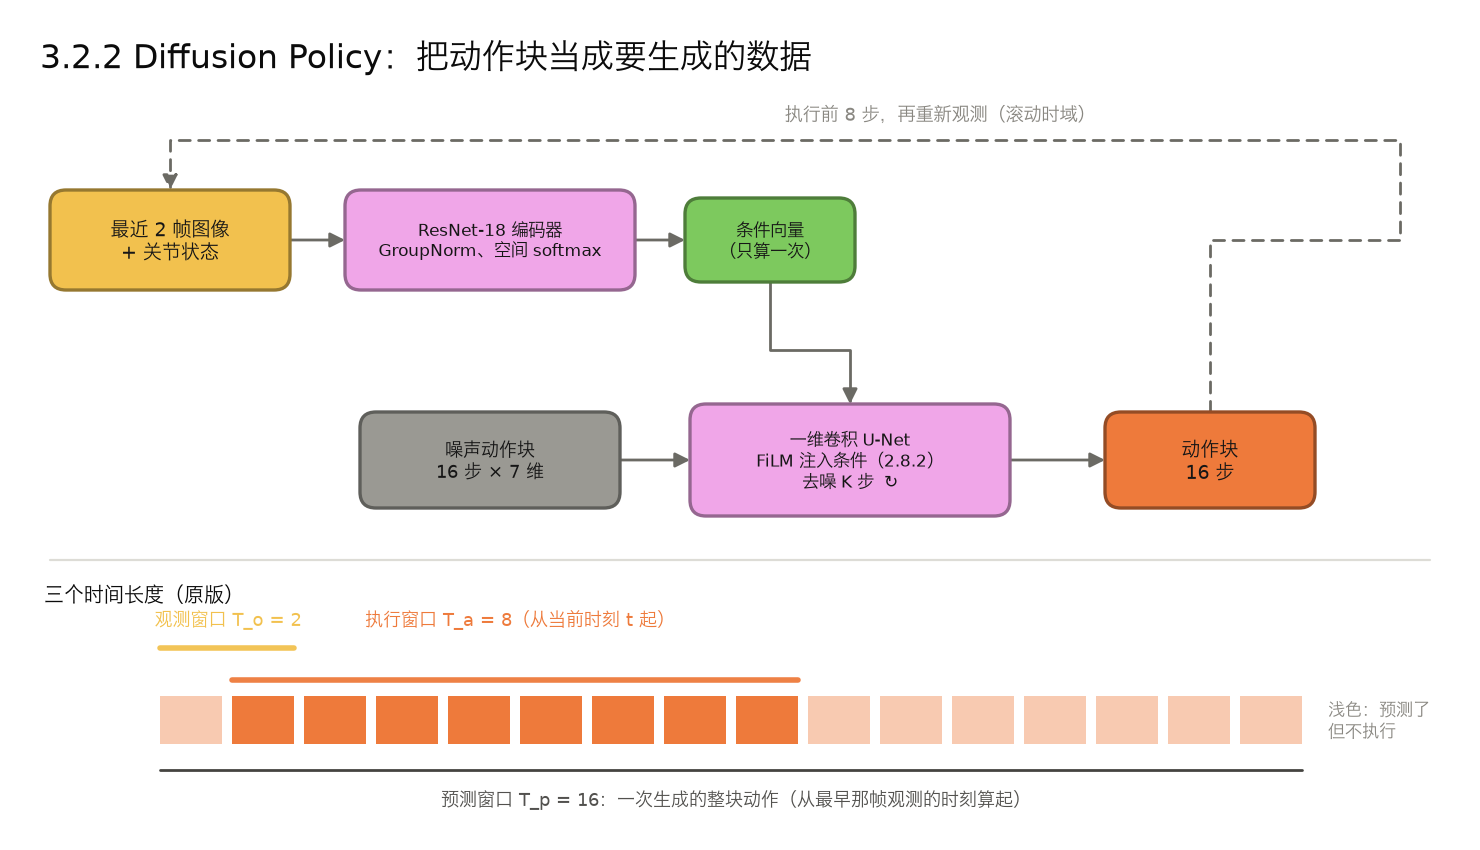
- 把动作当成要生成的数据:同一个观测下演示可能有几种都对的做法(从左绕、从右绕),扩散模型能学下这个多峰分布,回归会平均成撞上去(1.4、2.2.0)
- 动作分块(action chunking):三个时间长度。观测窗口 T_o(看最近几帧,原版 2)、预测窗口 T_p(一次生成几步,原版 16)、执行窗口 T_a(实际执行几步,原版 8)。预测窗口从过去第 T_o − 1 步开始,实际执行的是从当前时刻起的 T_a 步;执行完再重新观测、重新生成(滚动时域,和模型预测控制同一个思路)。一次生成一整块,块内动作连贯,不会每一步在两个峰之间来回跳
- 三种时间尺度:机器人执行动作的控制步(真实时间 t)、策略重新规划的周期(每执行 T_a 步一次)、去噪步 τ。每次重新规划时 τ 从 K 到 0 完整跑一遍,生成一整块动作;只有 T_a = 1 时,才是每个控制步都完整去噪一次。τ 是生成过程内部的坐标,要作为嵌入喂给网络
- 观测编码只算一次:图像编码器每次重新规划只跑一次,观测特征在 K 个去噪步里复用;去噪步嵌入每步都变,FiLM 的 γ、β 要每步重算,但它只是一个小 MLP,很便宜
- 代价:K 步去噪让推理比一次回归慢一到两个数量级(DDIM、一致性策略、Flow Matching 都在压这个成本)
下面是一个能跑的最小版本:二维平面上从 (0, −1) 走到 (0, 1),原点处有一个半径 0.4 的圆形障碍。演示路径先沿中线直走,到障碍物前一半向左绕、一半向右绕,绕过之后再回到中线。在直走的那一段上,「接下来往哪走」是真正的二选一。同样的网络结构,一个按扩散训练,一个直接用 MSE 回归动作块,比较两者走出来的轨迹。真实的 Diffusion Policy 用一维卷积 U-Net 对动作块去噪,这里动作块只有 8 步 × 2 维,为了在 CPU 上十几秒跑完,换成了 MLP,条件同样通过 FiLM 注入。
1 | import torch |
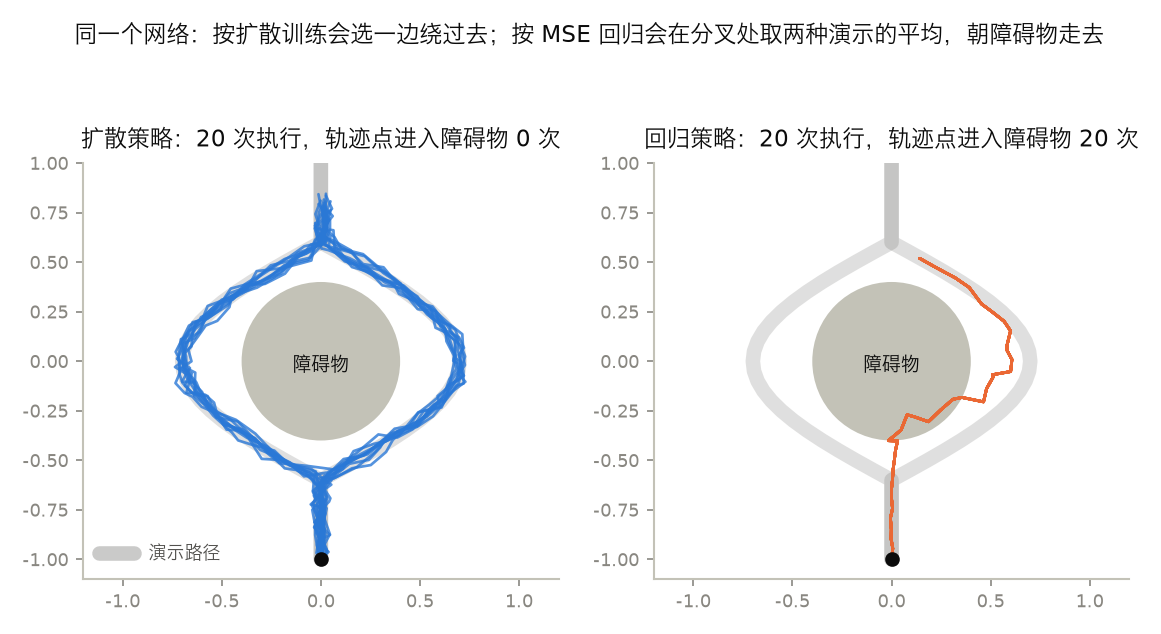
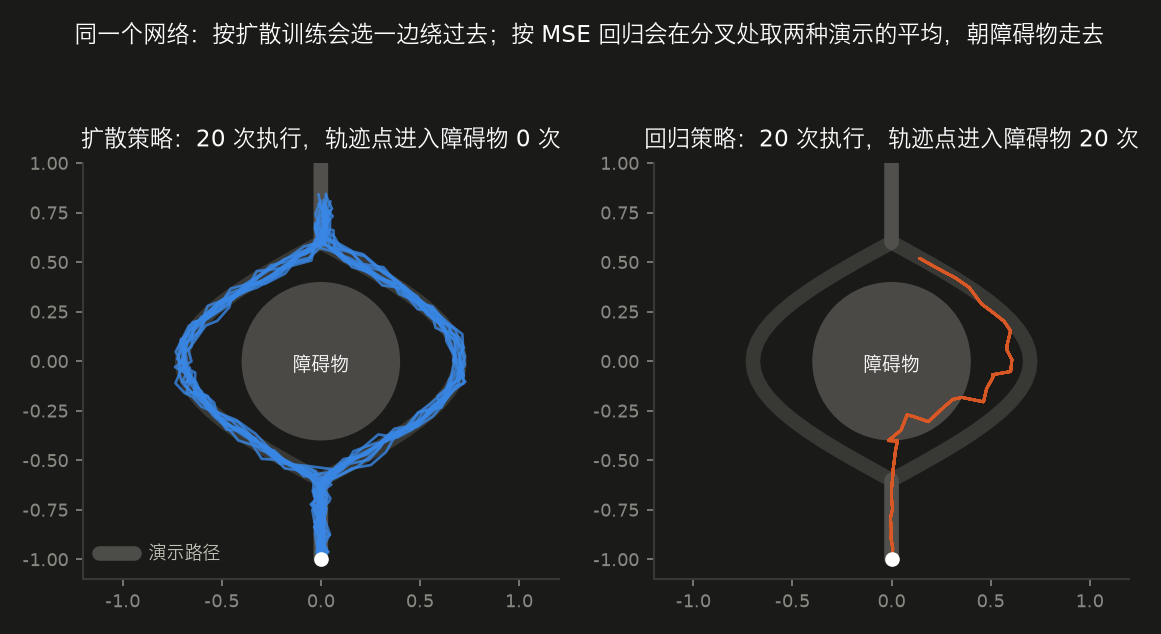
灰色宽线是演示路径。扩散策略每次从噪声出发,有的选左、有的选右,然后沿选定的一边走完。回归策略是确定性的,20 次执行完全重合:它在分叉处取了左右两种演示的平均,继续朝中间走,撞上障碍物之后才偏向一侧。
常见说法与实测
常见说法:多峰的演示数据用 MSE 回归,会把几种做法平均掉,比如「从左绕」和「从右绕」平均成直着撞上去。
实测:上面的设置(演示先沿中线直走、到障碍物前才分叉)里确实如此:回归策略 20 次的轨迹点全部进入了障碍物(回归是确定性的,20 次其实是同一条轨迹)。把演示改成从起点就分成左右两条(把 bump 换成 torch.sin(torch.pi * S)),回归策略 20 次都没有轨迹点进入障碍物,只是每次都从左边绕(同样是同一条轨迹重复 20 次);扩散策略两边都有(左 3 次、右 17 次)。这里的「撞上」「绕开」只看离散轨迹点有没有进入障碍物,没检查点与点之间的线段,也没检查是否到达终点。
怎么理解:平均的问题只出现在「同一个观测对应几种不同答案」的状态上。两条路从起点就分开时,只有起点这一个状态是二选一,回归网络在那里稍有偏向就选定了一边,之后的观测(已经偏到左边)只对应一种答案,回归就能学好。所以回归失败的程度取决于多峰状态出现在哪里、覆盖多大范围。回归的另一个问题这里也能看到:它是确定性的,每次都做同一件事,演示里的多样性丢掉了。
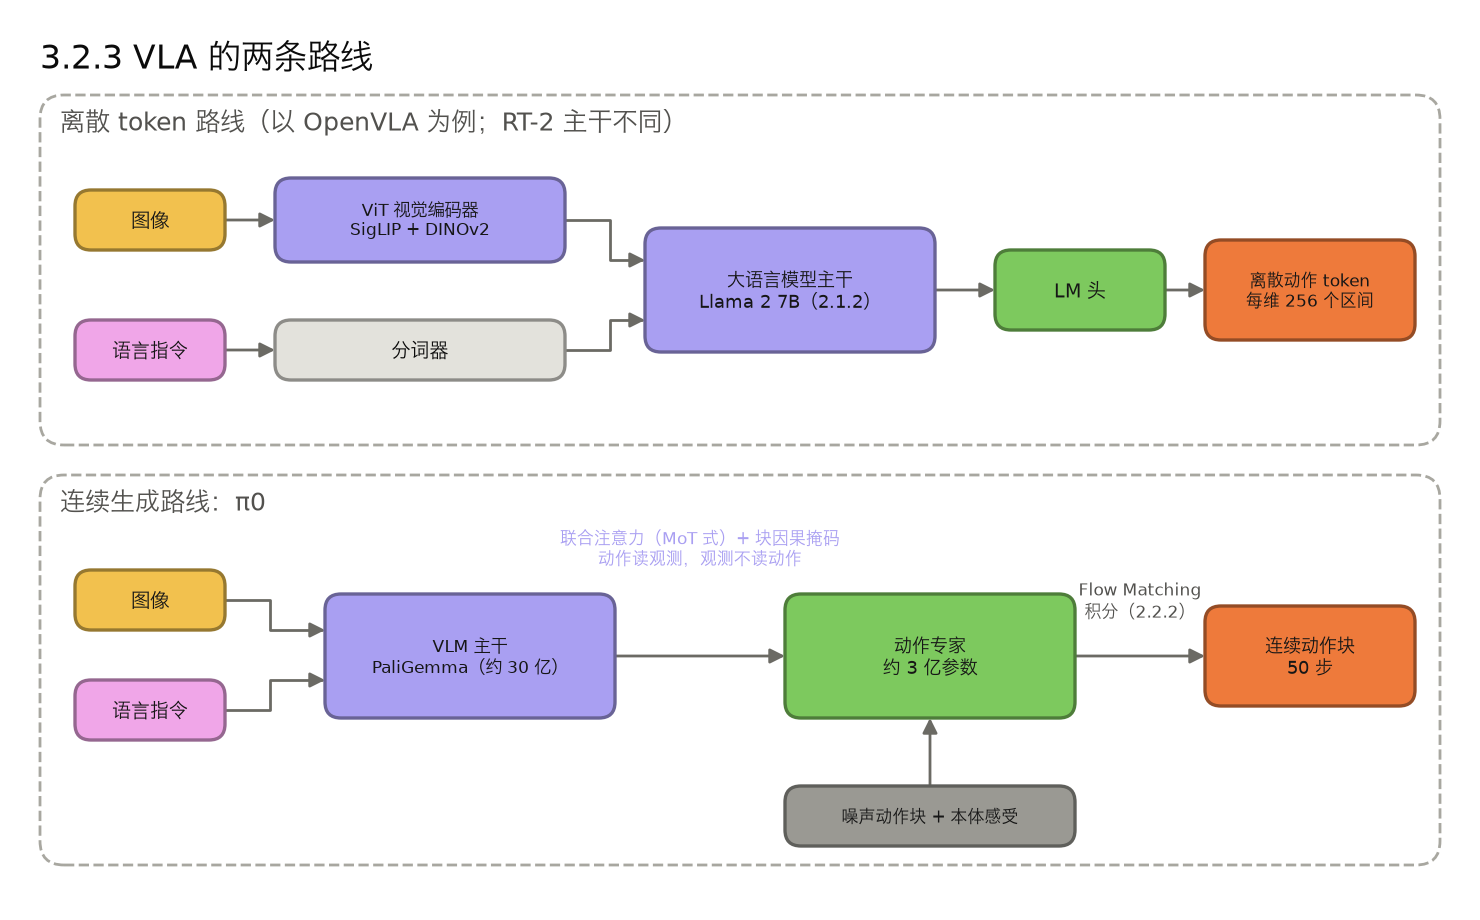
3.2.3 VLA(视觉-语言-动作模型)的两条路线
| 离散 token 路线 | 连续生成路线 | |
|---|---|---|
| 动作怎么表示 | 离散成 token。OpenVLA、RT-2 是每个维度切成 256 个区间、每个区间对应词表里的一个 token;FAST 等先对整段动作块做 DCT 压缩再分词 | 连续向量 |
| 动作头 | 通常直接复用语言模型的 LM 头,没有新结构 | 独立的扩散 / 流匹配网络(动作头或动作专家) |
| 训练目标 | 交叉熵,和训练语言模型完全一样(1.4 节的 NLL) | 去噪或速度回归的 MSE |
| 好处 | 整套大模型训练和推理设施原样复用 | 连续、精度高,一次生成一整块,适合高频控制 |
| 代价 | 量化误差;逐 token 生成,控制频率受限 | 多了一个生成器,推理要迭代 |
- 动作头与动作专家(本笔记的叫法,不同论文不统一):挂在主干末端、读主干输出的叫动作头;和主干并排、在同一个注意力里计算的叫动作专家(MoT 式耦合,π0 的做法;π0 用块因果掩码让动作读主干,主干不读动作)
- 计算不对称(连续生成路线):以 π0 为例,每生成一个动作块,主干(几十亿参数)把观测前缀算一次,前缀的 K、V 缓存起来给 K 步共用;动作专家要跑 K 次(去噪或积分)。为了满足控制频率的延迟要求,动作部分通常做得较小。离散 token 路线不一样:OpenVLA 每生成一个动作 token 都要再过一遍语言模型主干(有 KV cache 时只算新的这个位置,但要经过全部层),一个 7 维动作就是 7 次主干前向
- 参数量口径:π0 约 33 亿参数,其中 PaliGemma(SigLIP 视觉编码器 + Gemma 2B 语言模型)约 30 亿、动作专家约 3 亿
3.2.4 世界模型
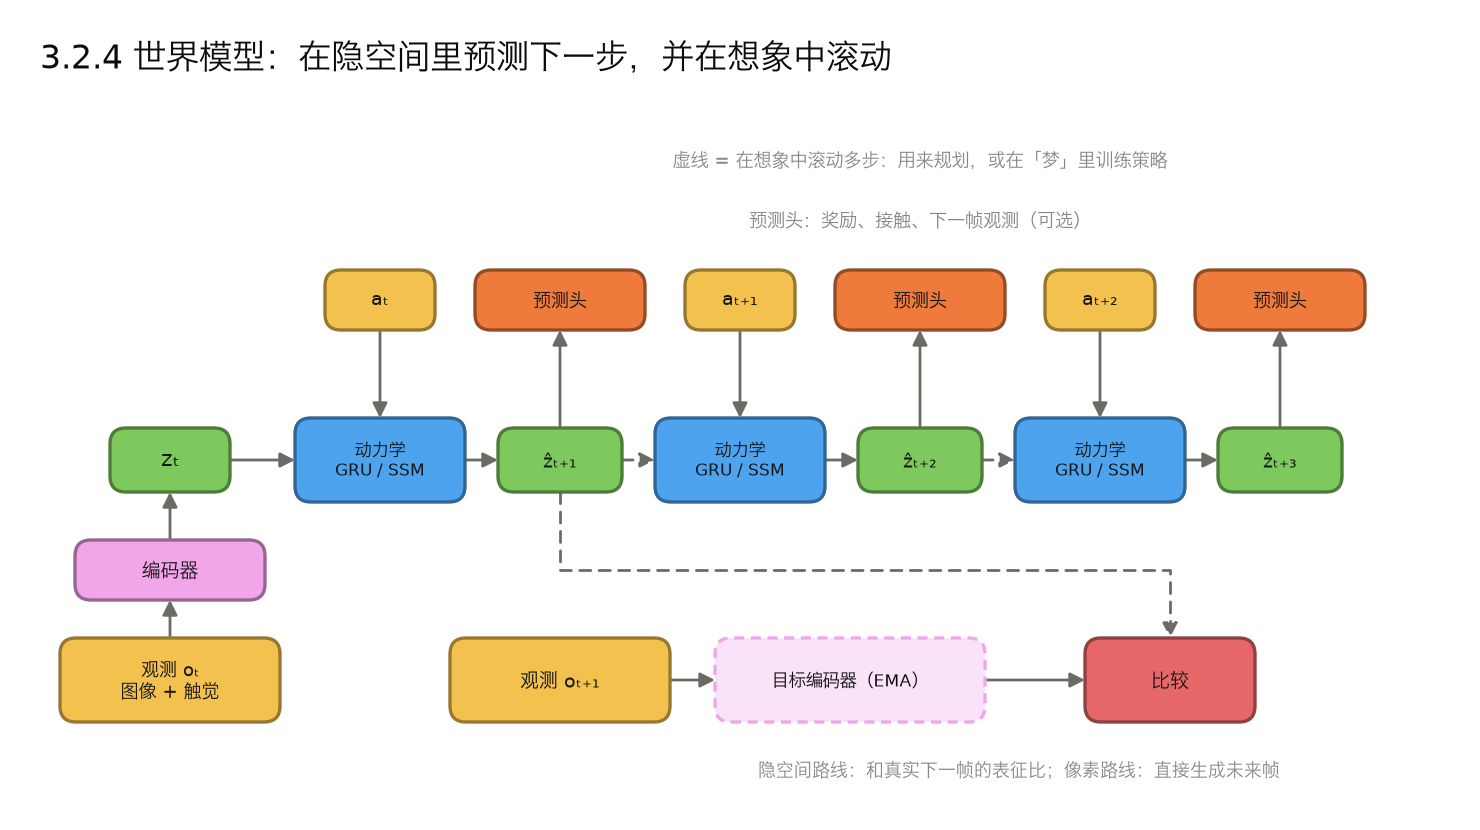
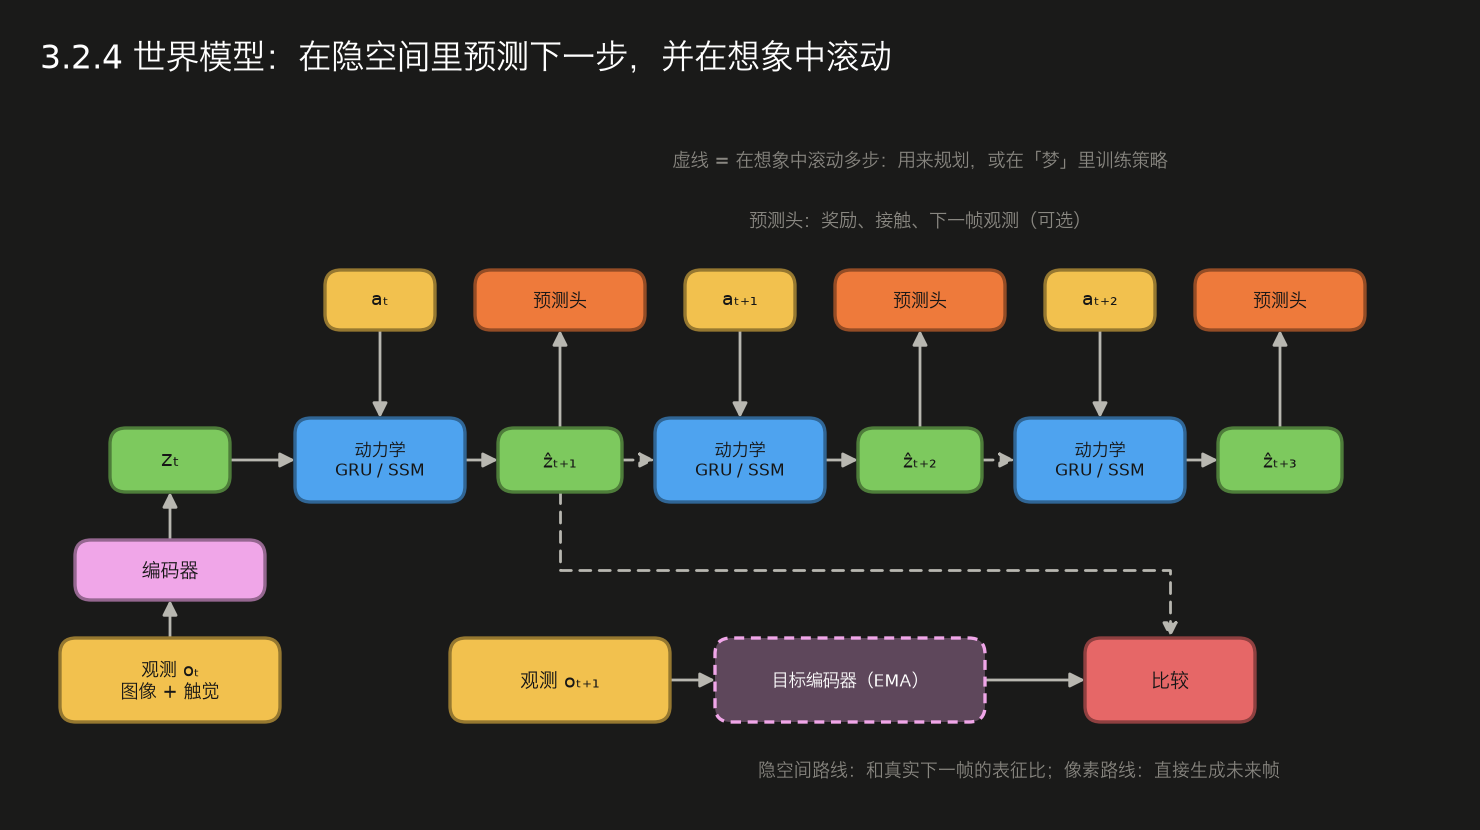
- World Models(Ha & Schmidhuber 2018):V(VAE 把画面压成 32 维 z)+ M(MDN-RNN 预测下一个 z 的混合分布,2.10.2)+ C(一个很小的线性控制器)。控制器可以完全在 M 的「梦」里训练,再搬到真实环境
- Dreamer 系列(Hafner 2019–2023):RSSM 隐状态 = GRU 的确定性部分 + 一个随机隐变量;世界模型训练时用解码器重建观测、预测奖励和是否继续,再加 KL 项;演员-评论家在隐空间想象出的轨迹上训练;DreamerV3 用一套超参在大量不同任务上通用
- 像素路线与隐空间路线:
| 像素 / 视频路线 | 隐空间路线 | |
|---|---|---|
| 预测目标 | 未来的图像帧 | 未来的隐向量,想象和规划时不还原像素 |
| 训练损失 | 重建或扩散去噪 | JEPA 类只在表征空间里比较(常配 EMA 目标编码器,2.6.3);Dreamer 类还要重建像素、预测奖励,加 KL 项 |
| 推理成本 | 高 | 低 |
| 人能不能直接检查 | 能,肉眼能看出物体凭空消失这类幻觉 | 没有解码器的(JEPA 类)不能,只能通过下游任务间接判断;Dreamer 有解码器,可以把想象的隐状态解码成图来看 |
| 特有风险 | 算力花在背景纹理这类无关细节上;长时程画面崩坏 | 不做重建时有表征塌缩风险:编码器输出常数,损失很低但没有信息 |
| 代表 | 视频生成式世界模型 | 不重建像素:V-JEPA 2、TD-MPC2;在隐空间滚动、训练时仍重建像素:Dreamer(RSSM) |
「在哪个空间里预测和规划」与「训练时要不要重建观测」是两个独立的选择:Dreamer 在隐空间里想象,但靠解码器重建图像来保证隐状态里有信息;JEPA 类两件事都不碰像素。
- 状态空间的选择:用什么变量描述「现在」(像素、隐向量、关节角和物体位姿、符号谓词)决定了动力学好不好学、误差怎么累积,也决定了哪些东西容易估计、哪些很难。比如单帧像素通常不能直接、唯一地确定摩擦、刚度、接触是否稳定,系统因此是部分可观测的;视觉交互历史和动作能提供间接的估计线索,触觉则直接测到接触,让这些变量更容易估计。加入触觉,扩展的首先是观测空间(视觉, 触觉),它帮助估计物理状态;模型可以再用历史把这些观测融合成更充分的内部状态
1 | import copy |
3.3 读一篇论文的架构
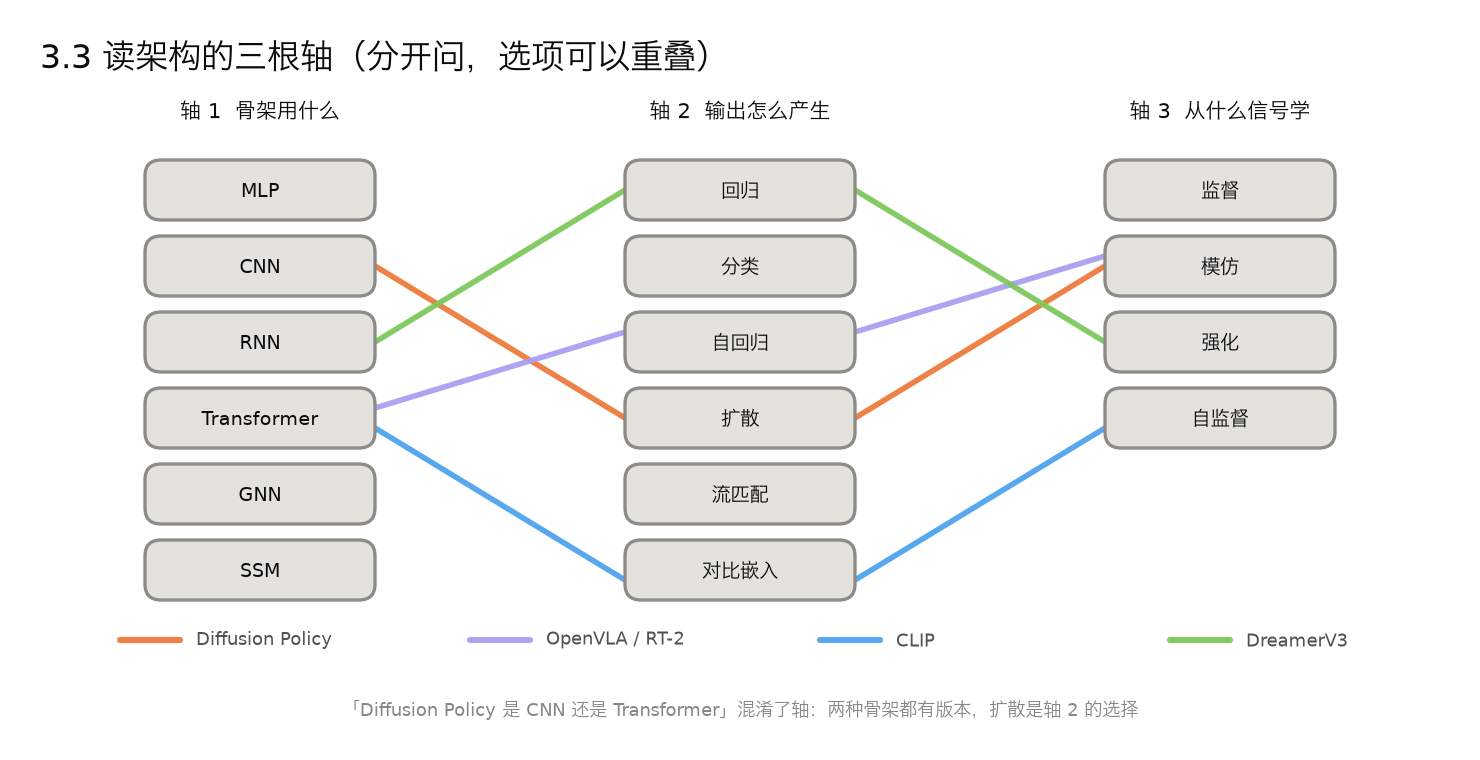
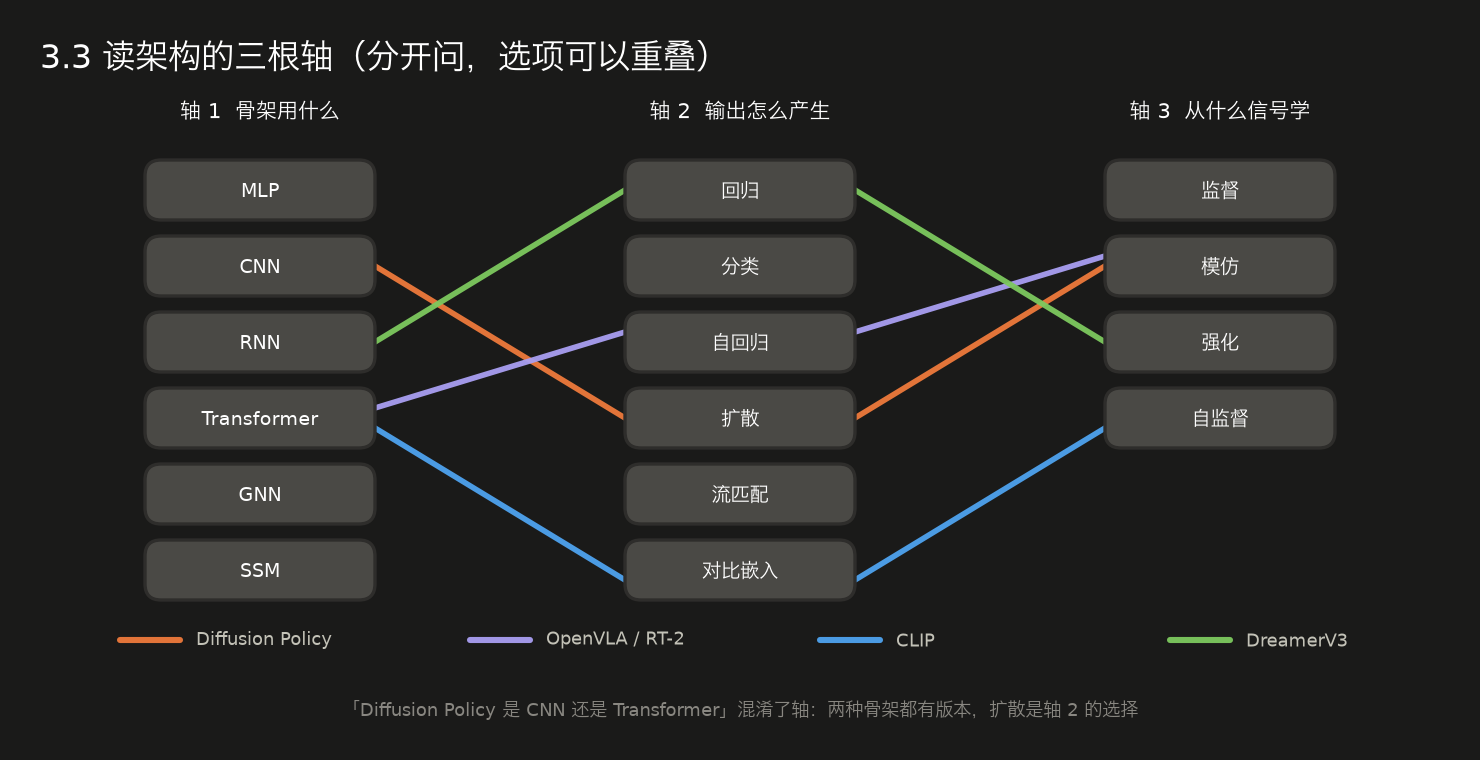
三组要分开问的问题:一篇论文要分别回答这三个问题,不要混成一句「我们用了 Transformer」。这不是互斥的分类,一个模型可以在一根轴上占好几项(比如行为克隆既是模仿学习,也是监督学习)。
- 轴 1 骨架用什么:MLP / CNN / RNN / Transformer / GNN / SSM
- 轴 2 输出怎么产生:回归 / 分类 / 自回归 / 扩散 / 流匹配 / 对比嵌入
- 轴 3 从什么信号学:监督 / 模仿 / 强化 / 自监督
| 方法 | 骨架 | 输出怎么产生 | 学习信号 |
|---|---|---|---|
| Diffusion Policy | CNN(一维 U-Net)或 Transformer | 扩散 | 模仿学习 |
| OpenVLA、RT-2 | Transformer | 自回归(离散动作 token) | 模仿学习(继承语言模型预训练) |
| π0 | Transformer(VLM + 动作专家) | 流匹配 | 预训练 + 模仿学习 |
| ACT | Transformer 编码器-解码器 | 回归 + CVAE | 模仿学习 |
| DreamerV3 | CNN + RSSM(GRU) | 世界模型 + 演员-评论家 | 强化学习 |
| CLIP | ResNet 或 ViT + 文本 Transformer | 对比嵌入 | 自监督(图文对) |
| GPT 类大模型 | Transformer | 自回归 | 自监督预训练 + 有监督微调 + 偏好对齐 |
这张表是示例性的拆解,用来提醒分开问。各栏里混着不同层级的东西:轴 2 里扩散、流匹配是生成机制,对比嵌入是训练目标;DreamerV3 的「世界模型 + 演员-评论家」是系统组成,π0 的「预训练」是训练阶段。所以它算不上一套严格正交的分类。
「Diffusion Policy 是 CNN 还是 Transformer」是个混淆了轴的问题:它两种骨架都有版本,扩散是轴 2 的选择。
几个「动词」:把一个系统拆成网络在做的几种基本操作,看它们怎么接线。
| 动词 | 方向 | 例子 |
|---|---|---|
| 编码 / 表征 | 观测 → 隐空间 | 所有主干网络 |
| 生成 / 解码 | 隐空间 + 噪声 → 观测空间 | 扩散、VAE 解码器、自回归 |
| 判别 / 评分 | 输入 → 类别或标量 | 分类器、奖励模型、价值函数 |
| 对齐 | 隐空间 × 隐空间 → 距离 | 对比学习、蒸馏、JEPA |
| 检索 / 注意 | 查询 × 存储 → 相关内容 | 注意力、RAG |
| 规划 / 搜索 | 系统层:反复调用上面几种 | 模型预测控制、MCTS |
「预测未来」属于任务,可以用生成(视频世界模型)、对齐(JEPA 式隐空间预测)或判别(预测成功与否的评分器)来实现。
读架构时的三个问题
- 它对数据做了什么假设(1.11 的归纳偏置表)?手头的数据量撑不撑得起这个假设?
- 参数和计算花在哪?比如 FFN 占 Transformer 参数的 2/3、动作头每生成一个动作块要跑 K 次
- 延迟预算是多少?要跑几百 Hz 的控制回路时,大 Transformer 和多步扩散都要重新考虑;这常常比精度更先成为约束
第四部分 按数据结构选网络
4.1 总表
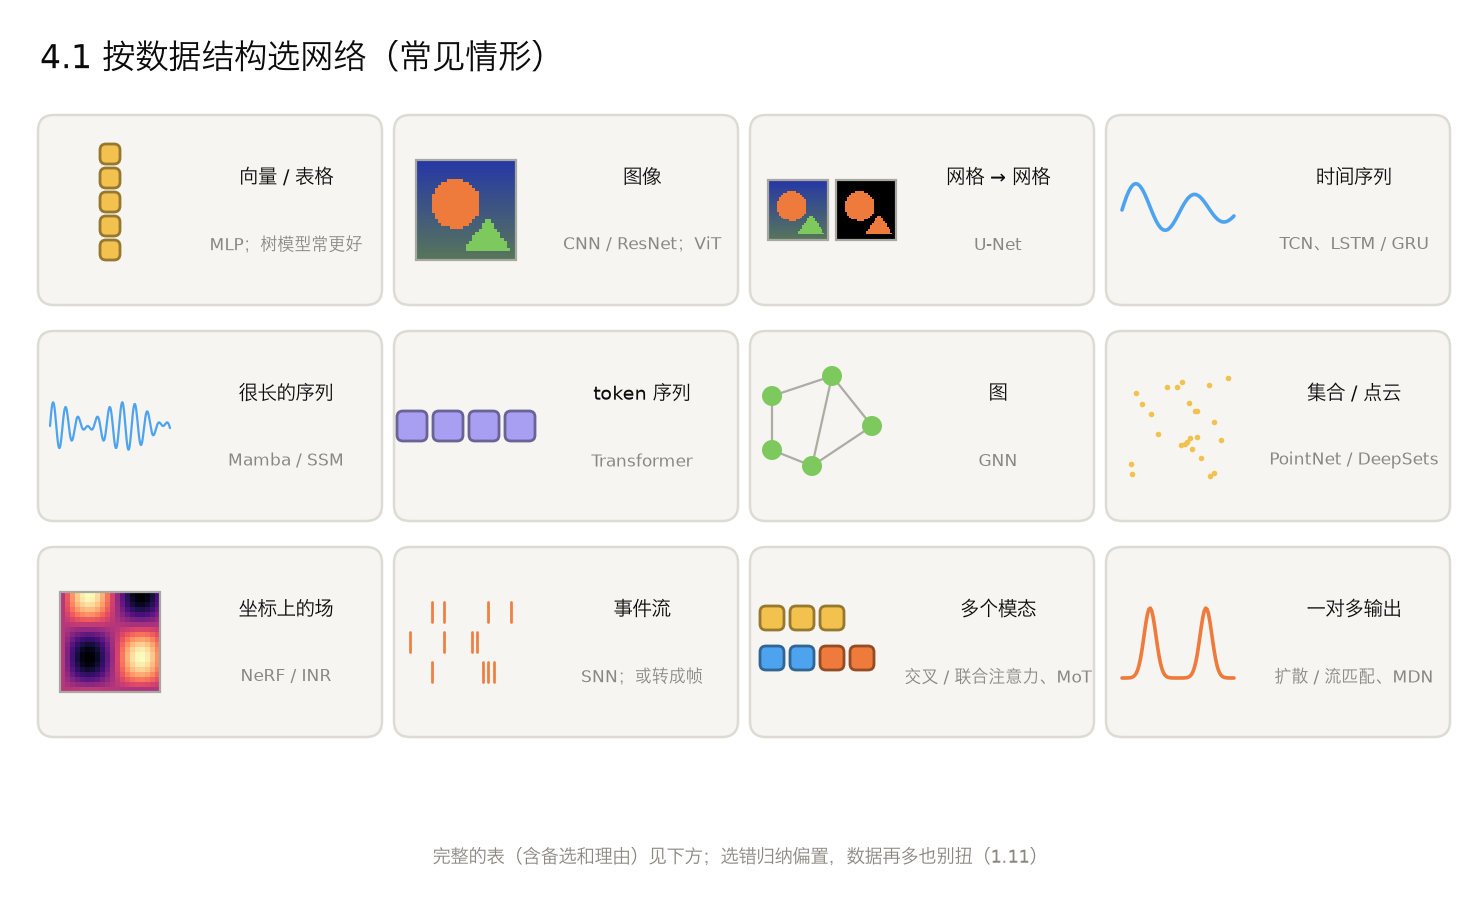
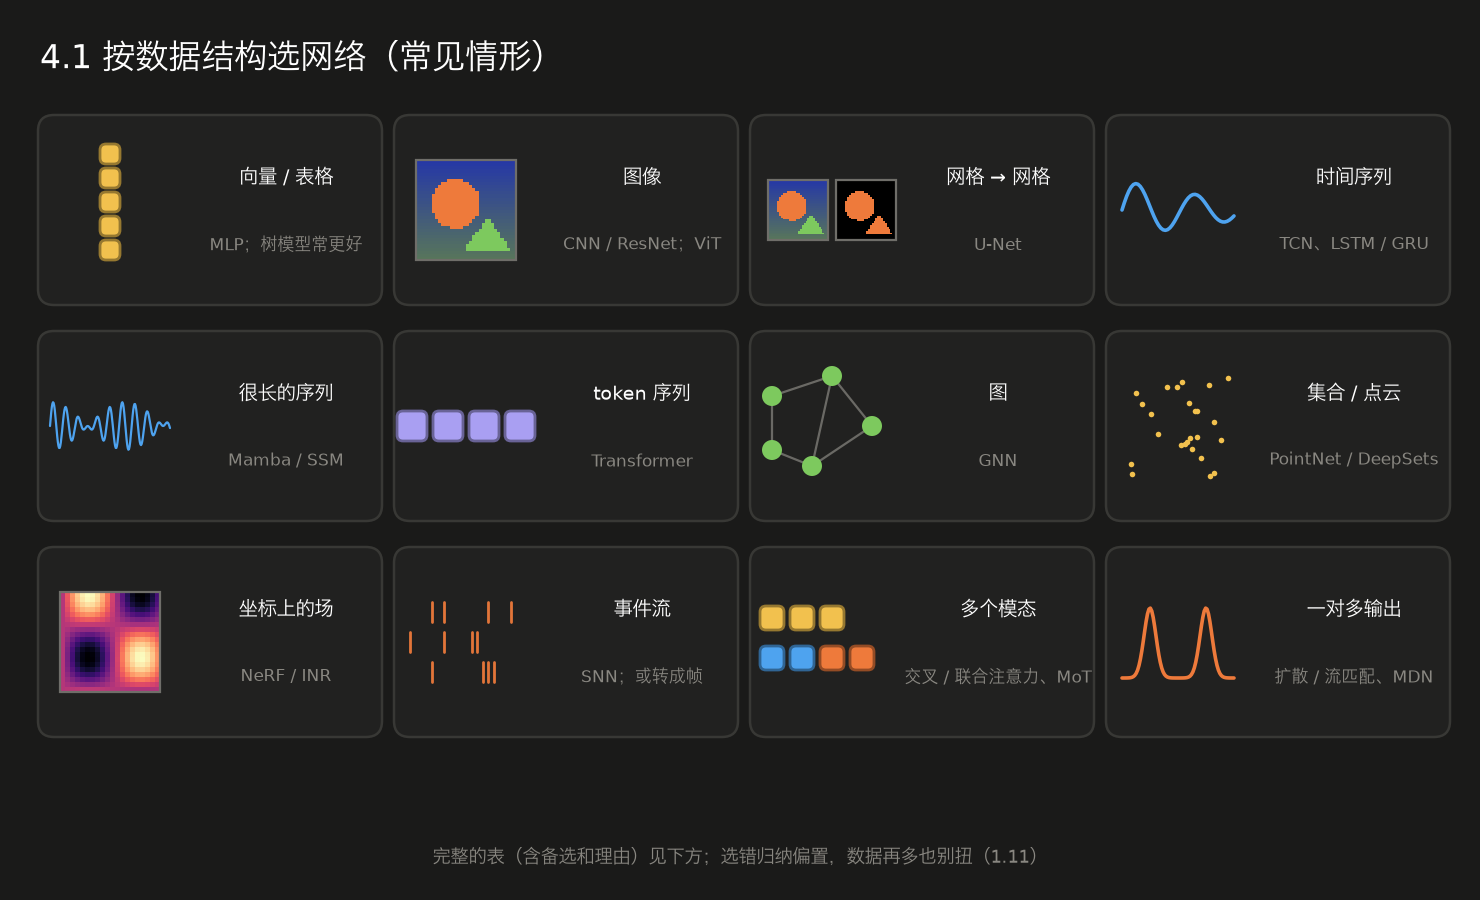
| 数据结构 | 例子 | 常用起点 | 也常用 | 理由(对应的归纳偏置) |
|---|---|---|---|---|
| 固定长度向量(表格) | 用户特征、关节角、低维物理状态 | MLP(2.4.1) | 梯度提升树常更好;小样本用 SVM(2.15.1)、RBF(2.4.5) | 各维度含义不同、没有局部结构 |
| 图像(2D 网格) | 照片、视触觉图像、深度图 | CNN / ResNet(2.3.1、2.3.2) | ViT(数据多或有预训练,2.1.3) | 局部性 + 平移等变 |
| 网格 → 网格(稠密预测) | 分割、去噪、深度估计 | U-Net(2.3.3) | ViT + 稠密解码头 | 输出逐像素对齐 |
| 图像中的多个物体 | 检测、实例分割 | YOLO、Mask R-CNN(2.3.4) | DETR | 既要「是什么」也要「在哪」 |
| 一维时间序列 / 信号 | 力/力矩、IMU、振动、音频波形 | TCN、1D CNN(2.3.5);LSTM / GRU(2.5) | Transformer、Mamba | 时序、因果、局部模式 |
| 很长的序列 | 基因组、长音频、长观测历史 | Mamba / SSM(2.5.3) | 长上下文 Transformer | 线性复杂度、恒定推理显存 |
| 离散 token 序列 | 文本、代码 | Transformer(2.1) | RNN、SSM | 长程依赖、可并行训练 |
| 视频 | 动作识别、视频生成 | 视频 Transformer、3D CNN | CNN + RNN | 时空结构 |
| 图 | 分子、路网、运动学链 | GNN(2.9.1) | 图 Transformer | 不规则连接 + 节点顺序无关 |
| 集合 / 点云 | 激光雷达、接触点、检测框集合 | PointNet / DeepSets(2.9.2) | Point Transformer、DGCNN | 元素无序、数量可变 |
| 连续坐标上的场 | 三维场景、SDF、物理场 | NeRF / INR(2.11.1) | 3D Gaussian Splatting | 任意分辨率查询 |
| 事件流 / 脉冲 | 事件相机、事件式触觉 | SNN(2.13.1) | 转成帧后用 CNN / Transformer | 稀疏、异步 |
| 不规则采样的时间序列 | 病历、异步传感器 | Neural ODE / Latent ODE(2.11.2) | 带时间编码的 Transformer | 连续时间 |
| 成对的多模态数据 | 图文对、视觉-触觉对 | 对比学习双塔(2.6.1) | 交叉注意力融合(2.8.1) | 配对关系本身就是监督 |
| 多个异构模态一起决策 | 视觉 + 语言 + 动作 + 触觉 | Transformer + 交叉/联合注意力或 MoT(2.7.2、2.8) | FiLM、门控 | 各模态性质不同、作用随阶段变化 |
| 一对多映射(多峰输出) | 逆运动学、机器人动作 | 扩散 / 流匹配(2.2.1、2.2.2) | MDN(2.10.2)、CVAE、离散化 + 交叉熵 | 回归会把多个解平均掉 |
| 要生成新样本 | 图像、音频、分子 | 扩散 / 流匹配 | VAE、GAN、自回归、标准化流 | 见 4.3 |
| 无标签数据想学特征 | 大量图像、传感器记录 | 对比学习、MAE、DINO(2.6) | 自编码器 | 见 4.4 |
| 无标签数据想聚类或可视化 | 高维特征 | 自编码器(2.6.4)、SOM(2.15.2) | t-SNE、UMAP | 降维、拓扑保持 |
| 小数据的低维动力学 | 混沌系统、信号均衡 | ESN(2.14.1) | Neural ODE、GRU | 训练只需一次线性回归 |
| 二值模式的存储与补全 | 黑白图、二进制码 | Hopfield(2.12.1) | RBM(2.12.3) | 能量谷底即记忆 |
这张表只按数据结构给常用起点,实际选择还要看任务目标、数据量、有没有可用的预训练模型、延迟和硬件预算。
4.2 序列模型对比
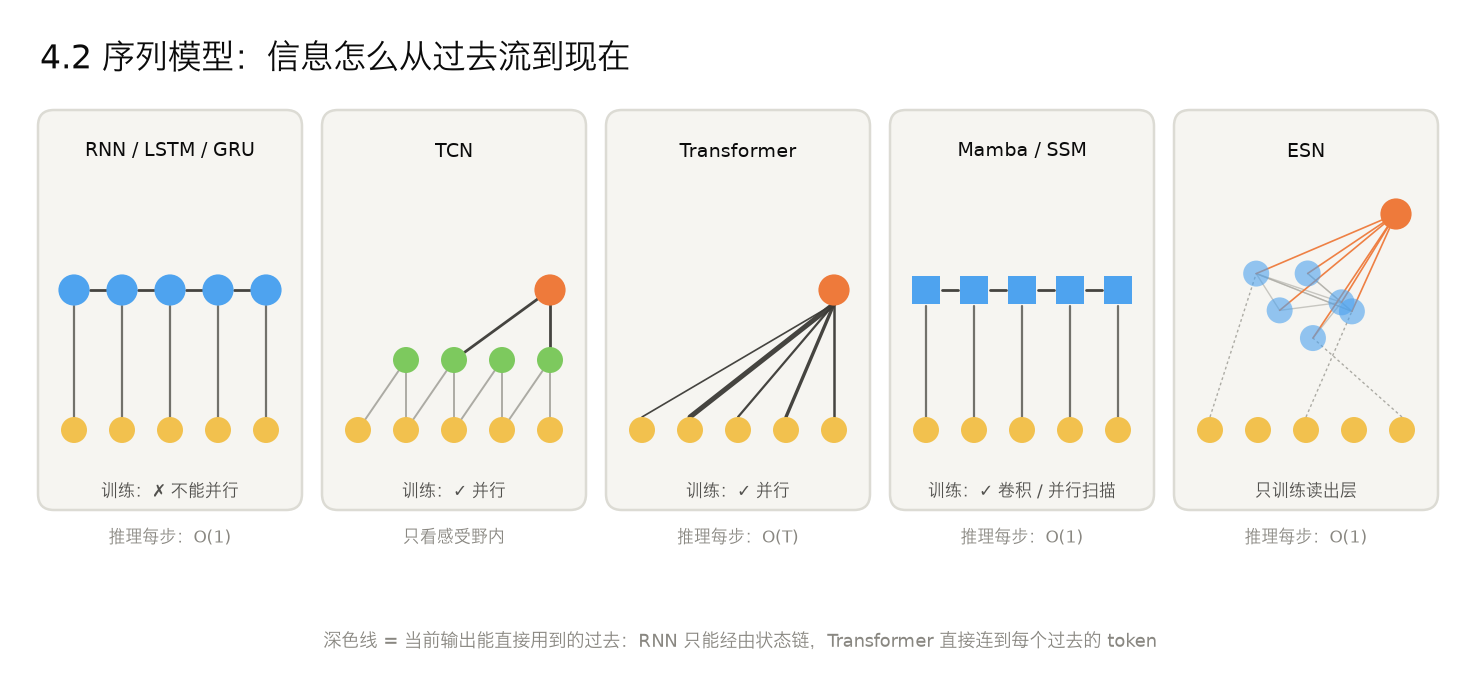
| 训练能否沿时间并行 | 推理每步代价(相对已处理的长度 T) | 记忆形式 | 长程依赖 | 适合的长度 | |
|---|---|---|---|---|---|
| 普通 RNN | 否 | O(1) | 固定大小的隐状态 | 弱(经验上十几步) | 短 |
| LSTM / GRU | 否 | O(1) | 固定大小的隐状态 + 门控 | 中(经验上几百步) | 中 |
| TCN | 是 | 只依赖感受野内的历史 | 感受野内的原始输入 | 受感受野硬性限制 | 中 |
| Transformer | 是 | O(T)(有 KV cache) | 整个上下文 | 强 | 长(受 O(T²) 计算量限制) |
| Mamba / SSM | 是(卷积或并行扫描) | O(1) | 固定大小的状态 + 选择机制 | 强,但精确回忆任意片段不如注意力 | 很长 |
| ESN | 只训练读出层 | O(1) | 随机储备池的衰减记忆 | 弱到中 | 短到中 |
4.3 生成模型对比
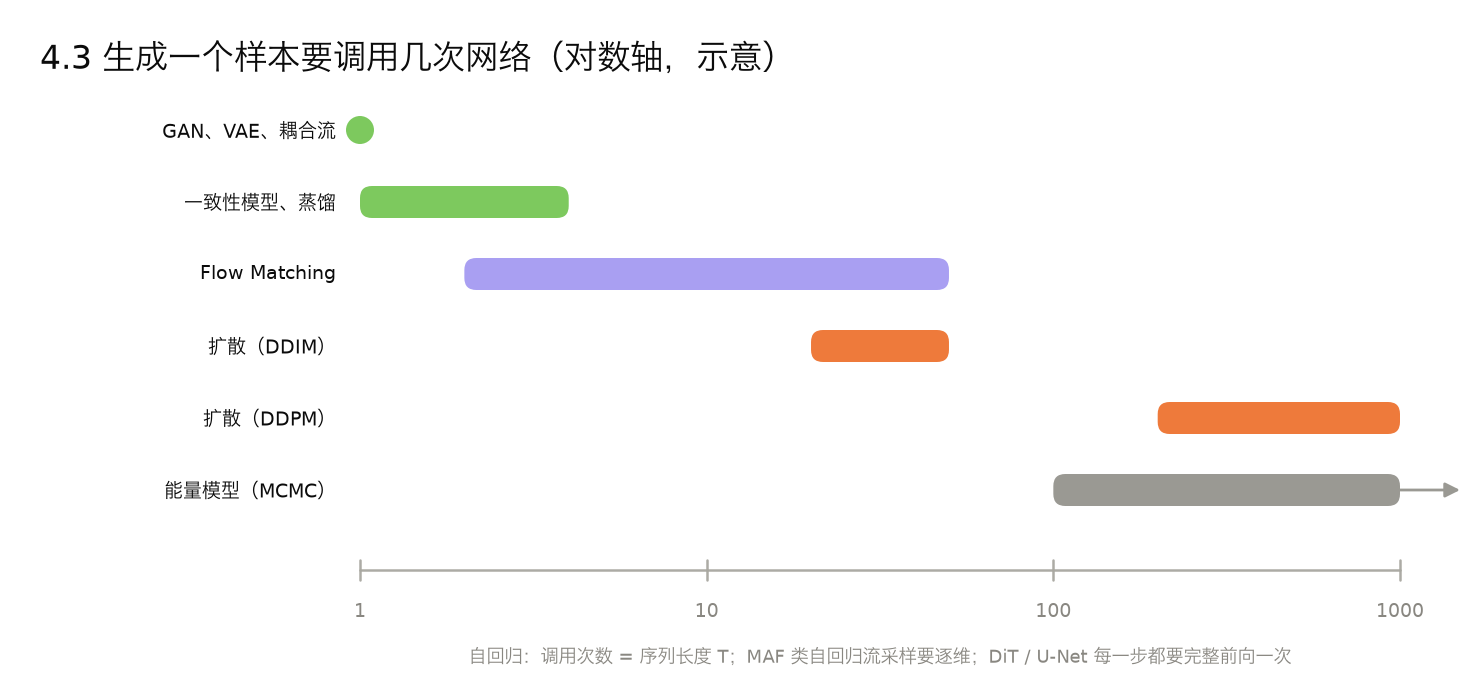
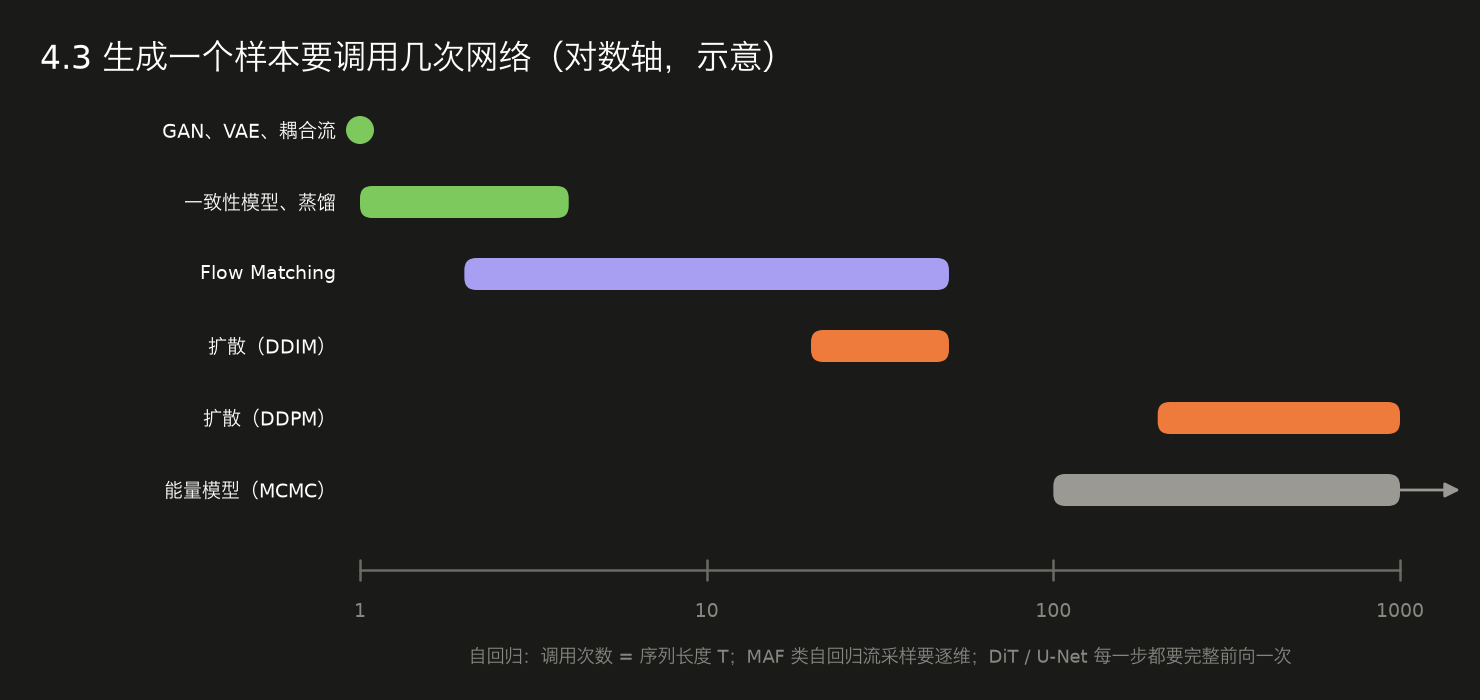
| 怎么得到样本 | 生成速度 | 样本质量 | 覆盖多峰 | 似然 | 训练稳定性 | |
|---|---|---|---|---|---|---|
| 扩散(2.2.1) | 迭代去噪 | 慢(几十到上千步) | 很高 | 好 | DDPM 用 ELBO 估计;连续 score 模型可沿概率流 ODE 算密度,代价高 | 稳 |
| Flow Matching(2.2.2) | 沿速度场积分 | 中(几步到几十步) | 高 | 好 | 可以算(ODE) | 稳 |
| 自回归(2.1.2) | 逐 token 生成 | 慢(要逐 token 串行生成,轮数随长度增加) | 高 | 好 | 精确 | 稳 |
| VAE(2.2.3) | 采样隐变量后解码一次 | 快 | 偏模糊 | 较好 | 下界 | 稳 |
| GAN(2.2.4) | 噪声过生成器一次 | 快 | 锐利 | 容易模式塌缩 | 无 | 不稳 |
| VQ-VAE + 先验(2.2.5) | 先生成离散 token 再解码 | 取决于先验模型 | 高 | 好 | token 的概率由先验给出;数据本身的似然还牵涉解码器,通常只能给下界 | 稳 |
| 标准化流(2.2.6) | 噪声过可逆网络 | 耦合流一次前向,快;MAF 类自回归流采样要逐维,慢 | 中 | 好 | 精确 | 稳 |
| 能量模型(2.12) | MCMC 采样 | 很慢 | 中 | 理论上能表示,实际受 MCMC 混合影响 | 有定义,但 Z 一般难以精确计算,可用 AIS 等方法估计 | 难 |
这张表写的是典型特征,不是固定排名;「几步」也不能直接换算成墙钟时间,网络大小不同,一步的代价差很多。
4.4 表示学习目标对比
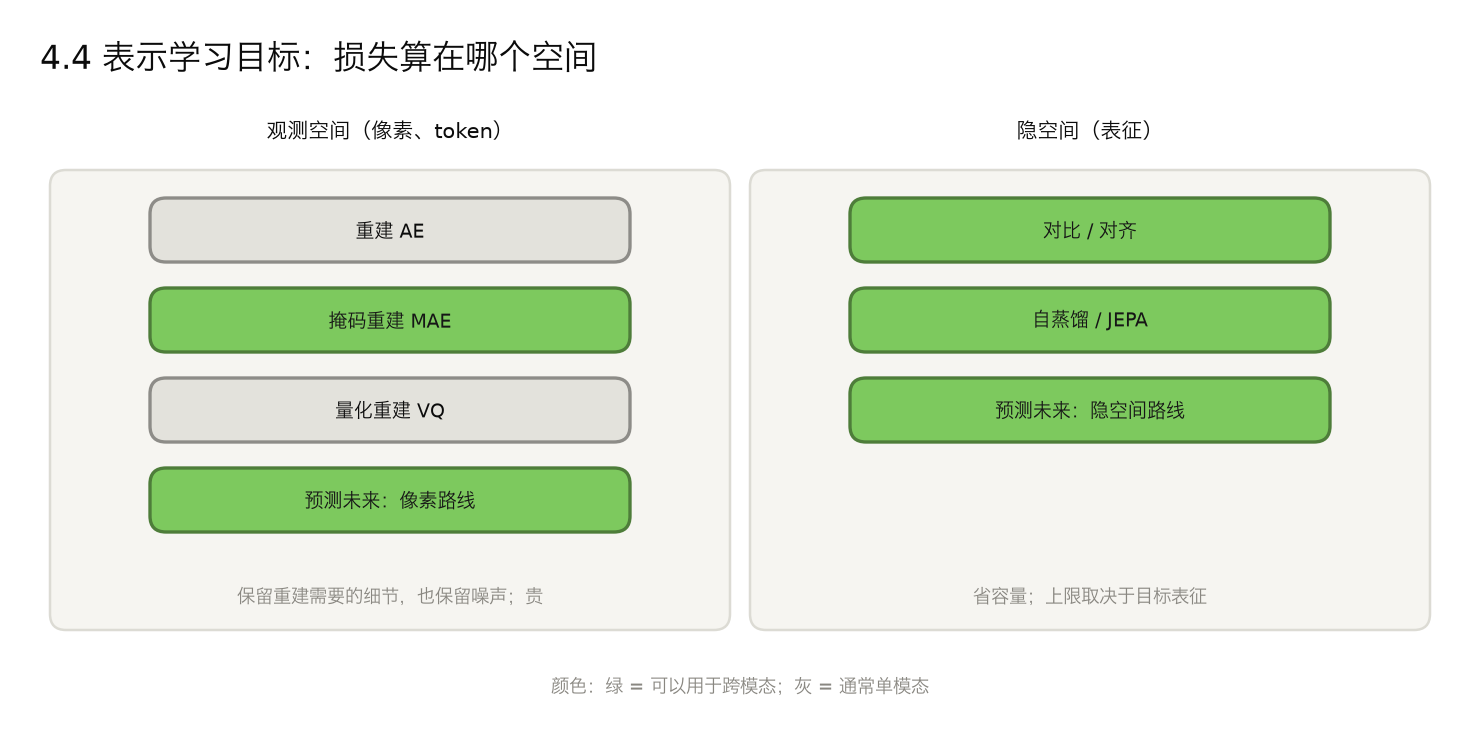
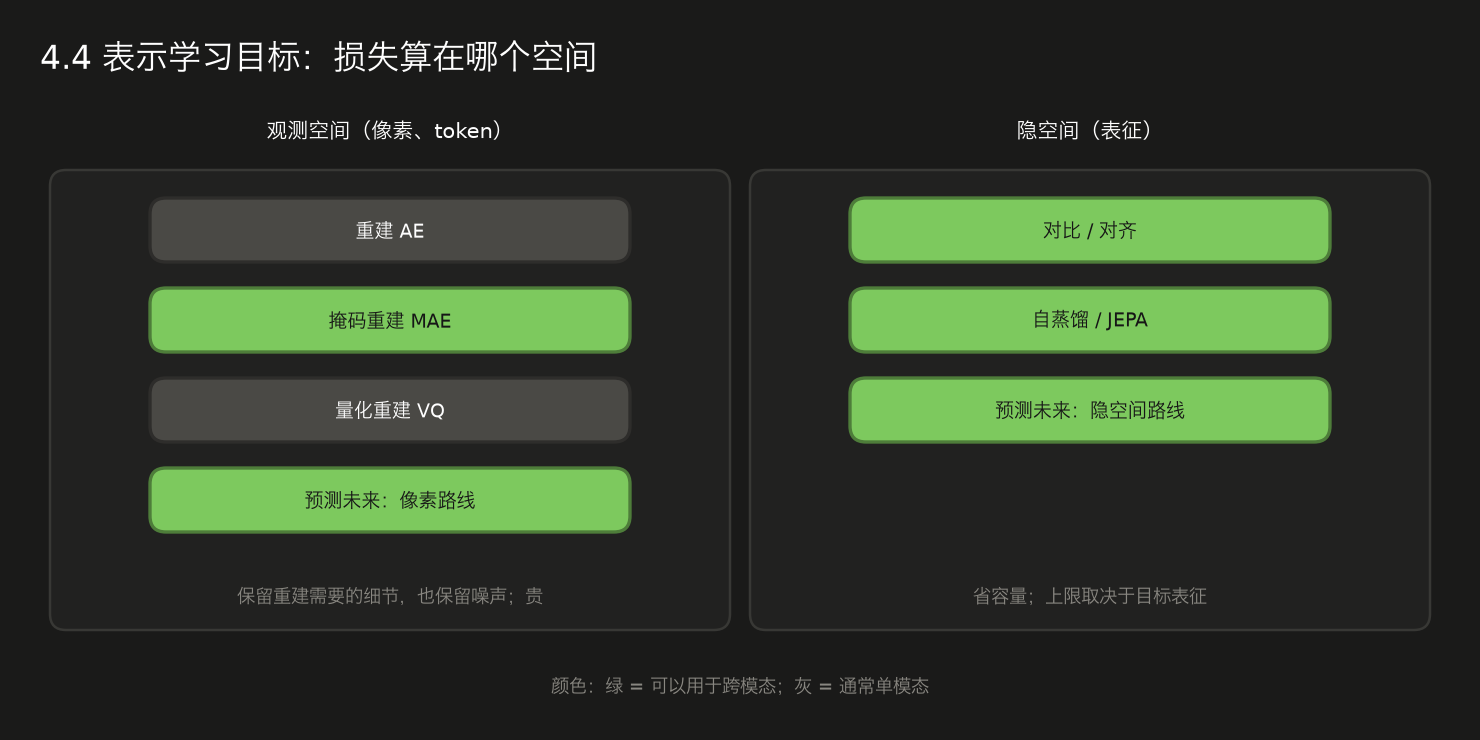
| 监督信号从哪来 | 损失在哪个空间 | 怎么用于跨模态 | 主要作用 | 主要代价 | |
|---|---|---|---|---|---|
| 重建(AE,2.6.4) | 输入自己 | 观测空间 | 几个模态一起重建,或用一个模态重建另一个 | 鼓励编码器保留重建需要的信息 | 保留无关噪声 |
| 掩码重建(MAE,2.6.2) | 输入自己(被遮住的部分) | 观测空间 | 遮一个模态,用另一个补 | 逼模型理解上下文、学跨模态互补 | 遮挡率要调 |
| 量化重建(VQ,2.2.5) | 输入自己 | 观测空间 | 把各模态都量化成 token,放进同一个序列模型 | 抗噪、得到离散 token | 码本塌缩 |
| 对比 / 对齐(2.6.1) | 样本对之间的配对关系 | 隐空间 | 单模态用同一样本的增强视图,跨模态直接对齐配对数据(图文对) | 学视图不变的表征;跨模态版本做对齐和零样本检索 | 要构造正对;负样本数量、batch 大小的要求看具体方法(SimCLR、CLIP 要大 batch) |
| 自蒸馏 / JEPA(2.6.3) | 老师网络的表征 | 隐空间 | 用一个模态的表征预测另一个模态的表征 | 可以不在不可预测的细节上花容量 | 塌缩风险,训练细节敏感 |
| 预测未来(3.2.4) | 未来的观测或表征 | 观测空间或隐空间 | 用多模态的历史预测未来 | 鼓励表征保留对预测未来有用的信息 | 需要时序数据;隐空间路线难诊断 |
第五部分 时间线
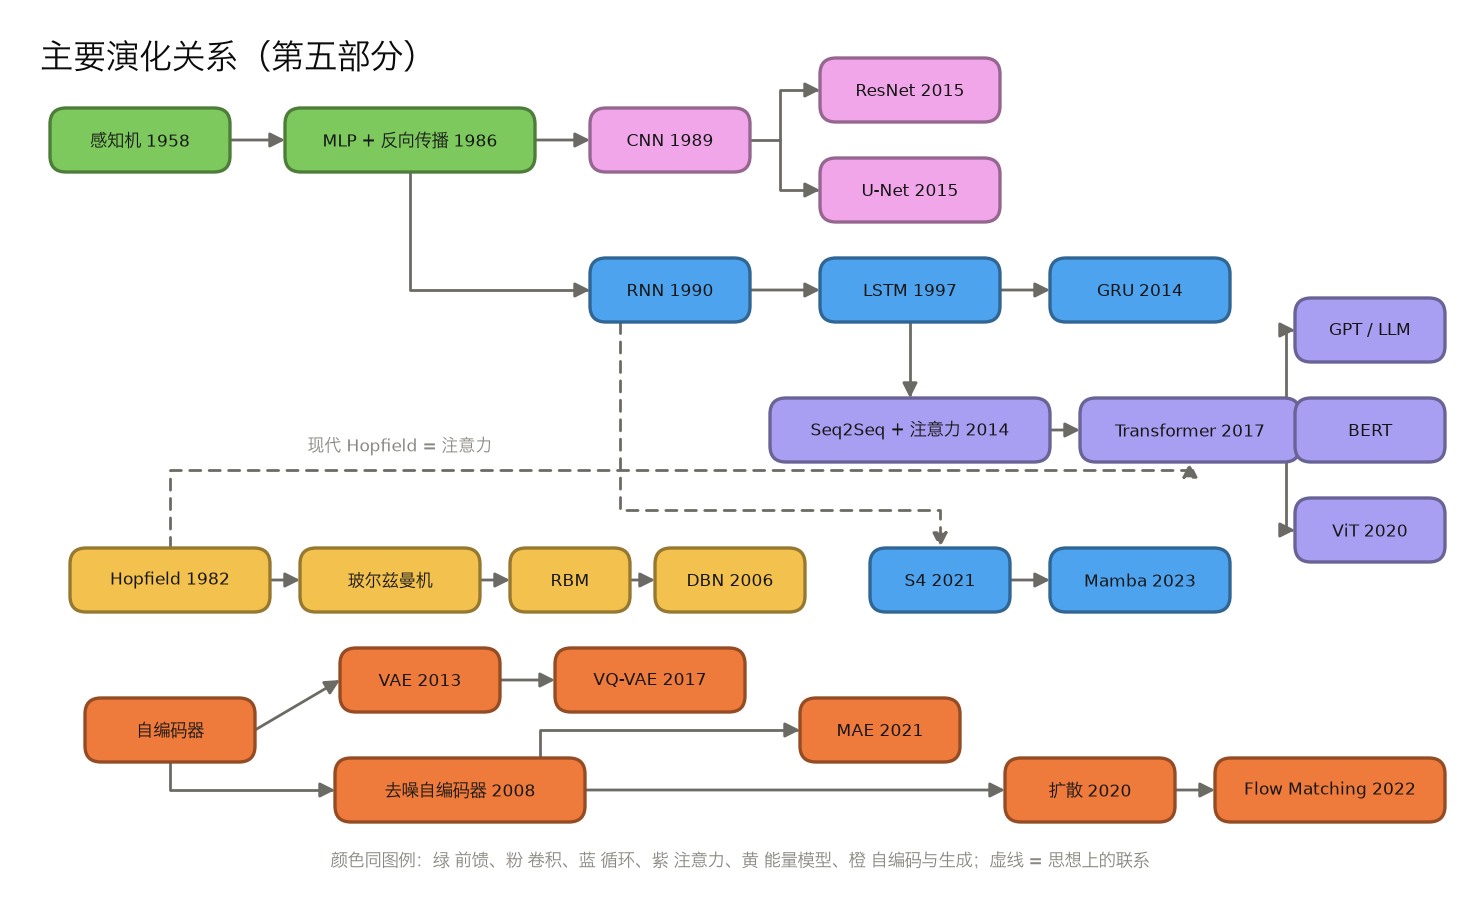
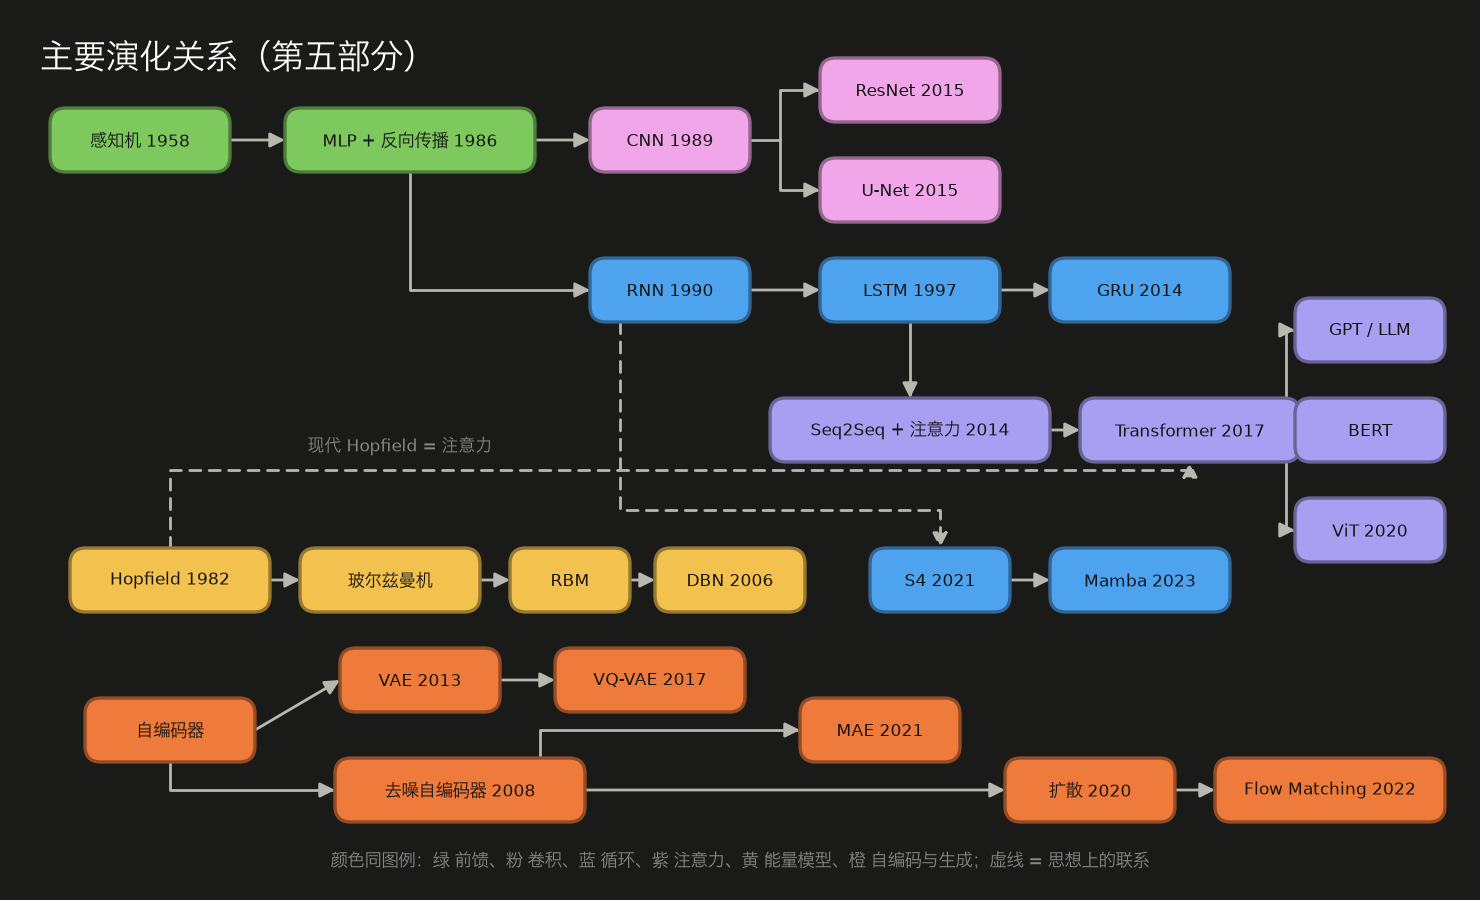
精选的里程碑,主要覆盖到 2024 年。年份取代表性论文公开或发表的年份,不一定是这个思想第一次出现的时间。
| 年份 | 事件 |
|---|---|
| 1943 | McCulloch-Pitts 神经元 |
| 1949 | Hebb 学习规则 |
| 1958 | Rosenblatt 感知机 |
| 1969 | Minsky 与 Papert《Perceptrons》指出单层感知机解不了 XOR,研究转入低谷 |
| 1982 | Hopfield 网络;Kohonen 自组织映射 |
| 1983–1985 | 玻尔兹曼机 |
| 1986 | 反向传播(Rumelhart、Hinton、Williams);Smolensky 提出 RBM 的前身 Harmonium;Jordan 网络 |
| 1988 | 径向基函数网络;双向联想记忆 |
| 1989 | LeCun 用卷积网络识别手写邮编;Cybenko 证明万能逼近定理;ALVINN 用神经网络开车 |
| 1990 | Elman 循环网络 |
| 1991 | 混合专家(Jacobs、Jordan、Nowlan、Hinton) |
| 1992 / 1995 | 核 SVM / 软间隔 SVM |
| 1994 | 混合密度网络(Bishop) |
| 1997 | LSTM |
| 1998 | LeNet-5 |
| 2001 / 2002 | 回声状态网络 / 液态机 |
| 2004 | 极限学习机 |
| 2006 | 深度信念网络的逐层预训练,深度学习复兴 |
| 2008 | 去噪自编码器 |
| 2012 | AlexNet 赢得 ImageNet,深度学习进入主流 |
| 2013 | VAE;word2vec |
| 2014 | GAN;GRU;Seq2Seq;Bahdanau 注意力;神经图灵机;VGG、GoogLeNet |
| 2015 | ResNet;U-Net;BatchNorm;DCIGN;扩散模型的最初形式(Sohl-Dickstein) |
| 2016 | WaveNet;本笔记开头那张图发布;RealNVP |
| 2017 | Transformer;胶囊网络;VQ-VAE;PointNet;DeepSets;GCN;稀疏门控 MoE 层 |
| 2018 | BERT;GPT;Neural ODE;GAT;World Models |
| 2020 | ViT;DDPM;NeRF;GPT-3;SimCLR、BYOL;现代 Hopfield 网络 |
| 2021 | CLIP;DINO;MAE;S4;Switch Transformer;LoRA |
| 2022 | Flow Matching、Rectified Flow;Stable Diffusion 开源;ChatGPT |
| 2023 | Mamba;Diffusion Policy;I-JEPA;LLaMA;DINOv2 |
| 2024 | KAN;Hopfield 与 Hinton 获诺贝尔物理学奖;π0;DeepSeek-V3 |