深度学习与神经网络10
2.9 图与集合
2.9.1 GNN 图神经网络:GCN、GAT、消息传递、图池化
一句话
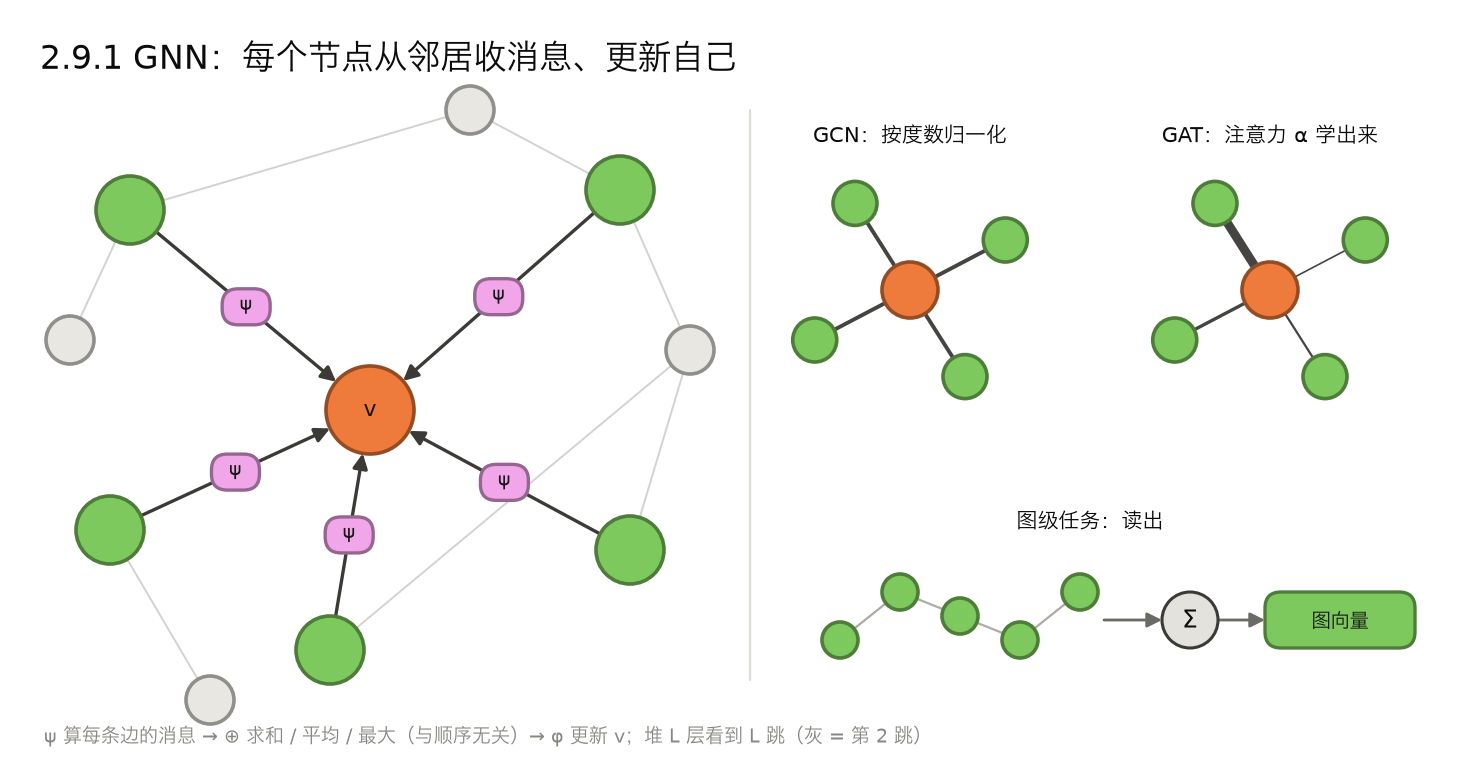
每个节点反复从邻居那里收集信息、更新自己的表示;同一套更新函数用在所有节点上,所以能处理任意大小、任意连接方式的图。
消息传递框架(Gilmer 2017,几乎所有 GNN 都能写成这个形式):
ψ 为每条边算一条「消息」,⊕ 是对邻居消息的聚合(求和、平均或最大值,与邻居顺序无关),φ 用聚合结果更新节点。堆 L 层,每个节点就能看到 L 跳以内的信息。
GCN(Kipf & Welling 2017):消息就是邻居特征的线性变换,按度数归一化后求和:
GAT(Veličković 2018):邻居的权重不再由度数固定,用注意力算出来:
图池化(读出):做整图级别的任务(分子性质预测、图分类)时,要把所有节点的表示汇成一个图向量。最简单的是全局求和 / 平均 / 最大池化;层级池化(DiffPool、TopK 池化)在中间层逐步把节点合并或删减,得到由细到粗的多层图表示。
几个常见问题
- 过平滑:层数多了,所有节点的表示趋于一致,所以 GCN、GAT 这类标准消息传递网络通常只用 2–4 层(经验范围,加残差、归一化等技巧可以更深)
- 表达能力上限:标准消息传递 GNN 区分不同图结构的能力不超过 1-WL 图同构测试(高阶 GNN、加子图特征等变体可以超过),有些结构不同的图在它看来一模一样
- 长距离依赖:两个节点相隔很多跳时,信息要传很多层才能到;图 Transformer 用全局注意力补这一点
- 几何等变:分子、物理系统里节点有三维坐标,等变 GNN(EGNN 等)保证整体旋转平移时输出跟着正确变换
1 | import torch |
常见说法与实测
常见说法:GAT 用注意力给不同邻居不同的权重,比按度数固定加权的 GCN 更灵活,效果更好。
实测:这个三社区的合成图上,GCN 0.86、GAT 0.77(只看节点自己的 MLP 0.39)。另外换 5 个随机种子:GCN 平均 0.853,GAT 平均 0.776,GAT 只在 1 个种子上略好。
怎么理解:一种可能的解释:这张图里同一社区的邻居都一样有用,按度数归一化后求和已经是合适的聚合方式,注意力能多做的事不多,反而多了参数;有标签的节点只有约 30 个,可能更容易过拟合。训练预算、学习率等也会有影响,这里没有做消融逐一排除。GAT 的优势更可能在邻居的重要性确实不同的图上体现。在标准基准上公平调参之后,GCN 这类简单模型也经常和更复杂的 GNN 持平(Shchur 等 2018,《Pitfalls of Graph Neural Network Evaluation》)。
典型例子
- 分子性质与药物发现:原子是节点、化学键是边;2020 年用 MPNN 筛选出了新抗生素 halicin
- 推荐系统:Pinterest 的 PinSage 在数十亿节点的图上做推荐
- 交通:Google 地图的到达时间预测用了 GNN
- 物理仿真与天气:DeepMind 的 GNS 学习粒子动力学,MeshGraphNets 学网格仿真,GraphCast 做全球天气预报
- 机器人:多体系统、运动学链、场景中物体之间的关系;不规则排布的触觉单元(taxel)阵列可以建成图,相邻传感点连边
- 优势:直接处理不规则连接结构;对节点编号顺序置换等变;参数量与图的大小无关,能泛化到不同大小的图;能把「谁和谁相连」这种关系先验写进结构
- 局限:过平滑,层数受限;远距离依赖要很多跳;表达能力受 1-WL 上限约束;大图需要邻居采样和专门的批处理
- 适合的数据:图结构数据:分子、社交与引用网络、交通路网、仿真网格、知识图谱、机器人运动学链、不规则排布的传感器阵列
2.9.2 PointNet 与 DeepSets
一句话
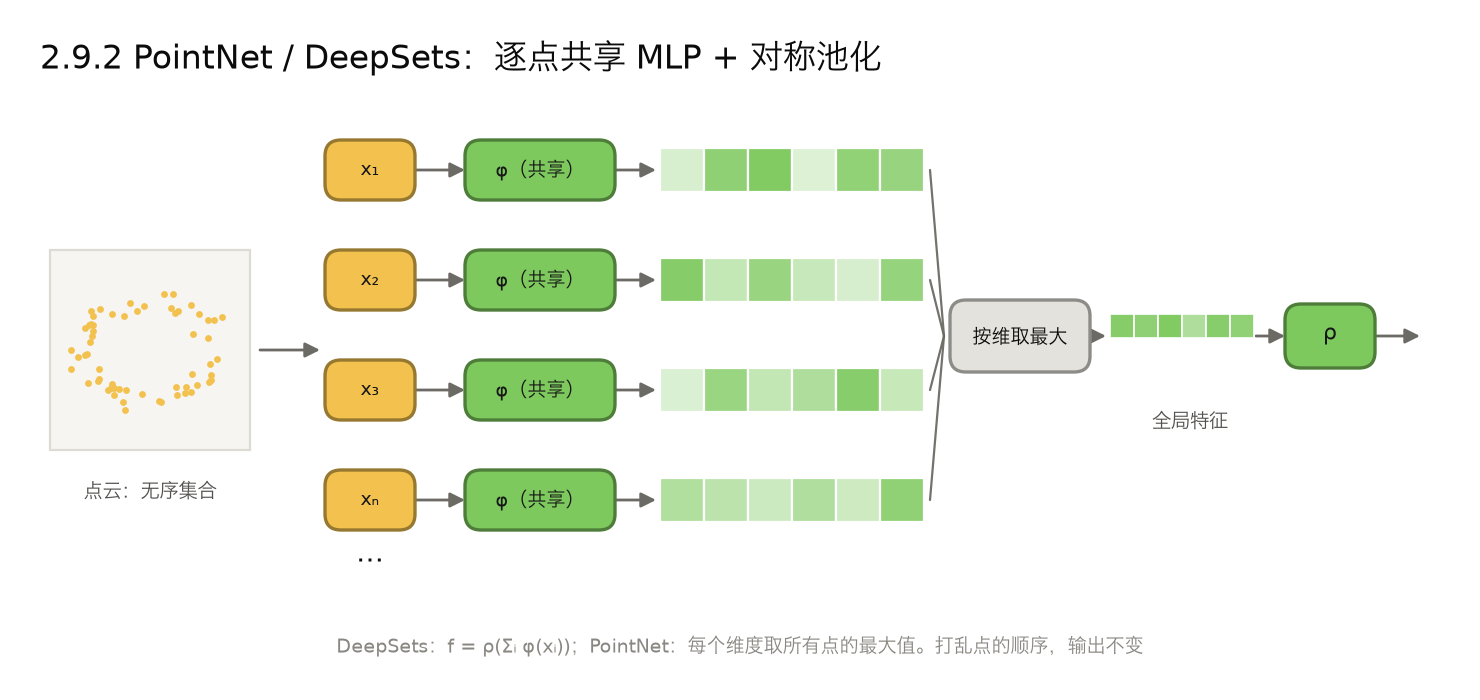
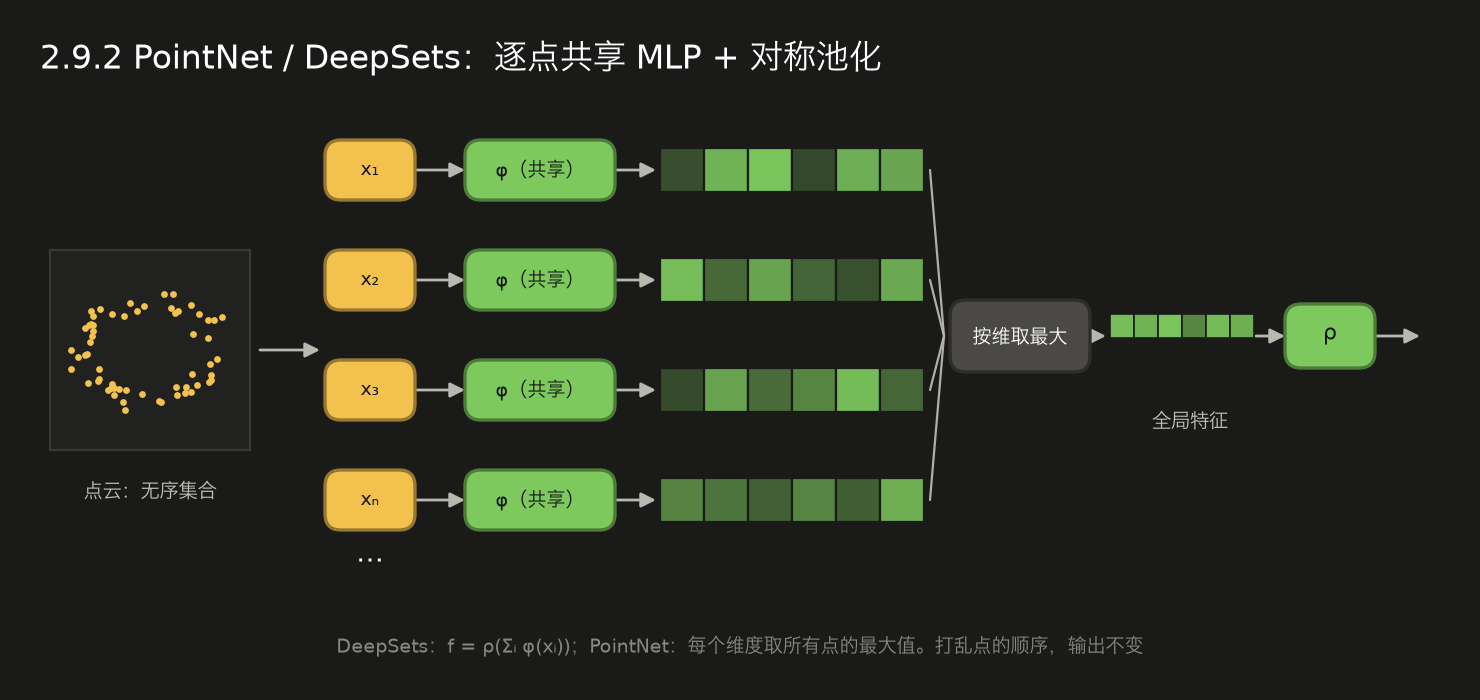
每个元素(点)独立地过同一个 MLP,再用一个与顺序无关的池化(求和或取最大值)汇总;输入是一个无序集合时,输出不受元素顺序影响。
DeepSets 定理(Zaheer 2017):在一定条件下,「对集合的置换不变函数」都可以写成
条件是这样的:元素取自可数集时成立;元素是连续的标量、集合大小最多为 M 时,Wagstaff 2019 证明求和之后的隐空间要有 M 维,才能表示所有连续的置换不变函数。点云这类向量元素也常用这个结构,但这个维度阈值不能直接照搬;而且这说的是表示能力,维度够了也不保证训练能学会。
PointNet(Qi 2017) 用的是取最大值:
每个特征维度取所有点里的最大值,相当于每个维度「挑一个最有代表性的点」。原版还有一个小网络 T-Net 先预测一个变换矩阵把点云对齐。
PointNet 的缺点和后续:每个点独立处理,没有利用邻域的局部几何。PointNet++ 先采样中心点、在每个中心点的邻域里用小 PointNet 提特征,逐层抽象;DGCNN 在特征空间建 k 近邻图做边卷积;Point Transformer 在邻域内做注意力。
1 | import torch |
典型例子
- 三维物体分类与分割:ModelNet40、ShapeNet
- 自动驾驶:激光雷达点云的检测和分割
- 机器人抓取:从深度相机点云预测抓取位姿(Contact-GraspNet 基于 PointNet++);3D Diffusion Policy(DP3)用一个轻量的点云编码器给扩散策略提供条件
- 无序集合:一组检测框、一群粒子(高能物理的喷注)、多智能体的状态集合、稀疏的接触点
- 优势:输入顺序无关、点数可变,直接吃原始点云,不需要体素化;逐点共享参数,快;最大池化只依赖每个维度上取到最大值的那几个点,缺的不是这几个点时输出不变
- 局限:原版不利用局部邻域结构;对整体旋转没有不变性(靠数据增强或等变网络)
- 适合的数据:集合与点云:激光雷达、深度相机点云、粒子集合、无序的检测结果、多智能体状态、接触点集合
2.10 不确定性与多峰输出
2.10.1 深度集成与 MC Dropout(估计预测的不确定度)
一句话
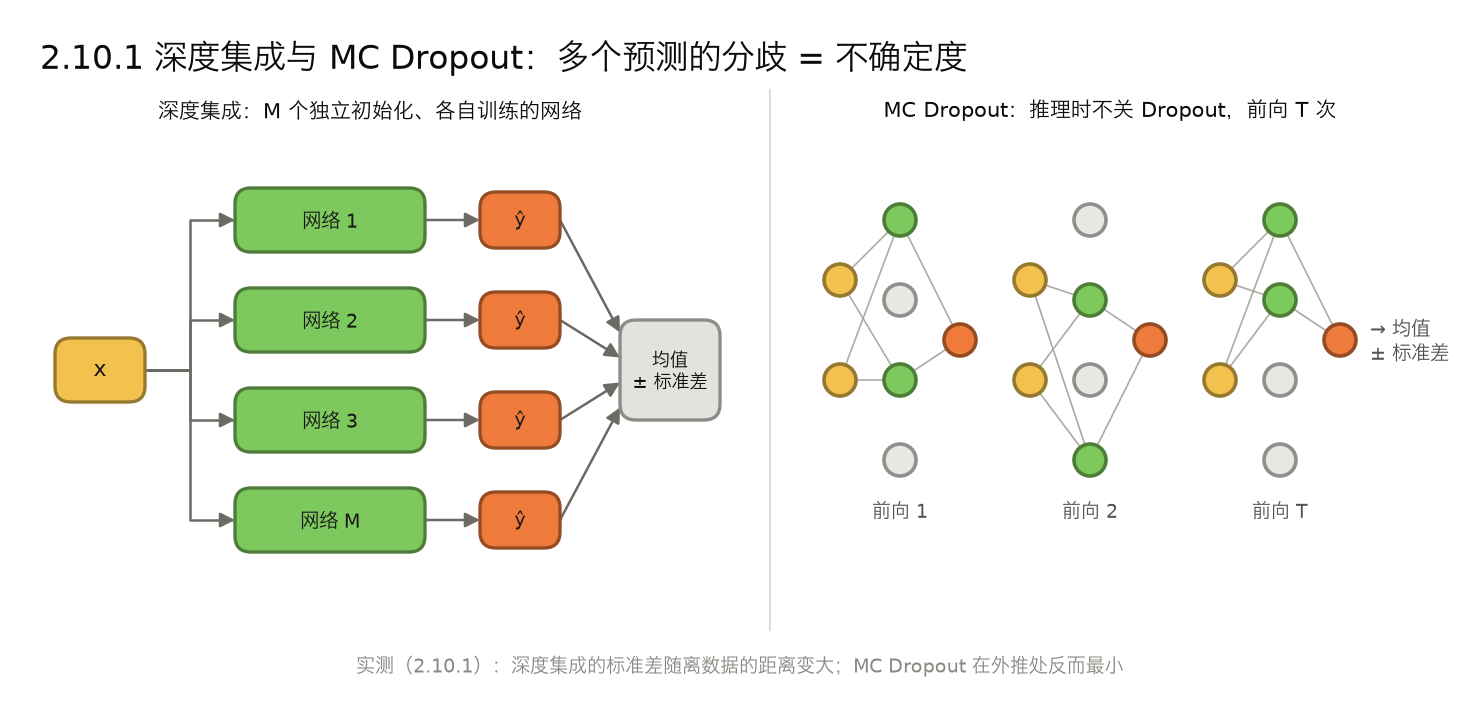
不只给一个预测,还给「有多确定」:多个模型(或同一个模型开着 Dropout 多次前向)的预测分歧越大,通常说明这里越缺数据;分歧也受模型结构、训练和近似方式影响,远离数据时不保证变大。
两类不确定性
| 类型 | 来源 | 能不能靠更多数据消除 | 怎么估 |
|---|---|---|---|
| 认知不确定性(epistemic) | 模型没见过这一片输入 | 能 | 贝叶斯神经网络、集成、MC Dropout |
| 偶然不确定性(aleatoric) | 数据本身的噪声或多解 | 不能 | 让网络输出方差或一个分布(2.10.2) |
贝叶斯神经网络:每个权重用一个分布 p(θ | 数据) 表示,预测是对所有可能权重的平均:
θ_m 是从后验里采的样本。真实的后验算不出来,下面三种方法都能给出不确定度,但和贝叶斯的关系各不相同:
| 方法 | 做法 | 成本 |
|---|---|---|
| 深度集成(Lakshminarayanan 2017) | 不同随机初始化训练 M 个模型(常用 5 个),用预测的分歧当不确定度。原论文明确把它作为非贝叶斯方法提出:M 个模型不是从后验里采的样本,和上面的平均只是形式相似 | 训练和存储 M 份;效果通常最好 |
| MC Dropout(Gal & Ghahramani 2016) | 推理时不关 Dropout,前向 T 次;可以解释成对后验的一种变分近似 | 几乎零额外训练成本 |
| 变分推断(Bayes by Backprop,Blundell 2015) | 每个权重学一个高斯分布,显式近似后验 | 参数翻倍,训练复杂 |
1 | import torch |
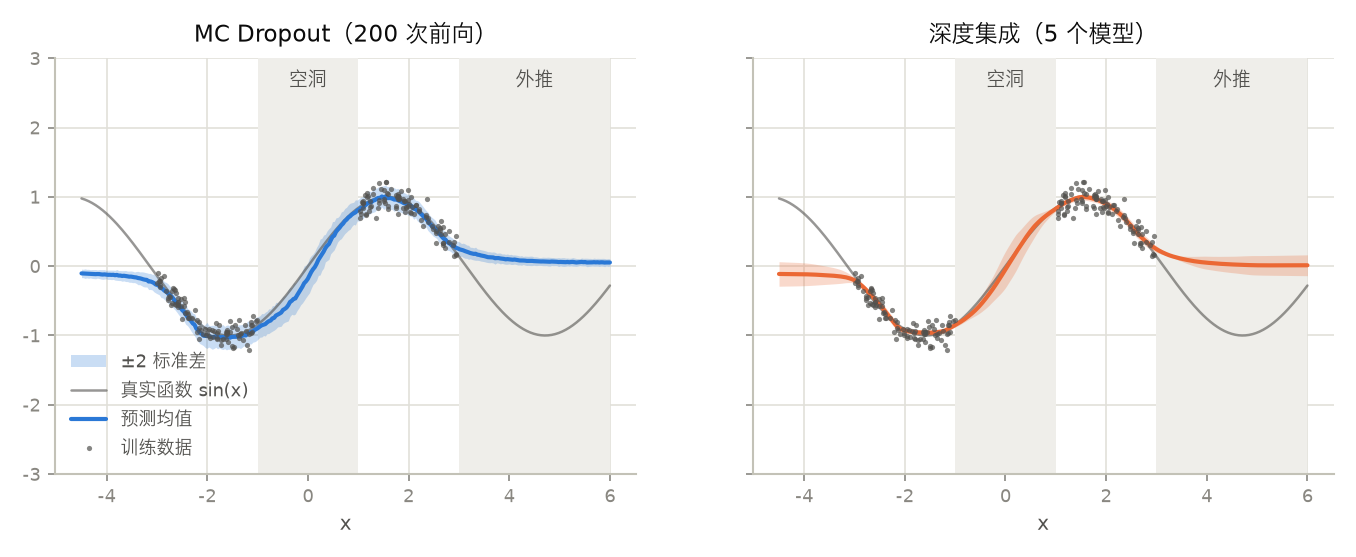
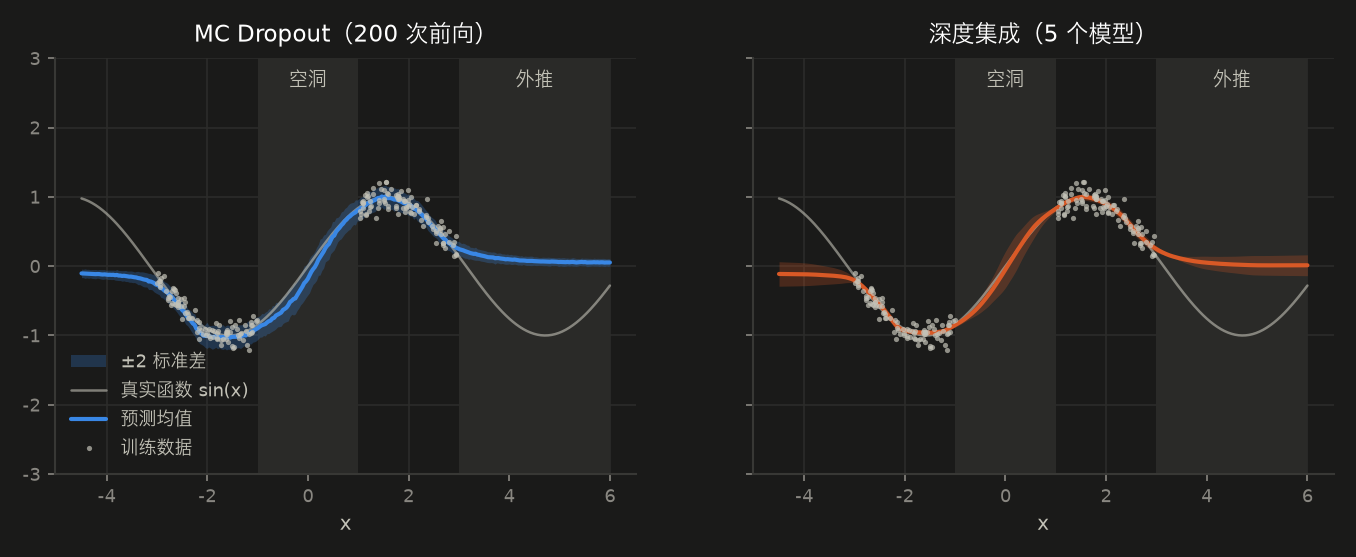
灰色区域里没有训练数据:左边是两段数据之间的空洞,右边是外推。深度集成的区间在空洞处略微变宽、在外推处明显变宽;MC Dropout 的区间处处都很窄,到了外推处也没有变宽,说明在这个例子里它远离数据时给出的不确定度不可靠。两者的均值在外推处都偏离了真实函数。图里的色带是预测之间的分歧(±2 个标准差),不是校准过的置信区间,也没把数据本身的噪声算进去。
常见说法与实测
常见说法:MC Dropout 近似贝叶斯神经网络,推理时多次前向,离训练数据越远,预测之间的分歧越大。
实测:训练数据只在 [−3, −1] 和 [1, 3]。MC Dropout 的标准差在两段数据之间的空洞(x = 0)处是 0.115,比有数据的地方(0.065–0.082)大;在外推处(x = 5)只有 0.031,比有数据的地方还小。深度集成的标准差在空洞处是 0.033(有数据处 0.017–0.027),外推处 0.073,随着远离数据而变大。
怎么理解:Dropout 的随机性只来自随机关掉的神经元,它并不知道哪里缺数据。这个例子里 MC Dropout 在外推处的预测几乎是一条平线(见上图),那里的输出主要由偏置和少数单元决定,随机关掉单元带来的变化很小。文献里对 MC Dropout 的不确定度质量也有不少批评(如 Osband 2016)。深度集成的几个模型来自不同的随机初始化,在没有数据约束的区域往往走向不同的函数,分歧变大,这是它在实践中通常更可靠的原因。这也不是保证:几个模型在某些远离数据的区域可能恰好外推得差不多,分歧就不会变大。
典型例子
- 模型预测控制与基于模型的强化学习:PETS 用概率集成学动力学模型,规划时考虑模型的不确定度,避免利用模型的错误
- 主动学习:优先标注模型最不确定的样本
- 安全攸关场景:医疗诊断、自动驾驶,在不确定时交给人或采取保守动作
- 分布外检测:输入和训练数据差别很大时报警
- 贝叶斯优化:用不确定度权衡探索与利用
- 优势:知道自己不知道什么;深度集成实现简单、效果稳定;MC Dropout 几乎免费
- 局限:真实后验难算,各种近似的校准质量不一;集成要训练和存储多份模型;推理要多次前向;在远离数据的地方,不确定度估计本身也可能不可靠
- 适合的数据:数据稀疏、可能遇到分布外输入、错误代价高的任务:医疗、自动驾驶、机器人安全控制、需要探索的强化学习
2.10.2 MDN 混合密度网络
一句话
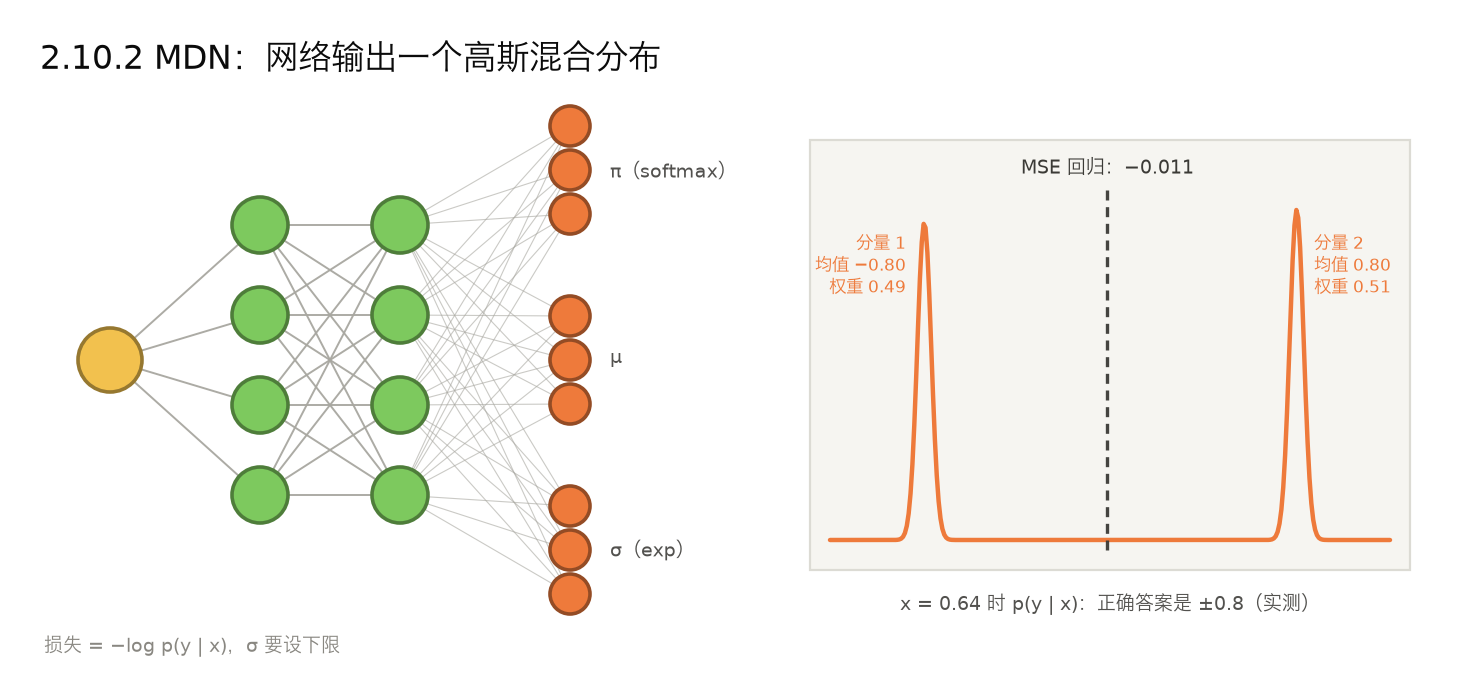
网络输出一个高斯混合分布的参数(每个分量的权重、均值、方差),用负对数似然训练;同一个输入可以对应几个都合理的输出。
π 用 softmax 保证和为 1,σ 用 exp 保证为正。Bishop 1994 年提出。
它解决的问题:1.4 节讲过,MSE 回归学到的是条件均值。逆问题(已知结果求原因)常常一对多:比如机械臂逆运动学,同一个末端位置可以由「肘部向上」和「肘部向下」两种关节角实现,取平均会得到一个够不到目标的姿态。MDN 用几个分量一起表示这个条件分布,学得好时不同的解落在不同的分量上。不过损失只看混合后的密度,多余的分量可能权重变小,也可能和别的分量重合、一起表示同一个峰,训练不保证每个分量正好对应一个解。
代价:分量数 K 要事先定;训练时 σ 可能塌到 0、似然趋于无穷,要对 σ 设下限;输出维度高时(比如一整段 16 步 × 7 维的动作)混合高斯不够灵活,这是扩散策略取代它的原因之一。
1 | import torch |
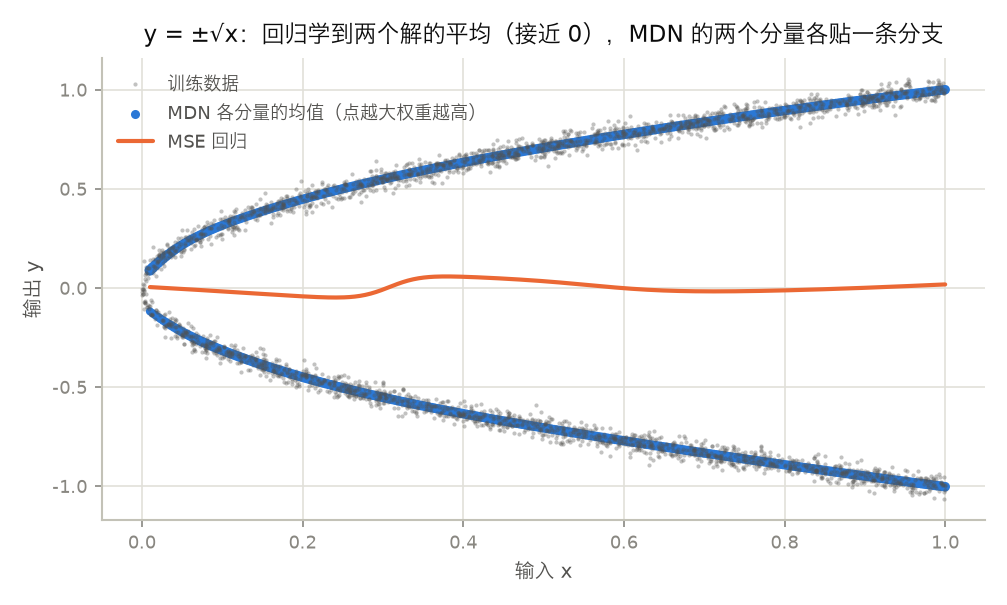
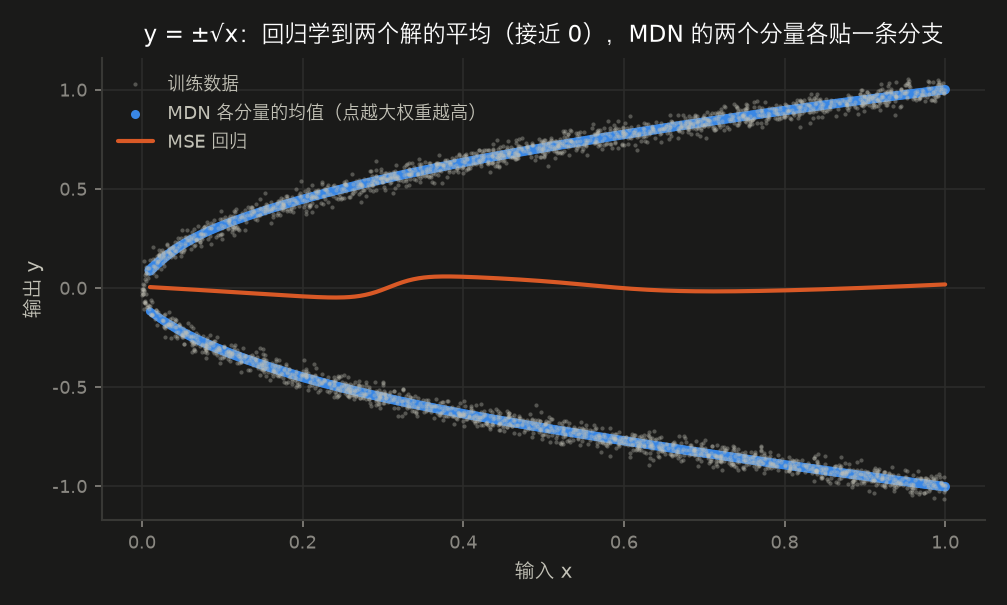
每个 x 对应两个都正确的 y(+√x 和 −√x)。MSE 回归学到的是两条分支的平均,几乎贴着 y = 0 走,哪一条分支都不在上面;MDN 的两个分量分别贴着两条分支。
常见说法与实测
常见说法:一对多的问题用 MSE 回归,会得到几个解的平均,落在解与解之间的空白处。
实测:y = ±√x 这种对称的两分支问题上确实如此:x = 0.64 时回归给出 −0.011,两个解是 ±0.8。但在 Bishop 的经典反问题上,x = 0.45 的三个解(无噪声方程的近似根)是 0.179、0.559、0.750,回归给出 0.537,紧挨着中间那个解。
怎么理解:回归输出的是按概率加权的平均。几个解对称、概率相近时,平均落在空白处;解的位置偏向一边、或者某个解的概率更大时,平均可能恰好落在某个解附近,看上去像答对了,它仍然只是一个平均值,输入稍有变化就可能落进空白。所以不能靠「回归结果看起来合理」来判断数据是不是多峰。
典型例子
- 手写生成:Graves 2013 用 LSTM + MDN 输出下一笔的位移分布,生成逼真的笔迹
- World Models(Ha & Schmidhuber 2018):MDN-RNN 预测下一时刻隐变量的混合分布
- 机器人模仿学习:robomimic 里的 BC-RNN-GMM 用混合高斯动作头处理多峰演示
- 自动驾驶轨迹预测:MultiPath 等输出几条可能轨迹及各自的概率
- 逆运动学、语音合成的声学参数生成
- 优势:一个输入可以对应多个合理输出,不会把多峰平均成无效值;给出完整的条件分布,包括不确定度;只改输出头和损失,主干不变
- 局限:分量数要预设;训练数值不稳定(σ 塌缩、分量坍缩);高维输出时表达力有限
- 适合的数据:一对多的映射:逆运动学、轨迹预测、手写和语音参数生成、低维的多峰机器人动作
2.11 连续与隐式表示
2.11.1 NeRF 与隐式神经表示
一句话
用一个 MLP 表示一个连续的信号:输入坐标,输出该点的值(颜色、密度、距离)。一张图、一个三维场景就存成一小组网络权重。
隐式神经表示(INR):图像是「(x, y) → 颜色」,三维形状是「(x, y, z) → 到表面的有符号距离」,音频是「t → 振幅」。用 MLP 拟合这个函数,可以在任意坐标上查询,存储量不随采样网格变大;但能恢复多少细节仍受数据、坐标编码的频率和网络容量限制,不等于无限分辨率。
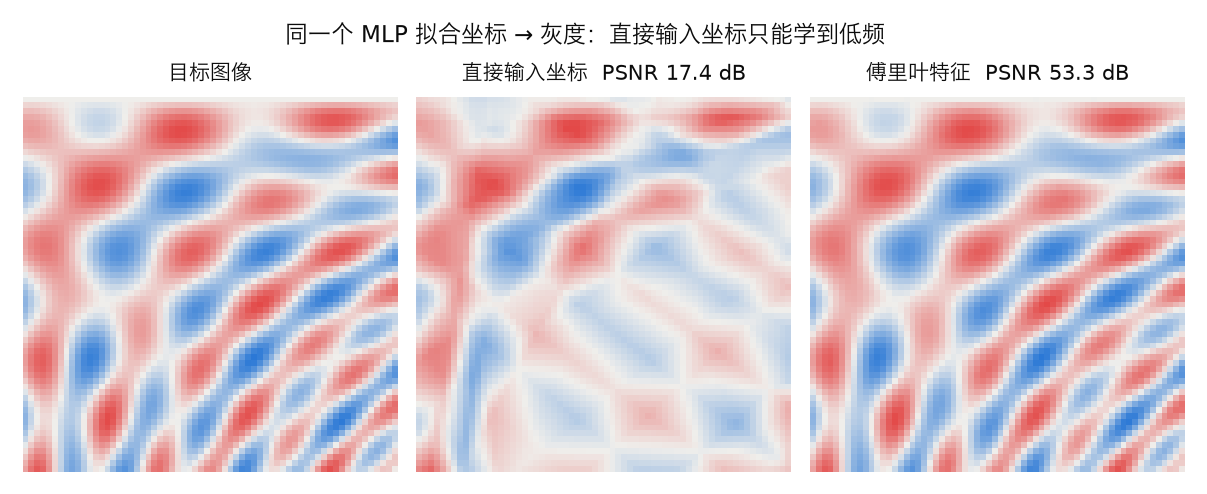
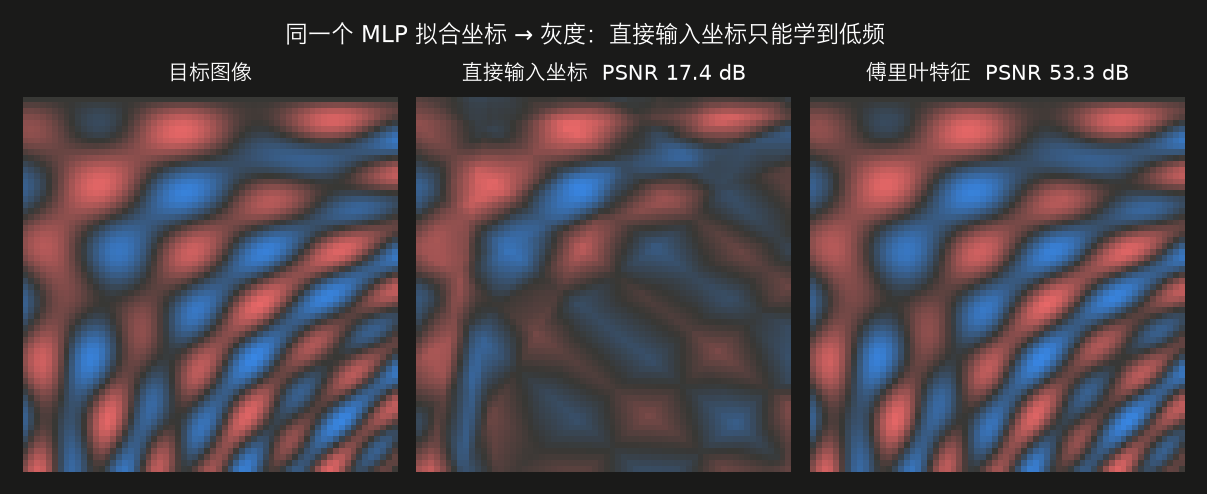
频谱偏差:普通 MLP 天然偏向学低频,直接输入坐标会拟合出一张糊图。两种解决办法:
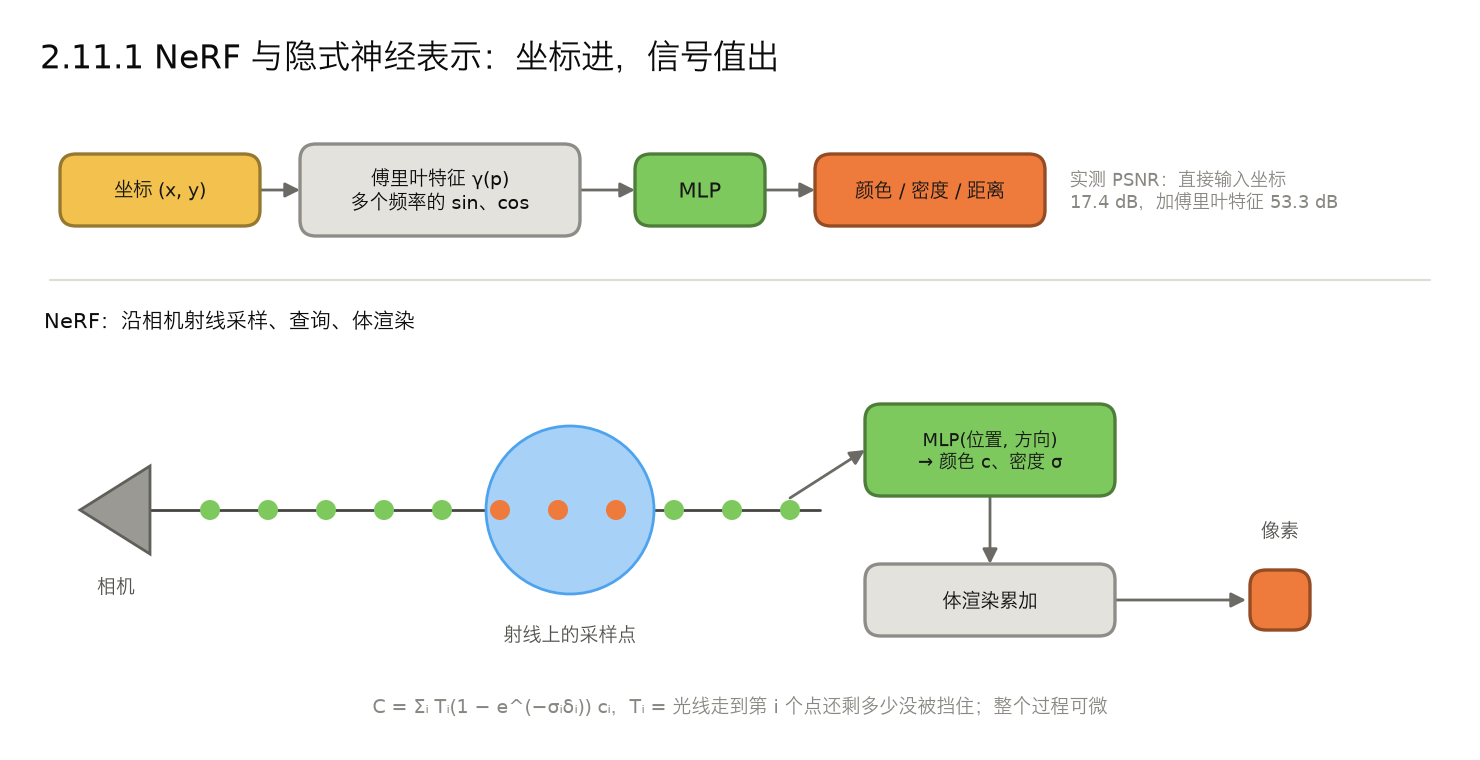
- 傅里叶特征 / 位置编码(NeRF、Tancik 2020):先把坐标映射成一组不同频率的正余弦,再送进 MLP
- SIREN(Sitzmann 2020):激活函数直接用 sin,配合特殊初始化
NeRF(Mildenhall 2020):MLP 输入三维位置和观察方向,输出颜色 c 和体密度 σ。渲染一个像素时,沿着相机射线采样 N 个点,按体渲染公式累加:
T_i 是光线走到第 i 个点时还剩多少没被挡住,δ_i 是相邻采样点的间距。整个渲染过程可微,所以只用多张已知位姿的照片、以「渲染出的像素和照片一致」为目标,就能把场景学进 MLP。之后的 Instant-NGP 用多分辨率哈希编码把训练从小时级压到秒级;3D Gaussian Splatting(2023)改用显式的高斯点云,渲染快得多。
1 | import torch |
典型例子
- 新视角合成:NeRF 从几十张照片重建场景,渲染任意视角
- 三维重建:神经有符号距离场(NeuS 等)重建高质量表面
- 机器人:用 NeRF 表示场景做抓取规划(包括透明物体);Neural Contact Fields 用触觉信号推断物体与环境的接触位置
- 信号压缩:一张图、一段视频存成一个小网络(COIN 等)
- 优势:连续表示,可以在任意坐标查询;存储量不随采样网格变大(细节受容量限制);完全可微,便于和渲染、物理过程结合求解逆问题
- 局限:每个场景要单独优化,原版 NeRF 训练要几个小时;渲染要对每条光线做很多次 MLP 前向,慢;推广到新场景需要额外的条件化设计
- 适合的数据:定义在连续坐标上的信号:图像、三维形状、辐射场、音频、物理场(温度、压力、接触场)
2.11.2 Neural ODE 神经常微分方程
一句话
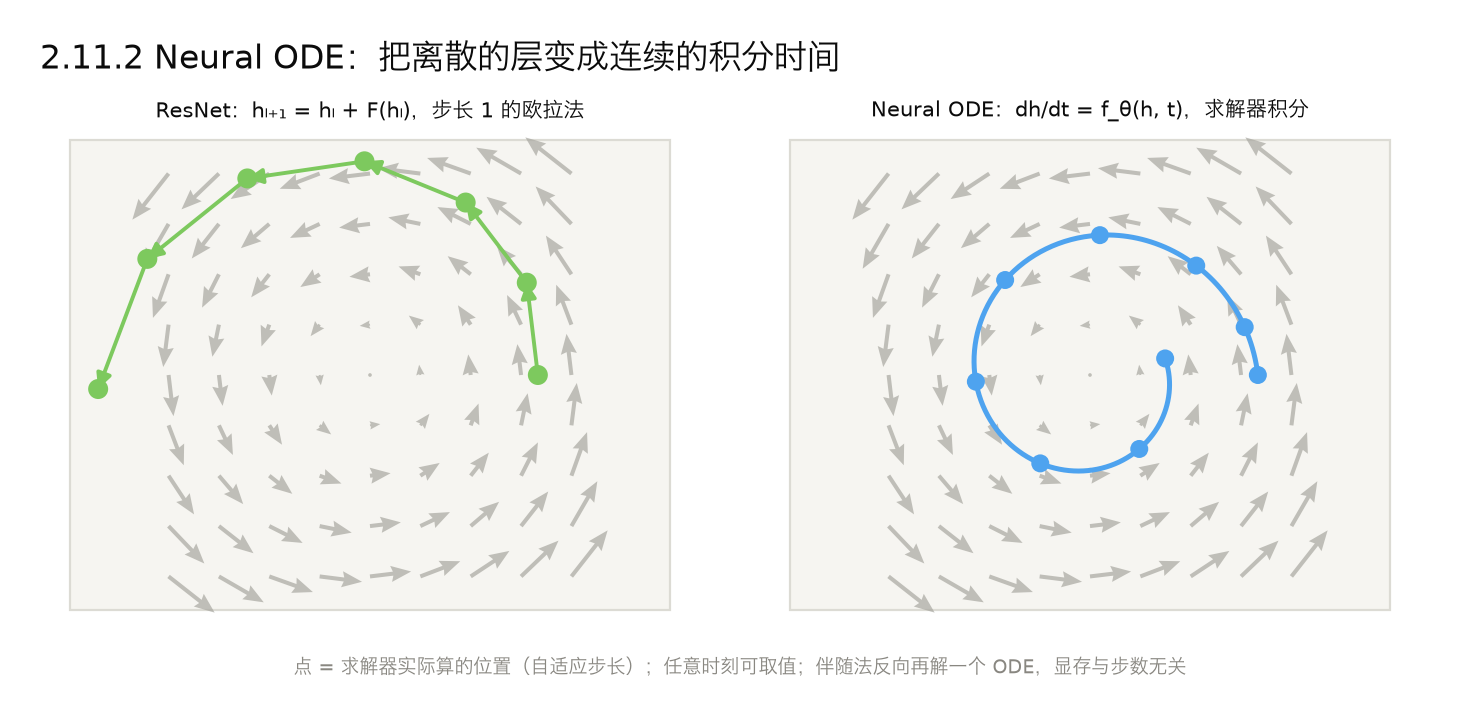
用神经网络定义隐状态随时间变化的速度 dh/dt = f(h, t),输出由数值积分得到,离散的层变成了连续的积分时间;ResNet 是它的欧拉法离散化。
和 ResNet 的关系:残差块 h_{l+1} = h_l + F(h_l) 就是步长为 1 的欧拉法。Neural ODE(Chen 2018,NeurIPS 最佳论文)把层数推到连续极限,用任意 ODE 求解器(如四阶龙格-库塔)积分。
几个特点
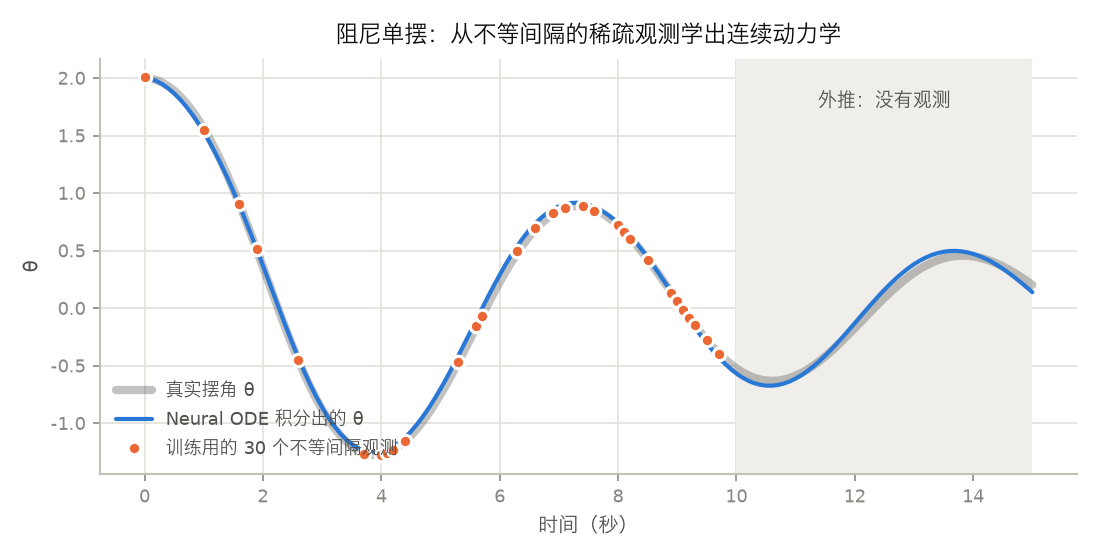
- 时间连续:可以在任意时刻取值,天然处理采样不均匀的时间序列
- 伴随法:反向传播时再解一个反向的 ODE 求梯度,理想情况下显存和积分步数无关(实际有数值误差,常要配合检查点)。下面的代码没用伴随法,是直接对每个积分子步反传,显存随步数增长
- 精度可调:求解器的容差就是「深度」,精度和速度可以在推理时权衡
- 局限:解是唯一的,同一时刻两条轨迹不能经过同一个状态,所以从 h(0) 到 h(T) 的映射连续可逆,有些映射表示不了(比如一维里把 −1 和 1 对调);f 显式依赖 t 时,轨迹可以在不同时刻经过同一个状态,但这条限制仍在。系统变「刚性」时步数暴涨
相关:Latent ODE 在隐空间里做 ODE,处理不规则采样的医疗数据;Liquid Time-constant Networks(LTC)和它的闭式近似 CfC 是由 ODE 定义的循环单元,在无人机和自动驾驶的小规模控制任务里表现出较好的鲁棒性;连续正规化流(FFJORD)把 2.2.6 的标准化流做成连续时间版本。
1 | import math |
常见说法与实测
常见说法:从一个初始状态积分很长一段再和观测比,梯度要穿过很长的积分链,很难优化;常用办法是把轨迹切成短片段训练(多次打靶法)。
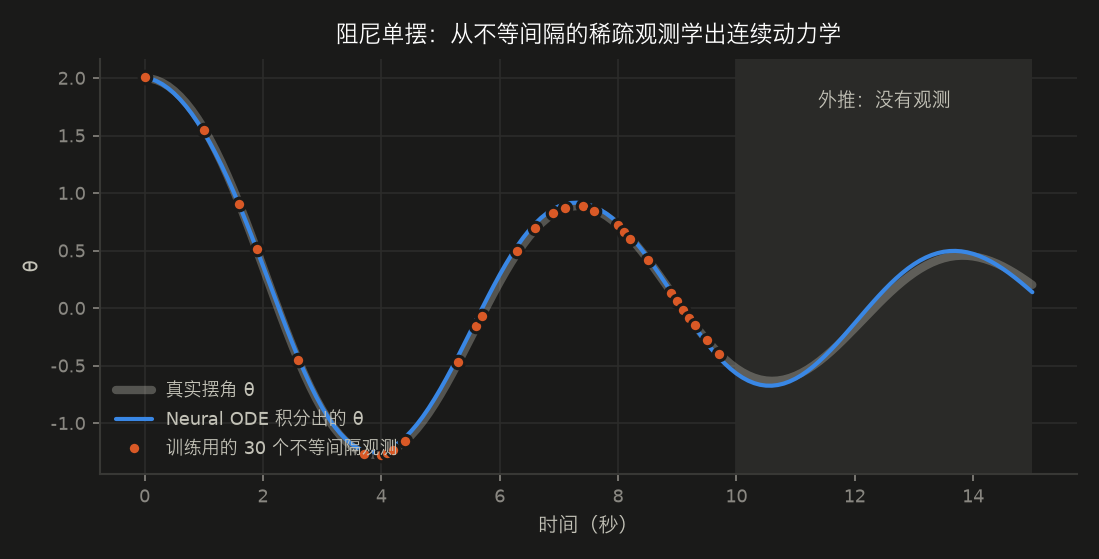
实测:这个 10 秒的阻尼单摆上,整条轨迹一次积分、训练 300 步时,拟合误差还卡在 0.53(另外换 5 个随机种子,有 4 个卡在 0.4–0.5);训练到 1000 步,误差降到 0.003(5 个种子全部降到 0.001–0.004)。随机短片段训练 3000 步,用时相近,误差 0.0035,5 个种子也都成功。
怎么理解:在这个规模上,长链积分的困难表现为一段很长的平台期,训练够久就能走出来,没有到学不会的程度。轨迹更长、动力学更混沌时,长链积分的梯度会爆炸或消失,分段训练才变得必要。作为默认做法,短片段训练更稳。
典型例子
- 不规则采样的时间序列:ICU 病人的检查记录(PhysioNet)用 Latent ODE 建模
- 物理系统辨识:从稀疏观测学连续动力学,再用于预测和控制
- 连续正规化流(FFJORD)
- 液态神经网络(LTC/CfC):小模型在无人机、自动驾驶任务上的控制实验
- 优势:连续时间建模,不规则采样不用插值;用伴随法训练时显存可以和步数无关;可以把物理先验写进向量场;精度和速度可调
- 局限:训练和推理都要数值积分,慢;刚性系统步数暴涨;同一时刻轨迹不能相交,映射必须连续可逆,表达能力受限(增广 ODE 缓解)
- 适合的数据:连续时间的动力学:物理系统状态、不规则采样的医疗和传感器时间序列、需要外推的轨迹