2.6 自监督与表示学习

2.6.0 表示学习在学什么(家族公共部分)

<center>2.6.0 表示学习
2.6.0 表示学习
<center>2.6.0 表示学习
2.6.0 表示学习

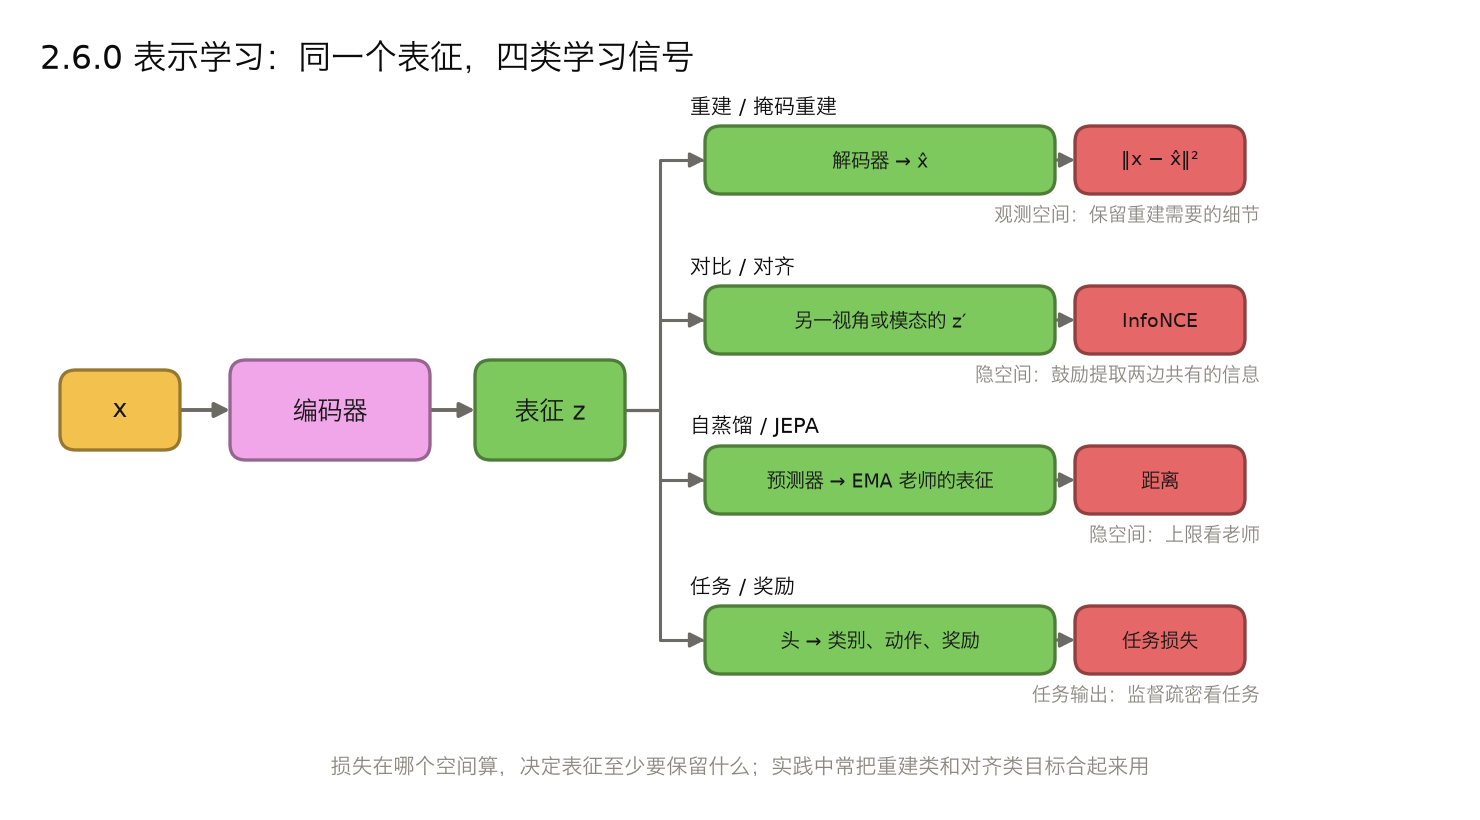
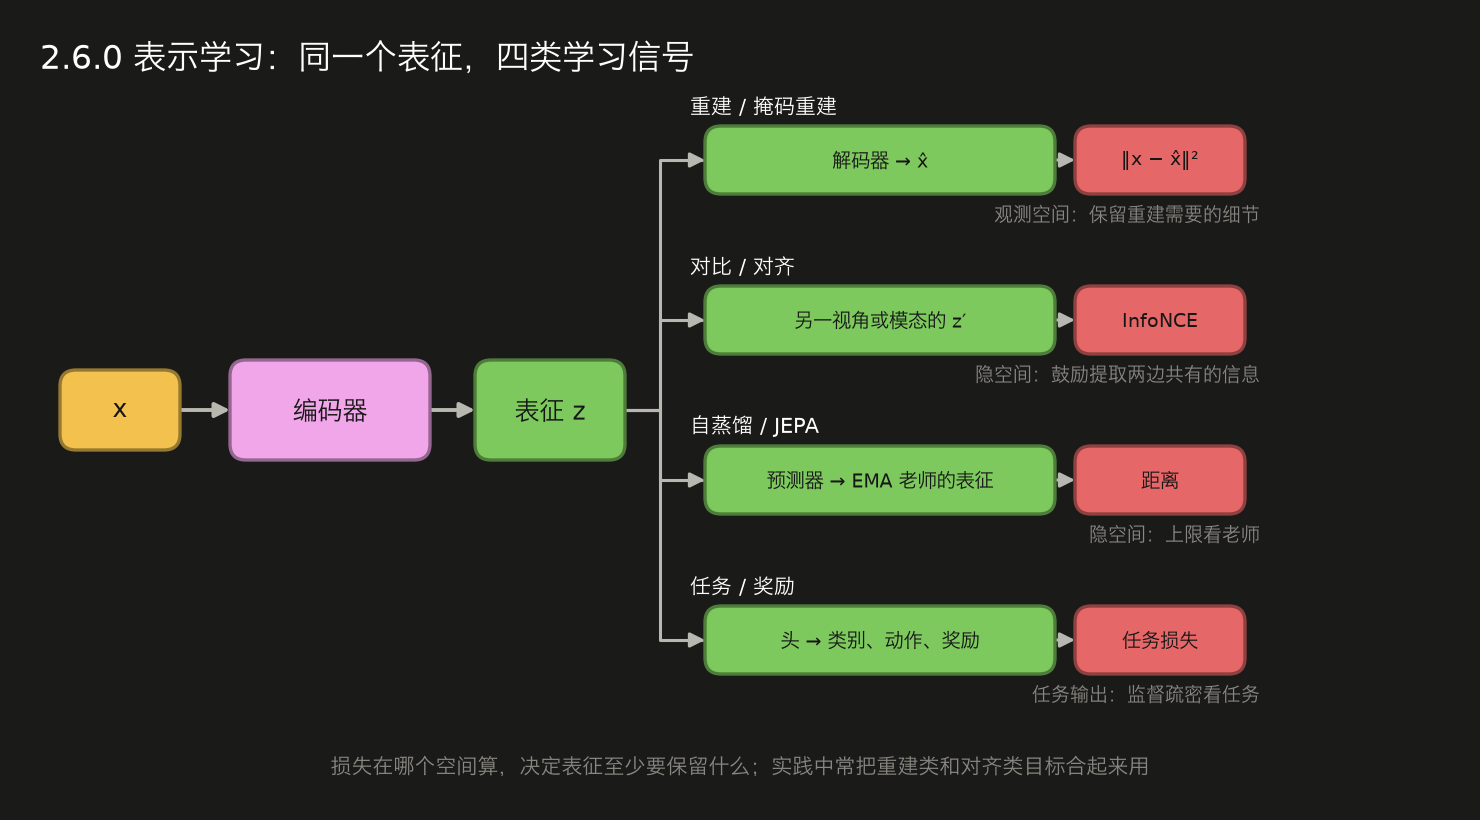
表征(representation):模型内部对输入的一种编码,常常是压缩的(也有过完备的,比如 2.6.5 的稀疏自编码器)。看完一张照片,脑子里不存每个像素,只留下「一只黑猫坐在沙发左边,光从右边来」,这就是表征:丢掉大部分细节,保留后面要用的信息。下面几个词相关但不等同,各有侧重:

词 侧重
representation 表征 最通用
feature 特征 从原始信号里提取出来的
embedding 嵌入 被放进一个连续向量空间
latent 隐变量 / 隐空间 没有直接观测到的变量,在模型内部
token 序列或集合里的一个处理单元:文本里是离散的 token ID,图像块、连续动作的 token 是连续向量

表征学习:学「输入 → 一个好用的中间编码」这件事本身。好用的标准有三条:下游任务只需少量标注就能学好;同一套表征能用于多种任务;输入有扰动(光照、传感器噪声)时表征不剧变。

自监督:不靠人工标注,让数据自己提供监督信号。主要路线(按热度排):

路线 监督信号从哪来 损失在哪个空间算 本笔记
对比 / 对齐 同一样本的两个视角、或成对的两种模态应该靠近 隐空间 2.6.1
掩码重建 遮住一部分,从剩下的部分补回来 观测空间(像素、token) 2.6.2
自蒸馏、隐空间预测 学生网络预测老师网络给出的表征 隐空间 2.6.3
重建 压缩后再还原整个输入 观测空间 2.6.4
量化重建 先量化到码本再还原 观测空间 2.2.5
预测未来 用现在推接下来的观测或表征 观测空间或隐空间 3.2 世界模型

两条互相拉扯的要求:多模态场景里,好的表征一方面要让不同模态里语义相同的东西靠近(对齐),另一方面要保留每个模态特有的细节(保真)。对比学习偏向前者,重建类目标偏向后者,所以实践中常把两类目标合起来用。

损失在哪个空间算,决定表征至少要保留什么

空间 表征至少要保留 代价
观测空间(重建) 重建需要的细节,常常包括与任务无关的噪声和背景 贵;能保留多少受瓶颈、容量和损失限制
隐空间(对齐、自蒸馏) 预测目标表征所需的信息 省,但上限取决于目标表征的质量
任务输出(标签、奖励) 预测任务输出所需的信息 监督有多密看任务:一张图一个类别标签很粗,逐像素的分割图、每一步的动作可以很密;奖励可能只在少数时刻出现

这些损失最后都会汇成一个标量去反传,表里比较的是拿什么当比较对象:整个输入、一个表征,还是任务的标签或奖励。中间一列是下限:损失只要求这些信息在表征里,没有要求删掉其余的。编码器多输出几维用不上的信息,只要后面的头不读它们,损失不变;所以这一列说的是训练鼓励保留什么,不保证别的信息被丢掉。

表示学习目标是一个损失,融合是一层网络:自监督目标挂在编码器输出上,训练时用;做下游识别任务时,很多方法会把预训练用的解码器、投影头扔掉,但要不要留看用途,比如 CLIP 做零样本分类、跨模态检索仍要用投影到共同空间的那一层;多模态融合模块(2.8)则是网络里实实在在的一层,推理时每次都要过。两者是两个独立的设计选择。

表征塌缩:如果编码器把所有输入都映射成同一个向量,很多自监督损失可以降到很低,表征却不含任何信息。不同方法用不同手段防止它:

方法 防塌缩的手段
对比学习 负样本:不同样本必须被推开
BYOL、DINO、JEPA 停止梯度 + EMA 老师网络;BYOL、JEPA 在学生一侧多一个预测头(不对称结构),DINO 没有预测头,靠对老师的输出做中心化和锐化
VICReg 直接约束每个维度的方差不能太小、不同维度之间不相关
重建类 一般不会塌缩成常数(常数向量没法还原不同的输入),但这不是数学保证,解码器能绕开编码时照样可能退化;而且会保留无关细节

怎么评估表征:冻结编码器,只在表征上训练一个线性分类器(线性探测,linear probe),或者用 k 近邻分类;也可以整体微调后看下游表现。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
import torch
import torch.nn as nn
import torch.nn.functional as F

def linear_probe(f_train, y_train, f_test, y_test, n_cls, steps=300):
"""冻结编码器,只训练一个线性分类器:评估表征好坏的标准做法"""
clf = nn.Linear(f_train.size(1), n_cls)
opt = torch.optim.Adam(clf.parameters(), lr=1e-2)
for _ in range(steps):
loss = F.cross_entropy(clf(f_train), y_train)
opt.zero_grad(); loss.backward(); opt.step()
return (clf(f_test).argmax(1) == y_test).float().mean().item()

def collapse_score(z):
"""归一化后每个维度在 batch 内的标准差的均值;接近 0 说明表征塌缩成了常数"""
return F.normalize(z, dim=1).std(0).mean().item()

torch.manual_seed(0)
z_good = torch.randn(256, 64) # 各样本表征不同
z_collapsed = torch.randn(1, 64) + 0.001 * torch.randn(256, 64) # 几乎都是同一个向量
print(f"正常表征 {collapse_score(z_good):.3f},塌缩表征 {collapse_score(z_collapsed):.4f}")

X = torch.randn(600, 20); y = (X[:, 0] + X[:, 1] > 0).long() # 线性可分的玩具数据
print("线性探测准确率:", linear_probe(X[:500], y[:500], X[500:], y[500:], 2))

2.6.1 对比学习:孪生网络、SimCLR、CLIP

<center>2.6.1 对比学习
2.6.1 对比学习
<center>2.6.1 对比学习
2.6.1 对比学习

一句话

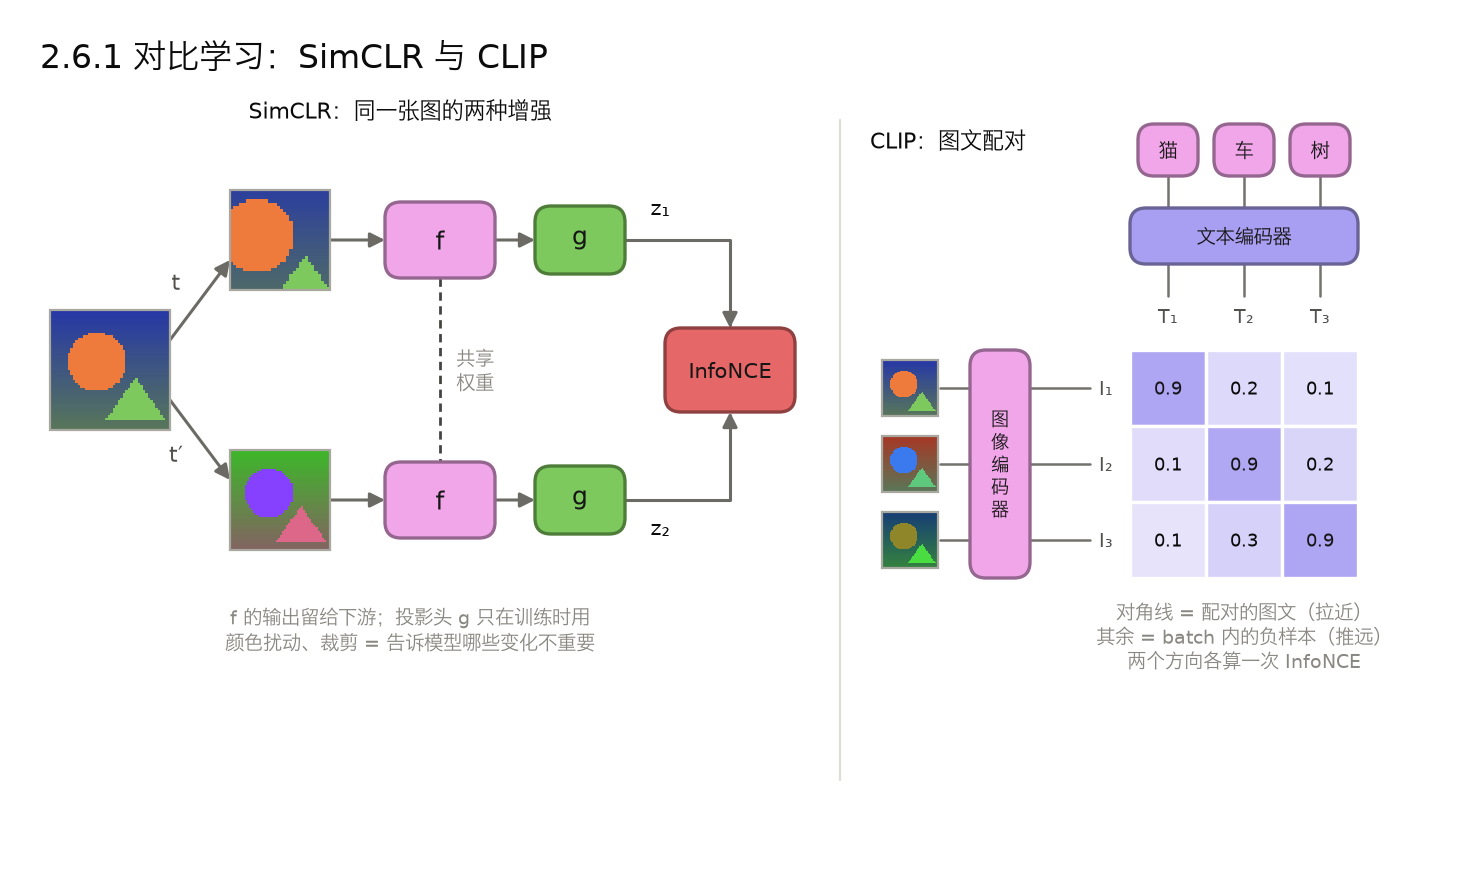
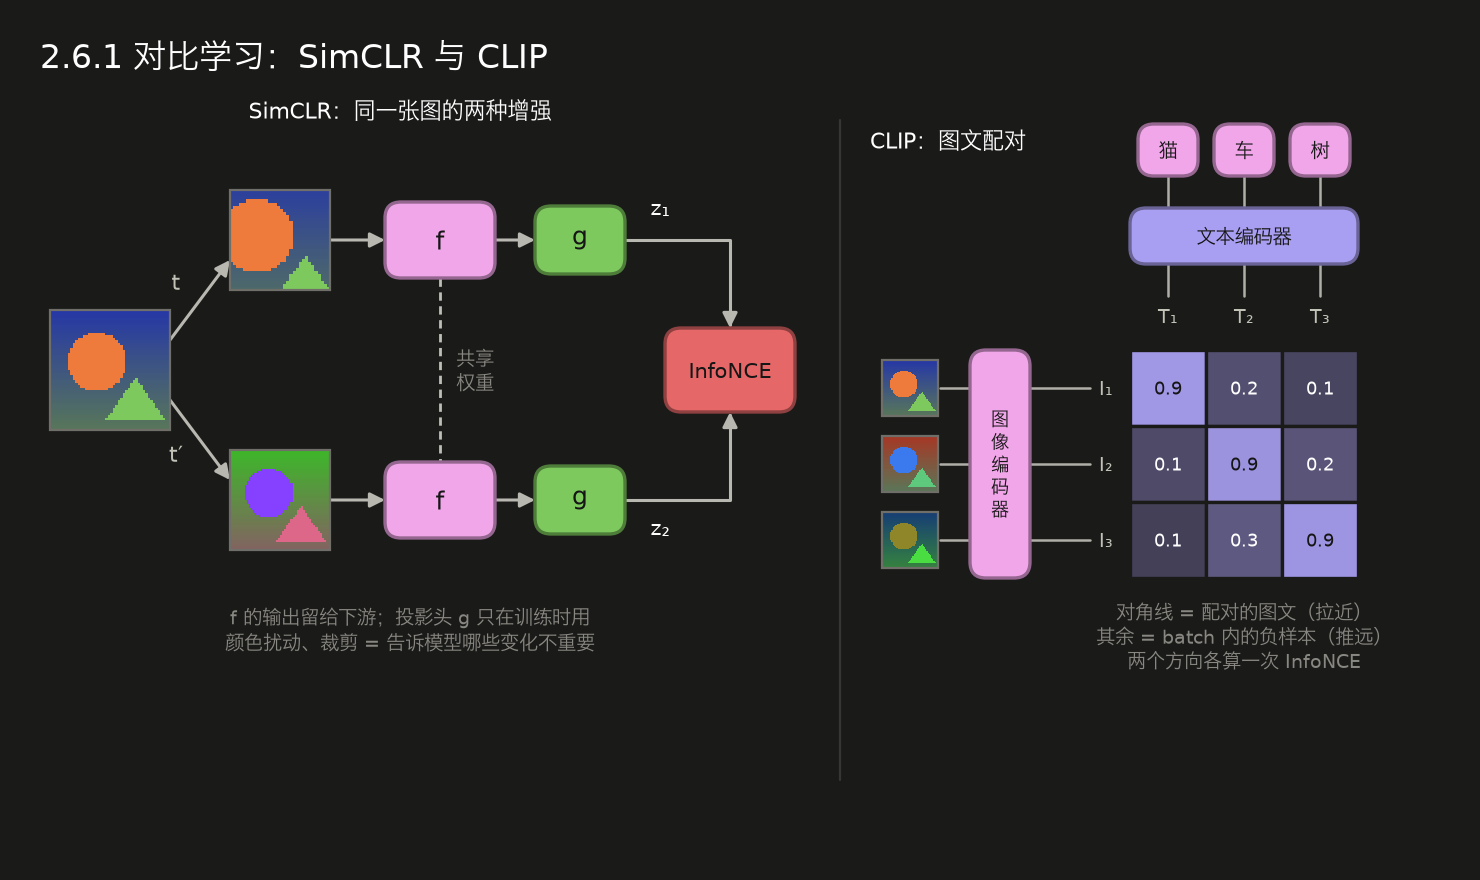
同一个东西的两个视角(两种增强、或图像和它的文字描述)表征要靠近,不同东西的表征要推远。正负关系来自数据增强或天然的配对(图文对),不需要人工类别标签;监督式的度量学习(如 FaceNet)则要用身份标签来定正负对。

孪生网络(Bromley 1993):两个输入过同一个编码器(权重共享),比较输出的距离。最早用于签名验证,后来的人脸验证(FaceNet 2015,三元组损失:锚点离正样本比离负样本近一个间隔)也是这个结构。

InfoNCE 损失:一个 batch 里有 B 对正样本 (z_i, z′_i),把第 i 对当正确答案,其余 B − 1 个当干扰项,做一个 B 选 1 的分类:

sim 是余弦相似度,τ 是温度:τ 小时只盯着最难的负样本,τ 大时对所有负样本一视同仁。跨模态时两个方向(A 找 B、B 找 A)各算一次取平均,叫对称 InfoNCE。

方法 正样本从哪来 负样本 要点
CLIP(2021) 图像和它的文字描述 batch 里其他图文对 4 亿图文对;训练后用文字描述当分类器,零样本分类
SimCLR(2020) 同一张图的两种随机增强(裁剪、颜色扰动、模糊) batch 里的其他图 投影头只在训练时用;需要大 batch
MoCo(2019) 同上 一个先进先出的负样本队列,由动量编码器产生 小 batch 也能有大量负样本
SigLIP(2023) 图文对 batch 里所有不匹配的图文对 把 softmax 换成逐对的 sigmoid,大 batch 下更省内存

数据增强决定学到什么:SimCLR 的增强里有颜色扰动,模型就学会忽略颜色;没有裁剪,模型就可能靠位置作弊。增强的设计就是在告诉模型「哪些变化不重要」。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
import torch
import torch.nn as nn
import torch.nn.functional as F

# SimCLR 式自监督:一维信号,4 类(频率不同),预训练时不看标签
def signals(n):
y = torch.randint(0, 4, (n,))
t = torch.linspace(0, 1, 64)
x = torch.sin(2 * torch.pi * (3 + 3 * y[:, None]) * t + torch.rand(n, 1) * 6.28)
return (x + 0.3 * torch.randn(n, 64)).unsqueeze(1), y

def augment(x): # 增强 = 告诉模型哪些变化不重要
x = x * (0.5 + torch.rand(x.size(0), 1, 1)) # 幅度
x = torch.roll(x, int(torch.randint(0, 64, (1,))), -1) # 平移
return x + 0.2 * torch.randn_like(x) # 噪声

def make_encoder():
return nn.Sequential(nn.Conv1d(1, 32, 7, padding=3), nn.ReLU(), nn.Conv1d(32, 32, 7, padding=3), nn.ReLU(),
nn.AdaptiveAvgPool1d(1), nn.Flatten(), nn.Linear(32, 32))

def info_nce(z1, z2, tau=0.2):
z1, z2 = F.normalize(z1, dim=1), F.normalize(z2, dim=1)
logits = z1 @ z2.T / tau # (B, B),对角线是正样本对
labels = torch.arange(z1.size(0))
return (F.cross_entropy(logits, labels) + F.cross_entropy(logits.T, labels)) / 2

def probe(encoder): # 只给 40 个带标签样本的线性探测(4 类随机抽,平均每类 10 个,没分层)
# 每次调用都重新抽标注集和测试集、重新初始化分类头,前后两次的差值里也含这部分波动
with torch.no_grad():
x_tr, y_tr = signals(40); x_te, y_te = signals(1000)
f_tr, f_te = encoder(x_tr), encoder(x_te)
clf = nn.Linear(32, 4); opt = torch.optim.Adam(clf.parameters(), lr=1e-2)
for _ in range(300):
loss = F.cross_entropy(clf(f_tr), y_tr); opt.zero_grad(); loss.backward(); opt.step()
return (clf(f_te).argmax(1) == y_te).float().mean().item()

torch.manual_seed(0)
encoder = make_encoder()
proj = nn.Sequential(nn.Linear(32, 64), nn.ReLU(), nn.Linear(64, 32)) # 投影头:只在预训练时用
print(f"随机初始化的编码器,线性探测准确率 {probe(encoder):.3f}")
opt = torch.optim.Adam(list(encoder.parameters()) + list(proj.parameters()), lr=1e-3)
for step in range(400):
x, _ = signals(256) # 不用标签
loss = info_nce(proj(encoder(augment(x))), proj(encoder(augment(x))))
opt.zero_grad(); loss.backward(); opt.step()
print(f"对比学习预训练后,线性探测准确率 {probe(encoder):.3f}(随机猜 0.25)")
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
import torch
import torch.nn as nn
import torch.nn.functional as F

# CLIP 式跨模态对齐:同一物体的「视觉特征」和「触觉特征」来自同一个隐变量,但经过不同变换、各自带噪声
torch.manual_seed(0)
Mv, Mt = torch.randn(8, 32), torch.randn(8, 24)
def pairs(n):
z = torch.randn(n, 8)
return torch.tanh(z @ Mv) + 0.1 * torch.randn(n, 32), torch.tanh(z @ Mt) + 0.1 * torch.randn(n, 24)

class DualEncoder(nn.Module):
def __init__(self, d=64):
super().__init__()
self.f_v = nn.Sequential(nn.Linear(32, 128), nn.ReLU(), nn.Linear(128, d)) # 视觉塔
self.f_t = nn.Sequential(nn.Linear(24, 128), nn.ReLU(), nn.Linear(128, d)) # 触觉塔
self.log_tau = nn.Parameter(torch.tensor(-2.0)) # 可学习温度(CLIP 的做法)

def forward(self, v, t):
zv, zt = F.normalize(self.f_v(v), dim=-1), F.normalize(self.f_t(t), dim=-1)
return zv @ zt.T / self.log_tau.exp() # (B, B) 相似度矩阵

model = DualEncoder()
opt = torch.optim.Adam(model.parameters(), lr=1e-3)
for step in range(1500):
v, t = pairs(256)
logits = model(v, t)
labels = torch.arange(256)
loss = (F.cross_entropy(logits, labels) + F.cross_entropy(logits.T, labels)) / 2 # 对称 InfoNCE
opt.zero_grad(); loss.backward(); opt.step()

with torch.no_grad():
v, t = pairs(1000)
acc = (model(v, t).argmax(1) == torch.arange(1000)).float().mean().item()
print(f"用视觉特征在 1000 个触觉特征里找出配对的那个,准确率 {acc:.3f}(随机猜 0.001)")
print(f"学到的温度 τ = {model.log_tau.exp().item():.3f}")

典型例子

  • CLIP:零样本 ImageNet 分类(ViT-L/14@336px 约 76%),把类别名写成「a photo of a {类别}」当分类器
  • CLIP / SigLIP 的图像编码器是多模态大模型和大多数 VLA 的视觉入口;CLIP 的文本编码器是 Stable Diffusion v1 的文本条件(SD 2 换成 OpenCLIP,SDXL、SD3 又加了别的文本编码器)
  • 人脸验证:FaceNet
  • 检索:图搜图、文搜图、RAG 里的句子嵌入
  • 机器人与触觉:R3M 用视频与语言的对比目标预训练机器人视觉表征;TVL、UniTouch 等把触觉对齐到视觉-语言空间,让数据很少的触觉模态借用图文预训练学到的语义结构
  • 优势:自监督的对比学习不需要人工类别标签,配对关系本身就是监督;学到的嵌入空间可以直接做检索、零样本分类和跨模态对齐;双塔结构推理时每个模态的嵌入可以预先算好建索引
  • 局限:依赖大 batch 或大量负样本;增强和配对的质量决定上限;容易学到捷径特征;对齐过程会压掉某个模态特有的信息,常配合重建类目标使用
  • 适合的数据:成对或多视角的数据:图文对、视觉-触觉对、同一样本的不同增强、多视角图像;检索和度量学习任务

2.6.2 MAE 掩码自编码器
<center>2.6.2 MAE
2.6.2 MAE
<center>2.6.2 MAE
2.6.2 MAE

一句话

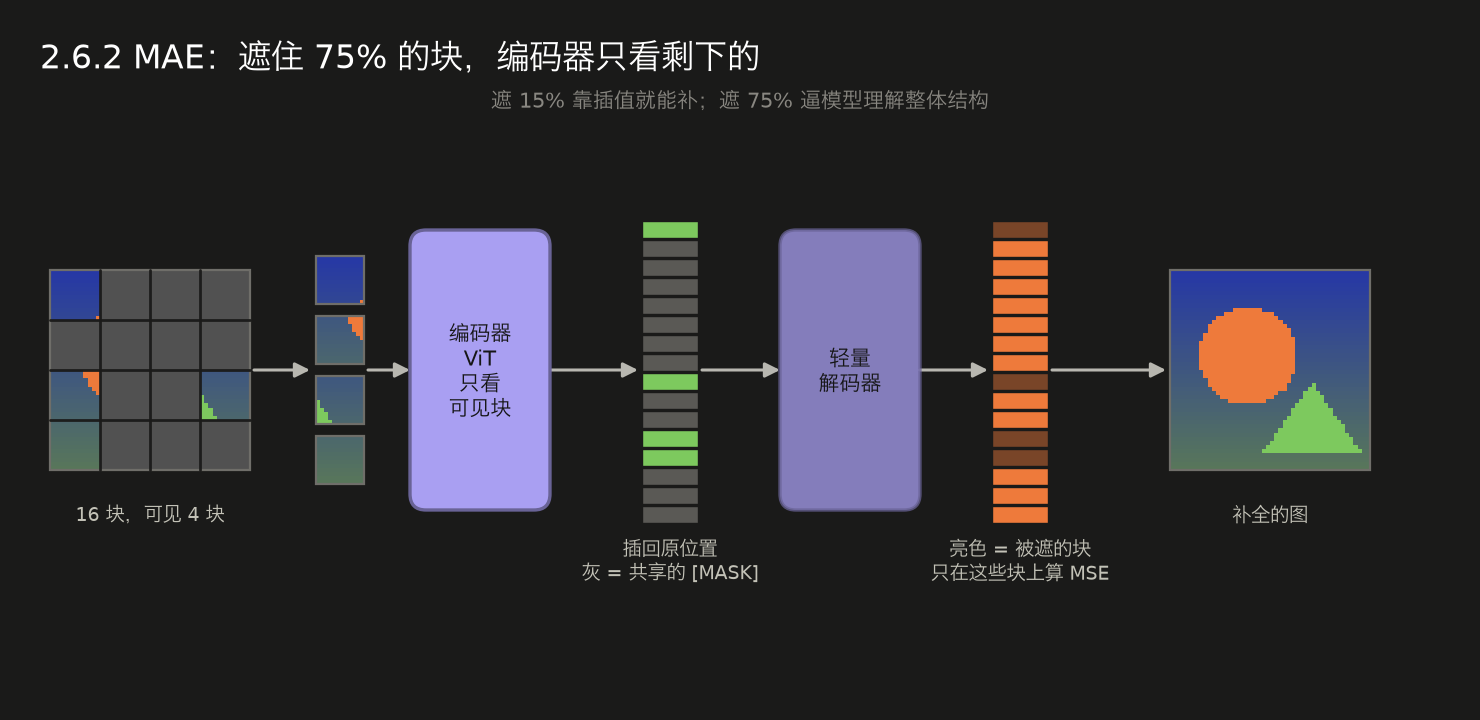
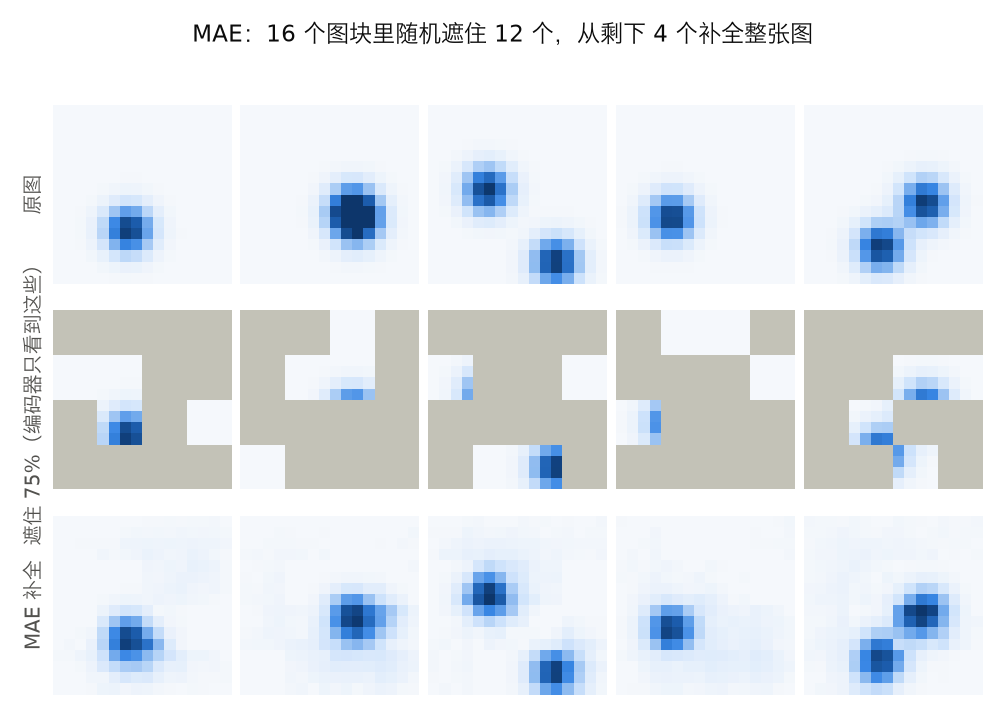
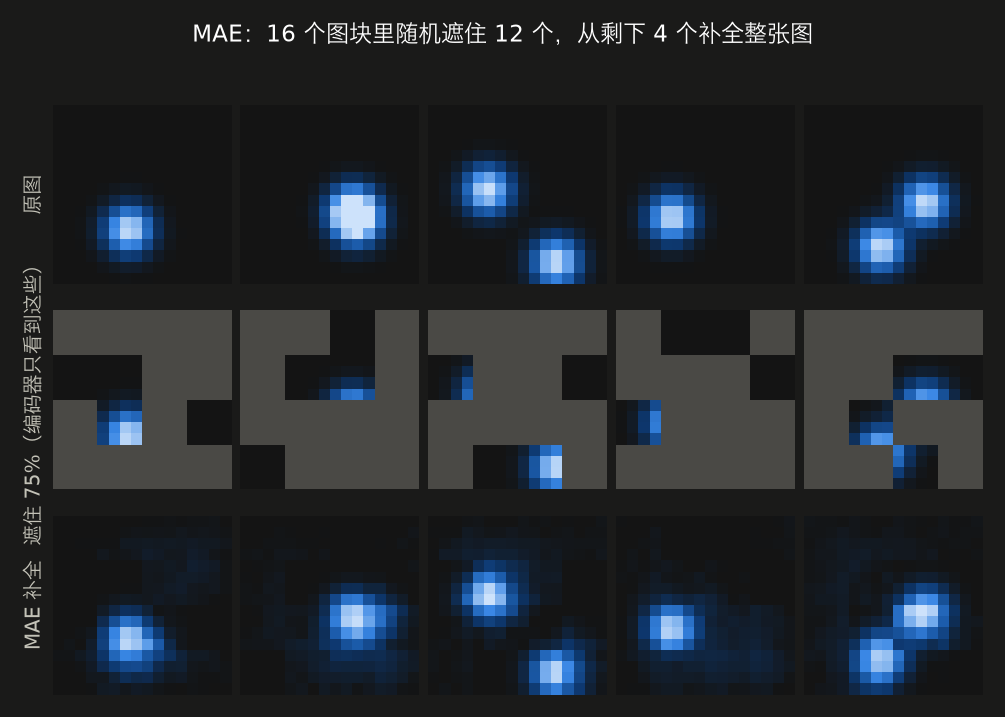
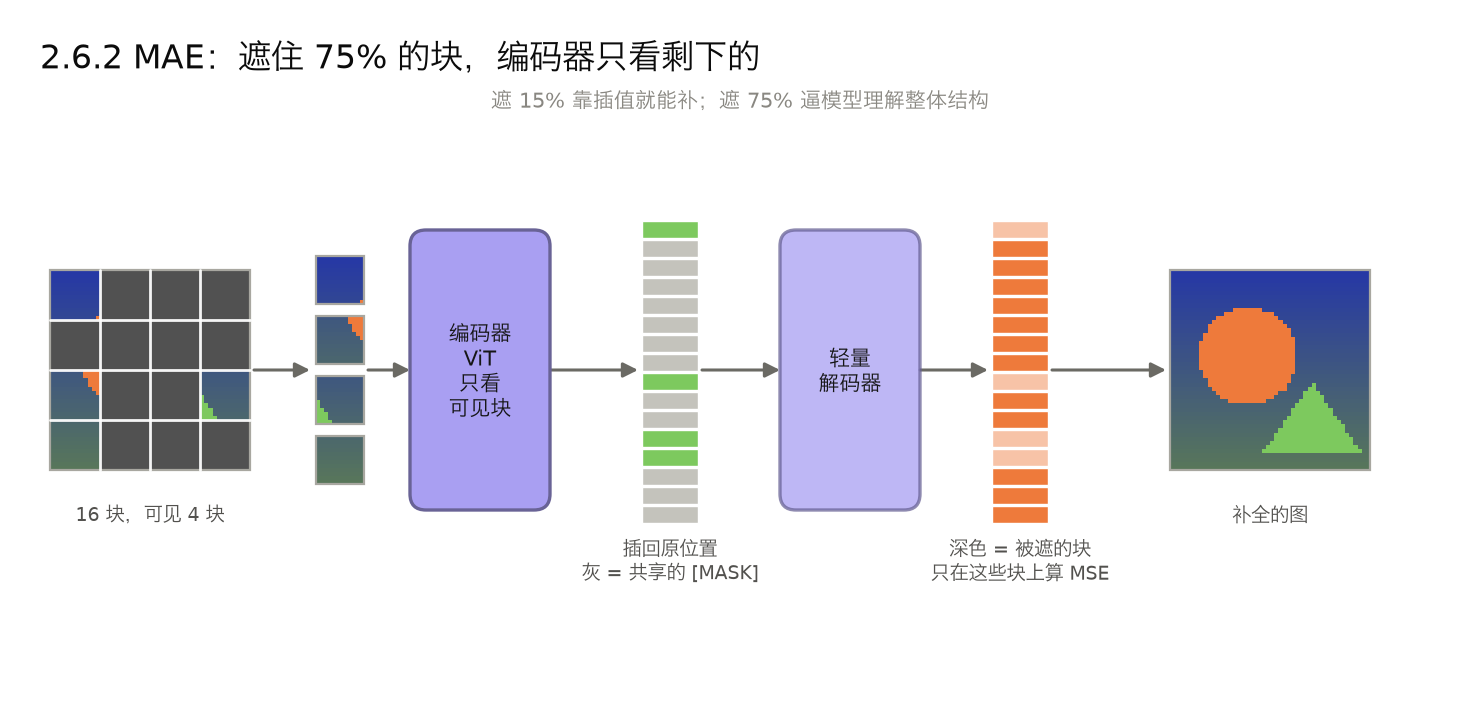
把图像切块后随机遮住 75%,编码器只看剩下的 25%,解码器负责把被遮住的块补回来;完形填空式的预训练。

设计要点(He 2021)

  1. 高遮挡率:图像的冗余很大,遮得少时靠邻近块插值就能补回来;MAE 遮 75% 才逼模型理解整体结构。BERT 的约 15% 是语言 token 里被选作预测目标的比例,掩码做法和 MAE 不完全相同(见 2.1.1)
  2. 不对称:编码器只处理可见块(计算量降到约 1/4),被遮住的位置用一个共享的可学习 [MASK] 向量占位,交给一个很轻的解码器
  3. 损失只算被遮住的部分:

和普通自编码器的差别:普通 AE 看着完整输入还原完整输入,可以靠近似恒等映射偷懒;MAE 必须从上下文推断看不到的部分。

同一思路的其他形式:BERT 的掩码语言模型(约 15% 的位置当预测目标,这些位置仍留在输入里,替换规则见 2.1.1);多模态里遮住一个模态的一部分,让模型借助其他模态补回来(比如遮住触觉、看着视觉补),直接逼出跨模态的互补关系。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
import torch
import torch.nn as nn
import torch.nn.functional as F

def blobs(n, size=16): # 每张图 0–3 个光斑(每个以 0.6 的概率出现,约 6.4% 是全暗图)
g = torch.arange(size).float()
yy, xx = torch.meshgrid(g, g, indexing="ij")
img = torch.zeros(n, size, size)
for _ in range(3):
c = torch.rand(n, 2) * (size - 4) + 2
on = (torch.rand(n) < 0.6).float()[:, None, None]
img += on * torch.exp(-((xx - c[:, 0, None, None]) ** 2 + (yy - c[:, 1, None, None]) ** 2) / 4)
return img.clamp(0, 1)

def patchify(img, p=4): # (B, 16, 16) → (B, 16 块, 16 像素)
B = img.size(0)
return img.view(B, 4, p, 4, p).permute(0, 1, 3, 2, 4).reshape(B, 16, p * p)

class MAE(nn.Module):
def __init__(self, d=64, n=16, pdim=16):
super().__init__()
self.embed = nn.Linear(pdim, d)
self.pos = nn.Parameter(torch.randn(1, n, d) * 0.02)
enc_layer = nn.TransformerEncoderLayer(d, 4, 4 * d, dropout=0.0, batch_first=True, norm_first=True)
self.encoder = nn.TransformerEncoder(enc_layer, 3, enable_nested_tensor=False)
self.mask_token = nn.Parameter(torch.zeros(1, 1, d))
dec_layer = nn.TransformerEncoderLayer(d, 4, 2 * d, dropout=0.0, batch_first=True, norm_first=True)
self.decoder = nn.TransformerEncoder(dec_layer, 1, enable_nested_tensor=False) # 轻量解码器
self.head = nn.Linear(d, pdim)

def forward(self, patches, ratio=0.75):
B, N, _ = patches.shape
n_keep = int(N * (1 - ratio))
order = torch.rand(B, N).argsort(1) # 每张图随机打乱块的顺序
keep, masked = order[:, :n_keep], order[:, n_keep:]
tokens = self.embed(patches) + self.pos
visible = torch.gather(tokens, 1, keep[..., None].expand(-1, -1, tokens.size(-1)))
enc = self.encoder(visible) # 编码器只看可见的 25%
full = self.mask_token.expand(B, N, -1).clone() # 被遮的位置放 [MASK]
full.scatter_(1, keep[..., None].expand(-1, -1, enc.size(-1)), enc)
pred = self.head(self.decoder(full + self.pos)) # 解码器补全所有位置
return pred, masked

torch.manual_seed(0)
model = MAE()
opt = torch.optim.AdamW(model.parameters(), lr=1e-3)
for step in range(1500):
patches = patchify(blobs(128))
pred, masked = model(patches)
idx = masked[..., None].expand(-1, -1, 16)
loss = F.mse_loss(torch.gather(pred, 1, idx), torch.gather(patches, 1, idx)) # 只算被遮住的块
opt.zero_grad(); loss.backward(); opt.step()

with torch.no_grad():
patches = patchify(blobs(500))
pred, masked = model(patches)
idx = masked[..., None].expand(-1, -1, 16)
target = torch.gather(patches, 1, idx)
mae_err = F.mse_loss(torch.gather(pred, 1, idx), target).item()
base = F.mse_loss(target.mean(dim=(0, 1), keepdim=True).expand_as(target), target).item()
print(f"被遮住的块:MAE 重建 MSE {mae_err:.4f},用这批被遮块自己的平均图块去猜的 MSE {base:.4f}(偷看了答案的均值,是偏乐观的基线)")
<center>MAE遮挡与补全
MAE遮挡与补全
<center>MAE遮挡与补全
MAE遮挡与补全

典型例子

  • ViT 预训练:MAE 预训练的 ViT-H 在 ImageNet 上微调到 87.8%,SAM 的图像编码器就是 MAE 预训练的
  • BERT:掩码语言模型,NLP 预训练的标准做法
  • 视频(VideoMAE)、音频(AudioMAE)、点云(Point-MAE)
  • 多模态:同时遮住视觉块和触觉块,让模型互相补全
  • 优势:目标简单,不需要负样本和复杂的增强;高遮挡率让编码器只算少量 token,预训练快;学到的特征微调效果好
  • 局限:线性探测效果不如对比学习和 DINO(特征需要微调才好用);重建目标在像素空间,会花容量在无关细节上;遮挡率要调
  • 适合的数据:能切成 token、冗余度高的数据:图像、视频、音频频谱、点云、多模态序列

2.6.3 自蒸馏与 JEPA:BYOL、DINO、I-JEPA
<center>2.6.3 自蒸馏与 JEPA
2.6.3 自蒸馏与 JEPA
<center>2.6.3 自蒸馏与 JEPA
2.6.3 自蒸馏与 JEPA

一句话

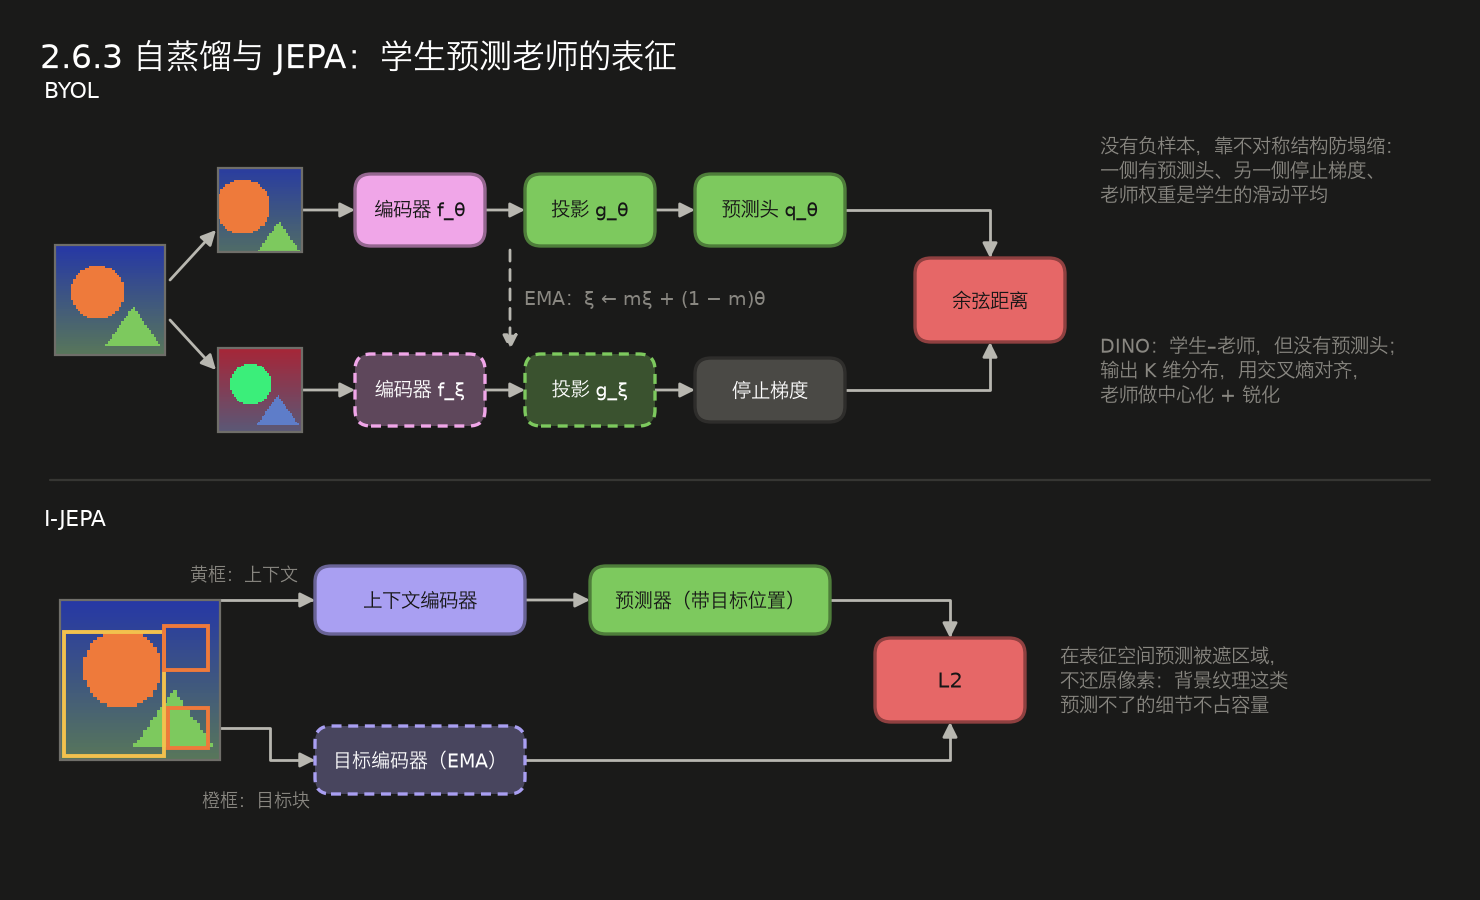
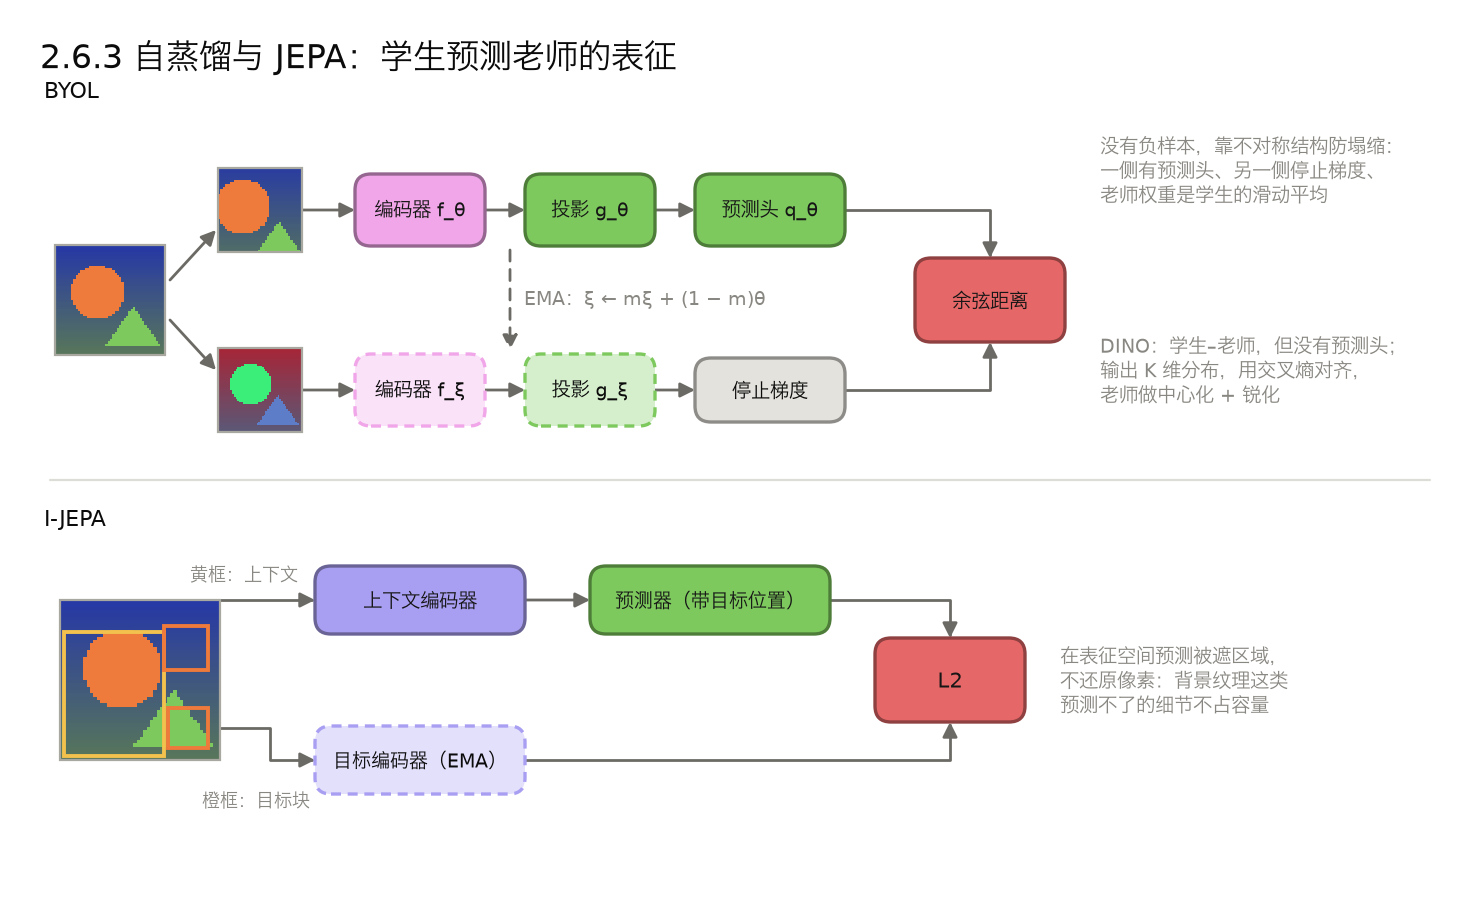
不要负样本:学生网络去预测老师网络给出的表征,老师是学生权重的滑动平均;预测发生在表征空间,不重建像素。

BYOL(2020):两个增强视角分别进在线网络和目标网络。在线网络后面多接一个预测头,去预测目标网络的输出;目标网络不回传梯度,权重是在线网络的 EMA:

没有负样本却不塌缩,靠的是「停止梯度 + EMA 老师 + 只在一侧加预测头」这套不对称结构;投影头里的 BatchNorm 在 batch 内做归一化,本身也能挡住一部分塌缩。下面的代码把这几样都去掉后,表征很快塌缩成常数。

DINO(2021)/ DINOv2(2023):同样是学生-老师自蒸馏,输出变成在 K 个原型上的概率分布,老师的输出做中心化(防止一个维度独占)和锐化(防止均匀分布)。DINOv2 的特征不微调就能直接做检索、深度估计、分割,是机器人视觉编码器的常用选择。

JEPA(I-JEPA 2023,V-JEPA 2024–2025):联合嵌入预测架构。遮住图像(或视频)的一些区域,让预测器从可见部分的表征去预测被遮区域的表征,目标由 EMA 老师编码器给出。和 MAE 的区别是预测目标在表征空间,不用还原像素,模型不必在背景纹理这类无法预测的细节上花容量。LeCun 主张把它作为世界模型的基础:只预测未来的表征,不去生成未来的像素。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
import copy
import torch
import torch.nn as nn
import torch.nn.functional as F

def signals(n): # 与 2.6.1 相同的一维信号
y = torch.randint(0, 4, (n,))
t = torch.linspace(0, 1, 64)
x = torch.sin(2 * torch.pi * (3 + 3 * y[:, None]) * t + torch.rand(n, 1) * 6.28)
return (x + 0.3 * torch.randn(n, 64)).unsqueeze(1), y

def augment(x):
x = x * (0.5 + torch.rand(x.size(0), 1, 1))
x = torch.roll(x, int(torch.randint(0, 64, (1,))), -1)
return x + 0.2 * torch.randn_like(x)

def make_encoder():
return nn.Sequential(nn.Conv1d(1, 32, 7, padding=3), nn.ReLU(), nn.Conv1d(32, 32, 7, padding=3), nn.ReLU(),
nn.AdaptiveAvgPool1d(1), nn.Flatten(), nn.Linear(32, 32))

def byol_loss(p, z):
return (2 - 2 * F.cosine_similarity(p, z, dim=-1)).mean()

def mlp(d_in, d_out, bn=True): # BYOL 的投影头、预测头都带 BatchNorm
norm = nn.BatchNorm1d(64) if bn else nn.Identity()
return nn.Sequential(nn.Linear(d_in, 64), norm, nn.ReLU(), nn.Linear(64, d_out))

def train(use_tricks, bn, steps=300):
torch.manual_seed(0)
encoder, projector, predictor = make_encoder(), mlp(32, 32, bn=bn), mlp(32, 32)
online = nn.Sequential(encoder, projector)
target = copy.deepcopy(online).requires_grad_(False) # 老师:在线网络的 EMA
params = list(online.parameters()) + (list(predictor.parameters()) if use_tricks else [])
opt = torch.optim.Adam(params, lr=3e-3)
for step in range(steps):
x, _ = signals(128)
v1, v2 = augment(x), augment(x)
if use_tricks: # BYOL:预测头 + 停止梯度 + EMA 老师
loss = byol_loss(predictor(online(v1)), target(v2).detach()) + \
byol_loss(predictor(online(v2)), target(v1).detach())
else: # 去掉全部技巧:两个视角直接互相拉近
loss = byol_loss(online(v1), online(v2))
opt.zero_grad(); loss.backward(); opt.step()
if use_tricks:
with torch.no_grad():
for pt, po in zip(target.parameters(), online.parameters()):
pt.mul_(0.99).add_(0.01 * po)
encoder.eval(); online.eval()
with torch.no_grad():
x, y = signals(1000)
spread = F.normalize(online(x), dim=1).std(0).mean().item() # 接近 0 = 塌缩
x_tr, y_tr = signals(40) # 每种配置各自抽探测数据、各自初始化分类头,差值里也含这部分波动
f_tr, f_te = encoder(x_tr), encoder(x)
clf = nn.Linear(32, 4); o = torch.optim.Adam(clf.parameters(), lr=1e-2)
for _ in range(300):
l = F.cross_entropy(clf(f_tr), y_tr); o.zero_grad(); l.backward(); o.step()
return spread, (clf(f_te).argmax(1) == y).float().mean().item()

for use_tricks, bn, name in [(True, True, "BYOL(完整)"),
(False, True, "去掉预测头、停止梯度、EMA,保留 BatchNorm"),
(False, False, "再去掉投影头里的 BatchNorm")]:
spread, acc = train(use_tricks, bn)
print(f"{name}:表征离散度 {spread:.4f},40 个标签(平均每类 10 个)的线性探测准确率 {acc:.3f}") # 离散度测投影头输出,探测用编码器输出
# 32 维单位向量完全随机分布时,离散度约为 1/√32 ≈ 0.18

常见说法与实测

常见说法:BYOL 没有负样本却不塌缩,靠的是预测头、停止梯度和 EMA 老师这套不对称结构。

实测:三样都去掉、但投影头里保留 BatchNorm 时,表征没有完全塌成常数(离散度 0.064,完整 BYOL 是 0.15;离散度不为 0 不能排除只剩少数几个方向的部分塌缩),线性探测准确率仍是 1.0;再把 BatchNorm 也去掉,离散度降到 0.0001,准确率掉到 0.24(等于瞎猜)。

怎么理解:BatchNorm 用整个 batch 的统计量做归一化,会把同一个 batch 里输出之间的微小差别重新放大到单位方差,在优化上起到了隐式的防塌缩作用。它并不从数学上排除常数解:输入完全相同时 BN 的输出全都等于 β,γ = 0 时也输出常数;这个实验只说明在当前设置下保留 BN 有帮助。2020 年有分析据此认为 BatchNorm 才是 BYOL 不塌缩的原因;BYOL 作者随后说明,换成不依赖 batch 统计量的 GroupNorm 加权重标准化、配合合适的初始化,BYOL 照样能训练(Richemond 等 2020,《BYOL works even without batch statistics》)。两种机制都能起作用,实际训练里通常同时存在。

典型例子

  • DINOv2:通用视觉特征,OpenVLA 等 VLA 把 DINOv2 和 SigLIP 的特征拼起来当视觉输入
  • DINO 的注意力图不用任何标注就能分割出前景物体
  • I-JEPA、V-JEPA 2:在表征空间做预测的图像和视频模型,V-JEPA 2 被用于机器人规划
  • 隐空间世界模型:在编码后的表征空间预测未来(见 3.2)
  • 优势:不需要负样本,对 batch 大小不敏感;预测目标在表征空间,不浪费容量在不可预测的像素细节上;DINO 系列的特征拿来就能用
  • 局限:塌缩风险始终存在,训练对 EMA 系数、增强、中心化等细节敏感;为什么不塌缩的理论解释还不完整;效果上限受老师表征质量制约
  • 适合的数据:大规模无标注图像、视频;需要通用、可直接复用特征的视觉任务;隐空间世界模型

2.6.4 自编码器 AE 〔图:AE〕
<center>2.6.4 自编码器
2.6.4 自编码器
<center>2.6.4 自编码器
2.6.4 自编码器

一句话

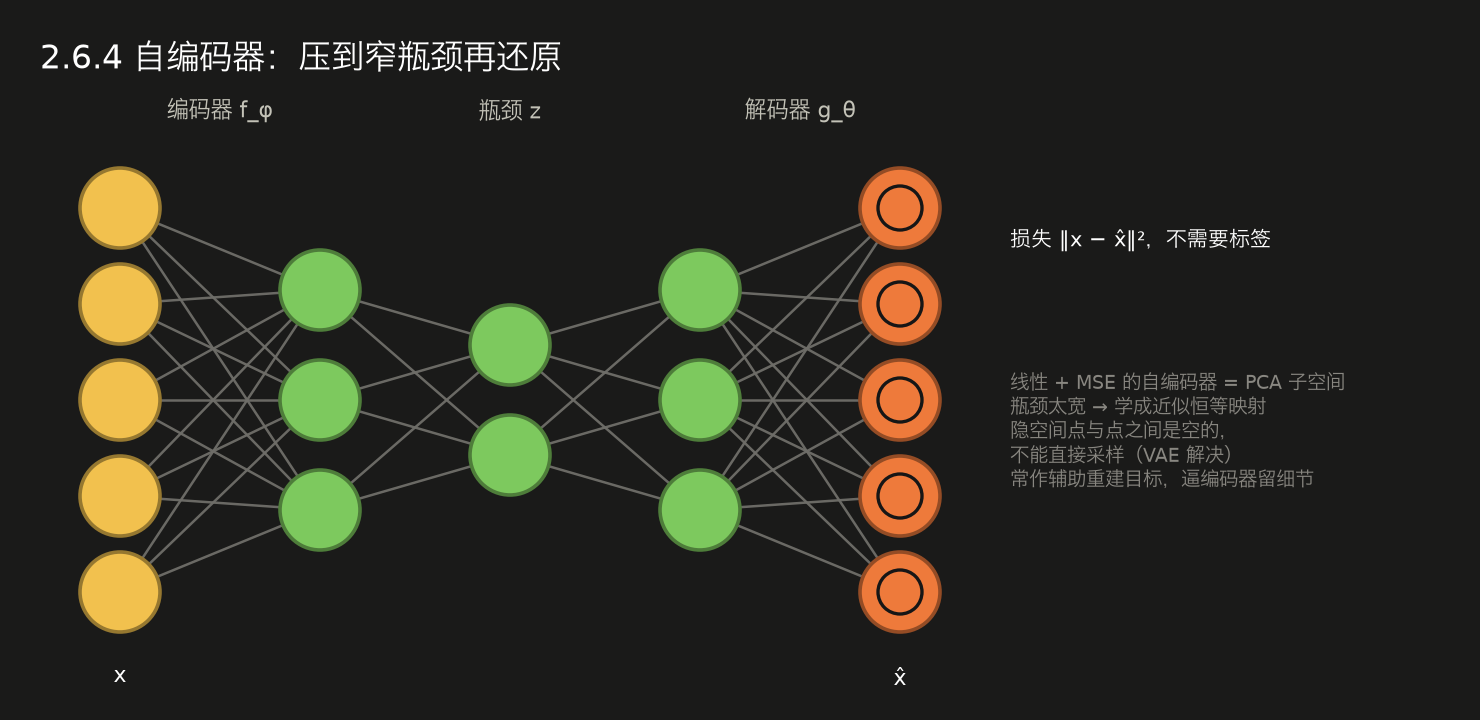
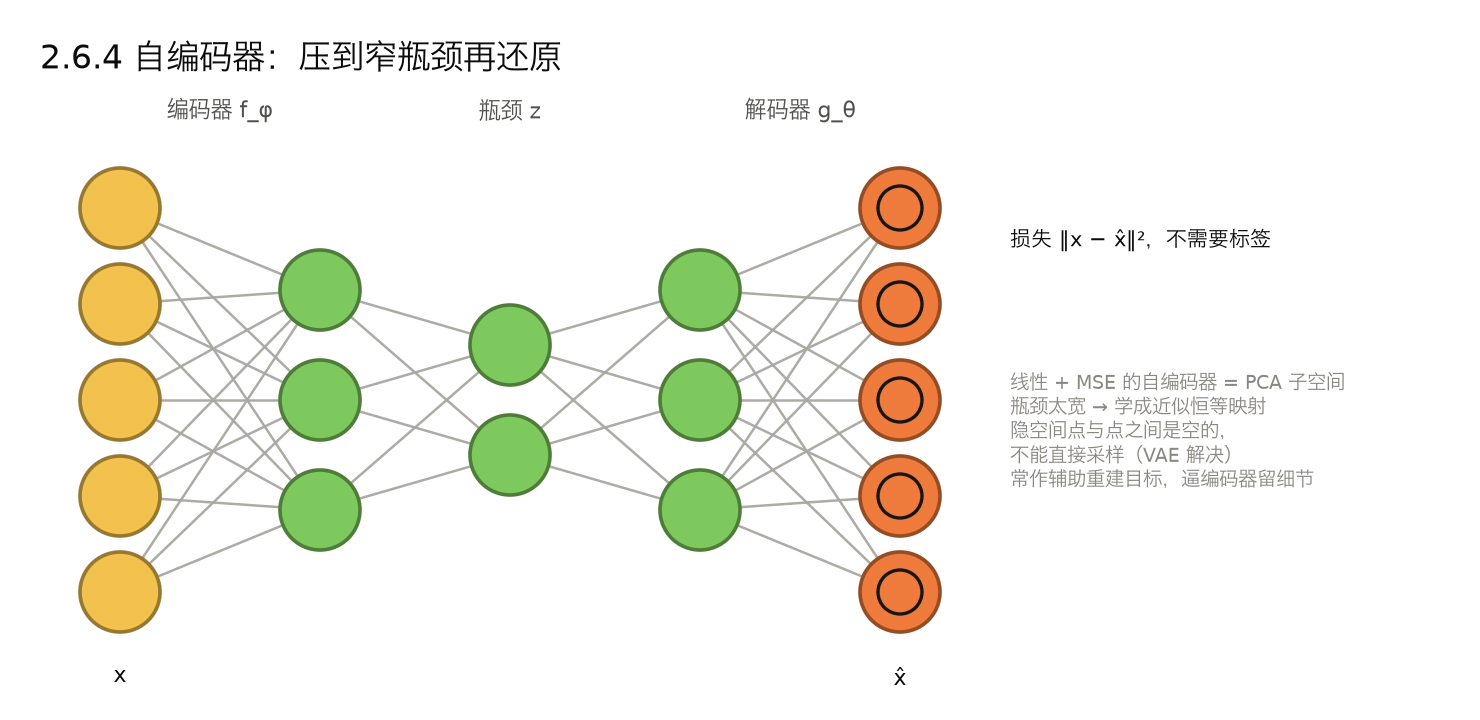
编码器把输入压到一个窄瓶颈,解码器再还原回来,损失是还原误差;不需要标签。

图中 AE 是对称的沙漏形,输出单元画成「输入输出匹配单元」:训练目标就是复现输入。

要点

  • 瓶颈比输入窄,网络只能保留最重要的信息。去掉所有非线性、用 MSE 训练的线性自编码器,学到的子空间就是 PCA 的主成分子空间;加了非线性就是非线性降维
  • 隐空间没有约束,点与点之间是空的,不能直接从中采样生成新样本(这是 VAE 要解决的问题,见 2.2.3)
  • 瓶颈太宽时会学成近似恒等映射,学不到有用的结构
  • 作为辅助重建目标:在一个主任务(比如机器人策略)的编码器上加一个解码器,要求它能还原原始输入,防止编码器只学到对主任务「够用」的粗糙特征。触觉编码器只靠动作损失训练时,容易只学到「有没有接触」这种粗信息,加重建目标能逼它保留形变方向、剪切这类细节;代价是噪声也被一起保留
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
import torch
import torch.nn as nn

class AutoEncoder(nn.Module):
def __init__(self, in_dim, latent_dim):
super().__init__()
self.encoder = nn.Sequential(nn.Linear(in_dim, 64), nn.ReLU(), nn.Linear(64, latent_dim))
self.decoder = nn.Sequential(nn.Linear(latent_dim, 64), nn.ReLU(), nn.Linear(64, in_dim))

def forward(self, x):
z = self.encoder(x) # 压到瓶颈
return self.decoder(z), z # 再还原

torch.manual_seed(0)
# 正常数据:藏在 20 维空间里的一个 2 维曲面(比如一台机器正常工况下的 20 路传感器读数)
proj = torch.randn(2, 20)
def normal_data(n):
s = torch.rand(n, 2) * 2 - 1
return torch.tanh(s @ proj) + 0.02 * torch.randn(n, 20)

model = AutoEncoder(20, 2)
opt = torch.optim.Adam(model.parameters(), lr=1e-3)
for step in range(3000):
x = normal_data(128)
loss = nn.functional.mse_loss(model(x)[0], x)
opt.zero_grad(); loss.backward(); opt.step()

# 异常检测:重建误差大 = 不像训练时见过的数据
with torch.no_grad():
err = lambda x: (model(x)[0] - x).pow(2).mean(1)
normal, anomaly = normal_data(1000), torch.rand(1000, 20) * 2 - 1
thr = err(normal).quantile(0.99) # 阈值:正常数据误差的 99 分位
print(f"正常样本平均误差 {err(normal).mean():.4f},异常样本平均误差 {err(anomaly).mean():.4f}")
print(f"异常检出率 {(err(anomaly) > thr).float().mean():.3f},误报率 {(err(normal) > thr).float().mean():.3f}(在定阈值的同一批正常样本上算,约 1% 是按定义来的,不是独立测试)")

典型例子

  • 工业异常检测:只用正常工况的振动、电流、图像训练,重建误差大就报警(MVTec AD 等基准)
  • 降维与可视化:比 PCA 更灵活的非线性降维
  • 图像压缩:学习式图像压缩(Ballé 2017)的主体是自编码器加熵模型
  • 机器人:Deep Spatial Autoencoder(Finn 2016)把相机图像压成特征点坐标,再用来学视觉运动策略
  • 2006 年 Hinton 在 Science 上用深层自编码器做降维,是深度学习复兴的标志性工作之一
  • 优势:不需要标签;能学非线性降维;重建误差天然可以当异常分数;编码器可以当预训练的特征提取器
  • 局限:隐空间不规整,不能直接采样生成;容易学成恒等映射;像素级 MSE 偏向模糊、会保留无关细节
  • 适合的数据:无标签、高维、实际集中在低维流形上的数据:多通道传感器读数、图像、频谱;压缩、降维、异常检测

2.6.5 稀疏自编码器 SAE 〔图:SAE〕
<center>2.6.5 稀疏自编码器
2.6.5 稀疏自编码器
<center>2.6.5 稀疏自编码器
2.6.5 稀疏自编码器

一句话

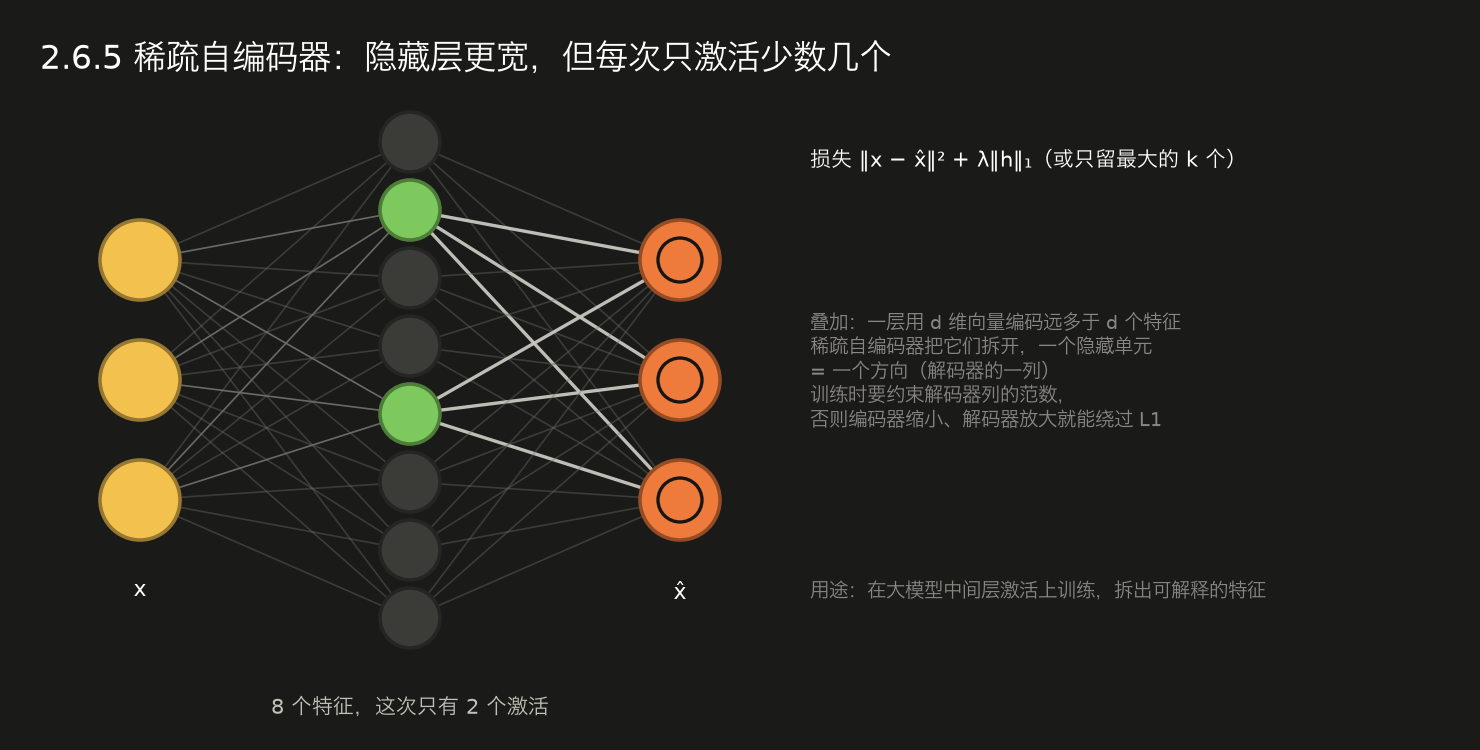
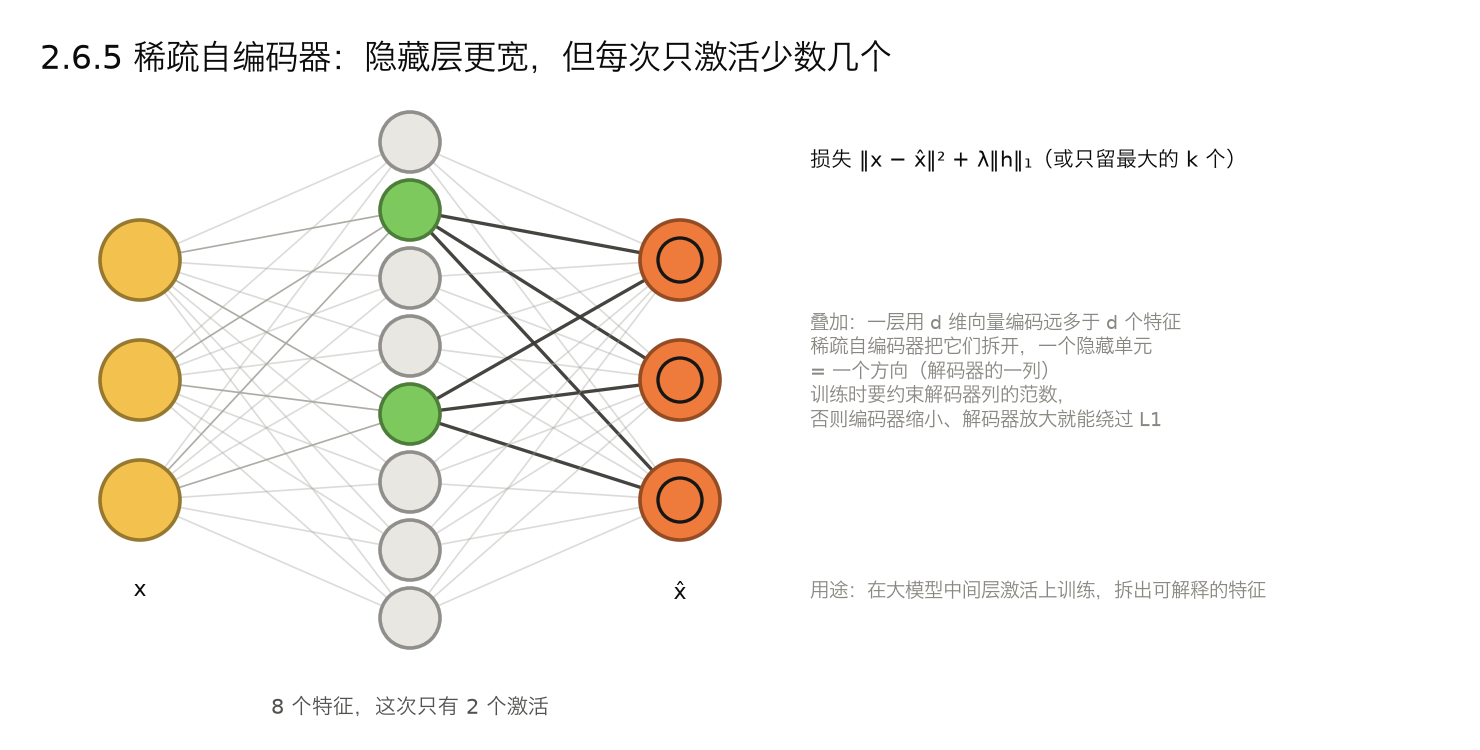
隐藏层可以比输入还宽,但每个输入只允许少数几个隐藏单元激活;网络被迫把输入拆成少数几个「概念」的组合。

图中 SAE 的隐藏层比输入和输出都宽(菱形)。稀疏的实现方式:L1 惩罚(上式)、KL 散度把每个单元的平均激活率拉到一个小目标值(如 0.05)、或者直接只保留最大的 k 个激活(TopK SAE)。

叠加(superposition):神经网络的一层里,往往用 d 维向量编码远多于 d 个特征,每个特征是一个方向,彼此不完全正交,靠「同一时刻只有少数特征活跃」来避免混淆。稀疏自编码器正好能把这些叠加在一起的特征拆开,每个隐藏单元对应一个方向。

现在最火的用途:大模型可解释性。Anthropic 2023 年在小模型、2024 年在 Claude 3 Sonnet 的中间层激活上训练稀疏自编码器,拆出了数百万个可解释的特征(比如一个专门对「金门大桥」响应的特征,人为放大它,模型会在各种话题里把自己说成金门大桥)。OpenAI 等也发表了 TopK SAE 的扩展方法。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
import torch
import torch.nn as nn
import torch.nn.functional as F

class SparseAE(nn.Module):
def __init__(self, in_dim, n_features):
super().__init__()
self.enc = nn.Linear(in_dim, n_features)
self.dec = nn.Linear(n_features, in_dim, bias=False)

def forward(self, x):
h = F.relu(self.enc(x)) # 过完备:隐藏单元数 > 输入维度
return self.dec(h), h

torch.manual_seed(0)
d, n_true = 20, 40
atoms = F.normalize(torch.randn(n_true, d), dim=1) # 40 个真实「特征方向」挤在 20 维里(叠加)
def data(n, k=3):
idx = torch.rand(n, n_true).argsort(1)[:, :k] # 每个样本只有 3 个特征活跃
coef = torch.zeros(n, n_true).scatter_(1, idx, torch.rand(n, k) + 0.5)
return coef @ atoms

def train(lam, normalize=True, steps=6000):
torch.manual_seed(0)
model = SparseAE(d, 80)
opt = torch.optim.Adam(model.parameters(), lr=2e-3)
for step in range(steps):
x = data(512)
x_hat, h = model(x)
loss = F.mse_loss(x_hat, x) + lam * h.abs().sum(1).mean() # 重建 + L1 稀疏
opt.zero_grad(); loss.backward(); opt.step()
if normalize: # 解码器每一列(每个特征的方向)归一化成单位长度;
with torch.no_grad(): # 否则模型会把 h 缩小、解码器放大来逃避 L1
model.dec.weight.data = F.normalize(model.dec.weight.data, dim=0)
return model

for lam, normalize in [(1e-2, False), (3e-3, True), (1e-2, True)]:
model = train(lam, normalize)
with torch.no_grad():
x = data(2000)
x_hat, h = model(x)
learned = F.normalize(model.dec.weight.T, dim=1) # 每个隐藏单元对应的解码方向
best = (atoms @ learned.T).max(1).values # 每个真实特征找最像的单元
print(f"λ = {lam}{'' if normalize else ',解码器不归一化'}:重建相对误差 {((x_hat - x).norm() / x.norm()).item():.3f},"
f"平均激活单元 {(h > 1e-3).float().sum(1).mean():.1f} 个,"
f"40 个真实特征找回 {(best > 0.9).sum().item()} 个(余弦 > 0.9)")
# λ 大:更稀疏、找回的特征更多,但重建变差;λ 小则相反

常见说法与实测

常见说法:在自编码器的损失里加一个 L1 惩罚,隐藏层就会变稀疏,学到可解释的特征。

实测:λ = 0.01、只加 L1 不约束解码器时,重建误差最小(0.036),但平均激活 19 个单元,40 个真实特征只找回 1 个;每次更新后把解码器每一列归一化成单位长度,同样的 λ 找回 32 个。λ 降到 0.003 时只找回 8 个,重建更好(0.103 对 0.243)。

怎么理解:L1 惩罚的是 h 的大小。模型可以把 h 整体缩小、把解码器权重同比放大,重建不变、惩罚变小,等于绕开了约束。所以用 L1 惩罚激活的稀疏自编码器通常都会约束解码器的列范数(或者把列范数乘进惩罚项),λ 再在稀疏和重建之间取舍。

典型例子

  • 大语言模型可解释性:从模型内部激活里拆出可解释、可干预的特征
  • 稀疏编码:在自然图像小块上学到的字典很像视觉皮层 V1 的 Gabor 状边缘检测器(Olshausen & Field 1996,同一个原理)
  • 早期深度学习里用于逐层无监督预训练
  • 优势:特征更可解释,一个单元对应一个相对独立的概念;能从过完备表示中拆出叠加的特征;稀疏表示对下游线性分类友好
  • 局限:λ 难调(太大重建差、太小不稀疏);会出现从不激活的「死特征」;特征数很大时训练成本高;拆出来的特征是否就是模型「真正使用」的概念,仍有争议
  • 适合的数据:由少数独立因素叠加而成的数据:神经网络内部激活、自然图像小块、多源混合信号

2.6.6 去噪自编码器 DAE 〔图:DAE〕
<center>2.6.6 去噪自编码器
2.6.6 去噪自编码器
<center>2.6.6 去噪自编码器
2.6.6 去噪自编码器

一句话

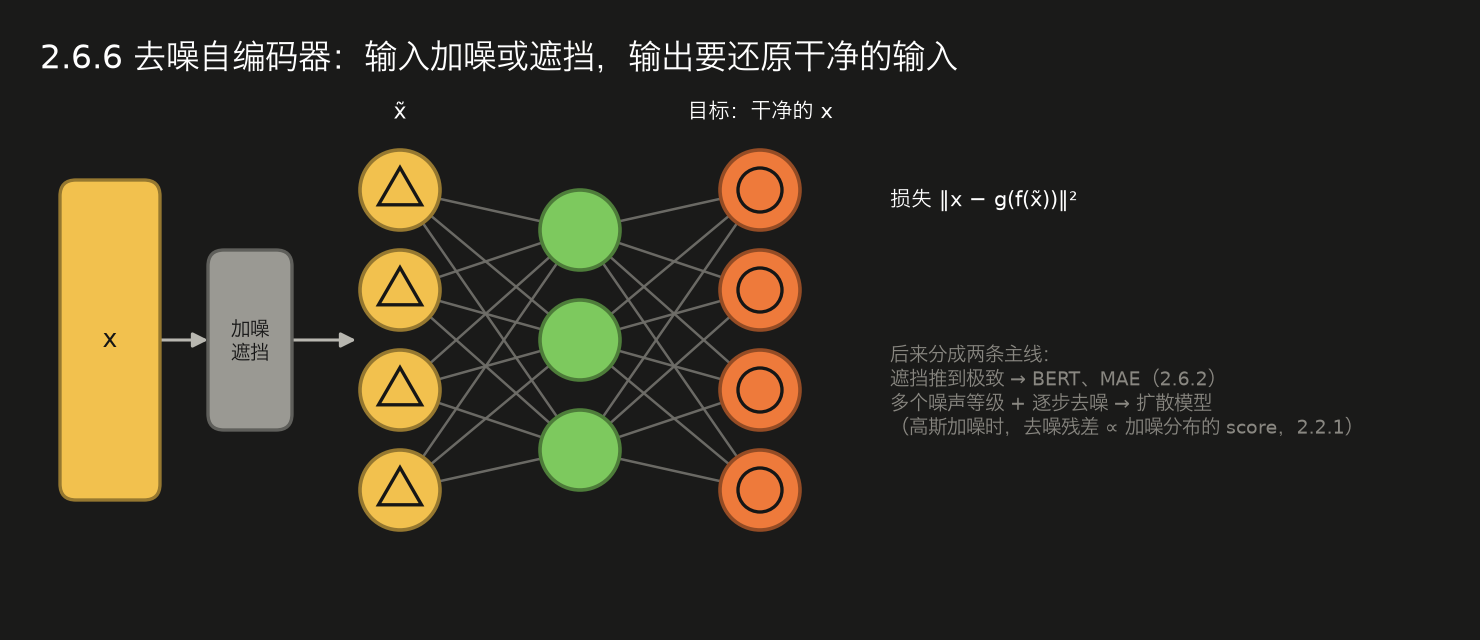
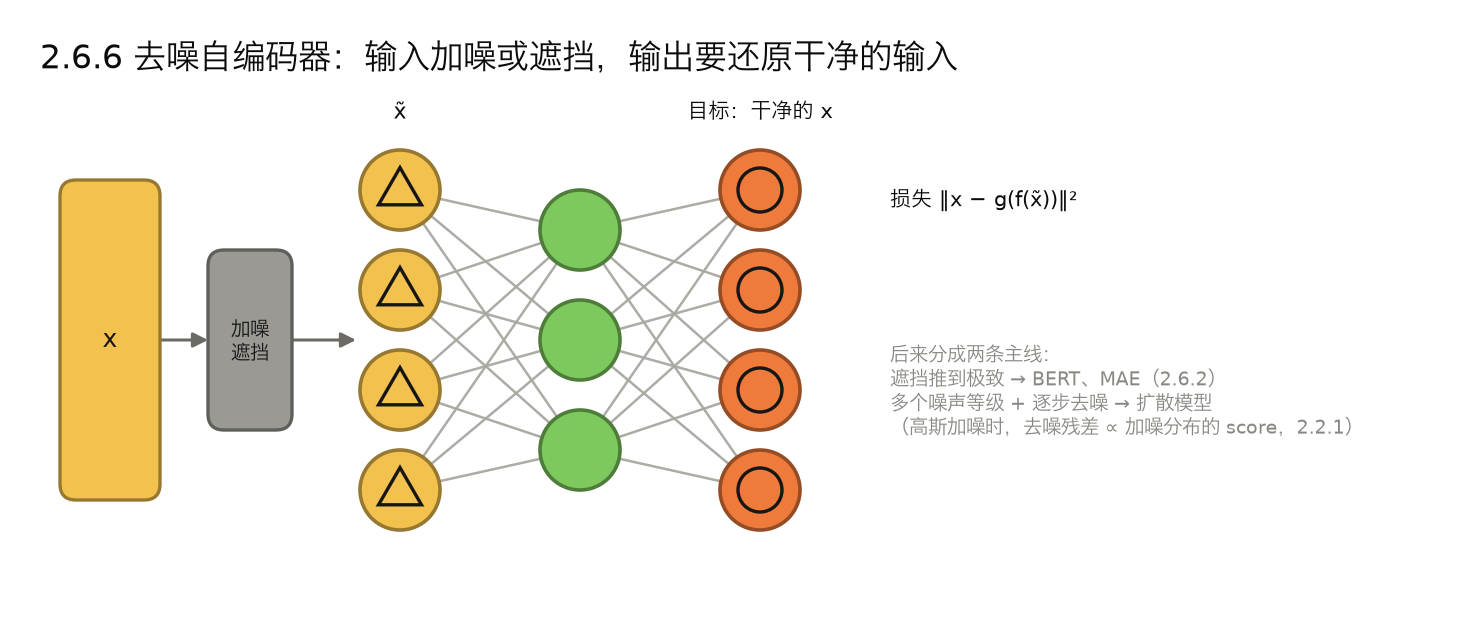
输入先加噪或遮挡,要求输出还原干净的原始输入;学到的特征对噪声和缺失更鲁棒。

图中 DAE 的输入单元画成「带噪输入单元」(带三角的黄色圆)。Vincent 2008 年提出。

为什么重要:DAE 的思想后来分成了两条主线。

  1. 掩码预训练:「遮挡」这种腐蚀推到极致,就是 BERT 和 MAE(2.6.2)
  2. 扩散模型:在很多个噪声等级上同时训练去噪器,再一步步去噪,就是扩散模型(2.2.1)。两者靠 score 联系起来,见下

去噪和 score 的关系(Vincent 2011):高斯加噪、平方重建损失下,训练去噪自编码器等价于对加噪后的分布做 score matching。最优去噪器 r*_σ 的重建残差除以噪声方差,正好是加噪分布 p_σ 的 score(对数密度的梯度):

p_σ 是数据和高斯噪声卷积后的分布,噪声很小时才接近原数据分布的 score(Alain & Bengio 2014);随机遮挡这类腐蚀不适用这个关系。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
import torch
import torch.nn as nn

def clean_signals(n, T=128):
"""随机频率、相位的正弦混合,模拟干净的振动或触觉信号"""
t = torch.linspace(0, 1, T)
f = torch.randint(2, 8, (n, 2, 1)).float()
ph = torch.rand(n, 2, 1) * 6.28
return (torch.sin(2 * torch.pi * f * t + ph).sum(1, keepdim=True)) / 2 # (n, 1, T)

class DenoisingAE(nn.Module):
def __init__(self):
super().__init__()
self.encoder = nn.Sequential(nn.Conv1d(1, 16, 9, stride=2, padding=4), nn.ReLU(),
nn.Conv1d(16, 32, 9, stride=2, padding=4), nn.ReLU()) # 128 → 32
self.decoder = nn.Sequential(nn.ConvTranspose1d(32, 16, 8, stride=2, padding=3), nn.ReLU(),
nn.ConvTranspose1d(16, 1, 8, stride=2, padding=3)) # 32 → 128

def forward(self, x):
return self.decoder(self.encoder(x))

torch.manual_seed(0)
model = DenoisingAE()
opt = torch.optim.Adam(model.parameters(), lr=2e-3)
for step in range(2000):
x = clean_signals(64)
x_noisy = x + 0.3 * torch.randn_like(x) # 加噪
x_noisy = x_noisy * (torch.rand_like(x) > 0.1).float() # 再随机丢掉 10% 的采样点
loss = nn.functional.mse_loss(model(x_noisy), x) # 目标是干净信号
opt.zero_grad(); loss.backward(); opt.step()

with torch.no_grad():
x = clean_signals(500)
x_noisy = x + 0.3 * torch.randn_like(x)
print(f"去噪前 MSE {nn.functional.mse_loss(x_noisy, x):.4f},去噪后 MSE {nn.functional.mse_loss(model(x_noisy), x):.4f}")

典型例子

  • 图像去噪、语音增强、医学影像去伪影
  • 2010 年前后的堆叠去噪自编码器(逐层预训练)
  • 现代后继者:BERT、MAE(掩码重建)与扩散模型(多噪声等级的去噪)
  • 优势:学到对噪声和缺失鲁棒的特征;不需要窄瓶颈也不会学成恒等映射;思想直接延伸到掩码预训练和扩散模型
  • 局限:训练时的腐蚀方式要接近真实的腐蚀,否则泛化差;本节这种只在一个噪声等级上训练的确定性去噪器没有现成的采样流程,不能直接套用 DDPM 那样的多步采样;把腐蚀和去噪交替当成马尔可夫链来采样的生成式 DAE(Bengio 2013)是另一条路
  • 适合的数据:带噪或有缺失的信号和图像:传感器读数、音频、医学影像;作为自监督预训练的目标